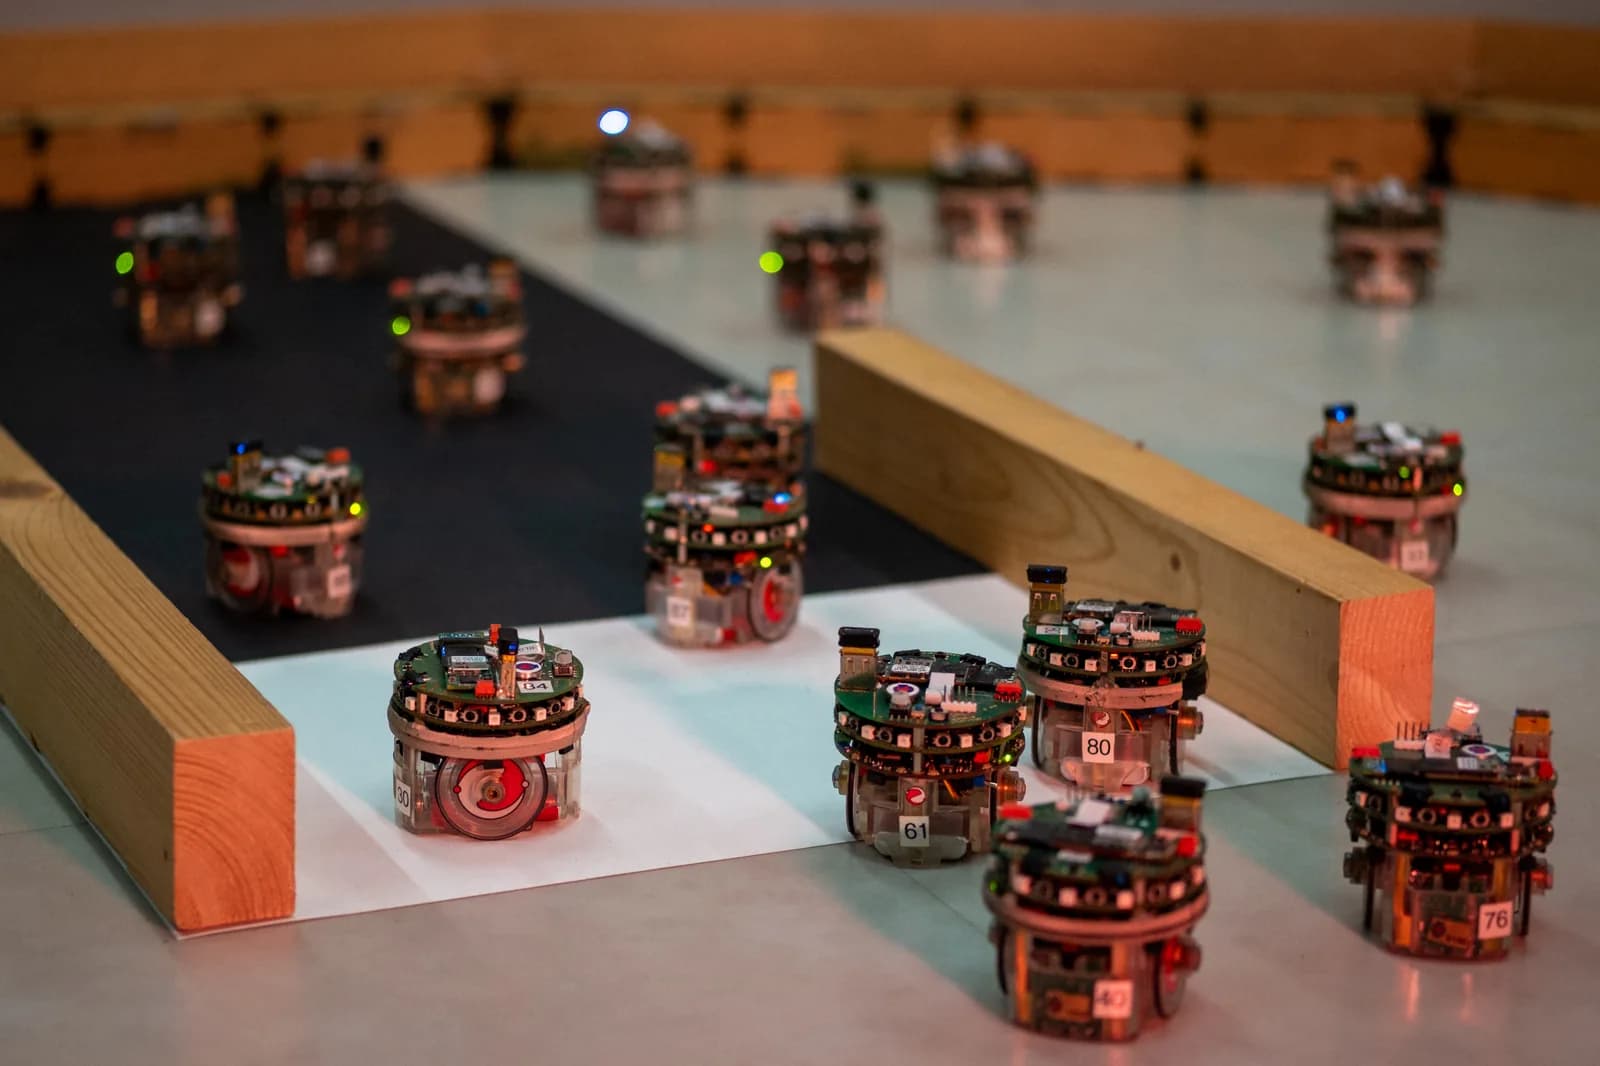
El aprendizaje por refuerzo permite que un robot aprenda conductas por su cuenta, a prueba y error, casi siempre dentro de una simulación. Llevar lo aprendido a un robot físico es otro asunto. Los robots simulados y los reales nunca se comportan igual, un desajuste que se conoce como "brecha de realidad" (reality gap), y el aprendizaje por refuerzo ha sido especialmente sensible a ella. Investigadores de IRIDIA, el laboratorio de inteligencia artificial de la Universidad Libre de Bruselas (ULB), mostraron cómo esquivarla en enjambres de robots. Los enjambres entrenados con su método en simulación siguen funcionando de forma confiable cuando pasan a robots reales.
Enseñarle a un enjambre a buscar sobrevivientes después de un terremoto, o a explorar un lugar hostil, completamente dentro de un computador antes de arriesgar una máquina real parece lo sensato. El problema es la brecha de realidad. La fricción, el ruido de los sensores y la imprecisión mecánica rara vez se comportan como en la simulación, y las habilidades aprendidas ahí tienden a desarmarse cuando el robot enfrenta el mundo real.
Ilyes Gharbi, Mauro Birattari y sus colegas de IRIDIA (Brussels School of Engineering, ULB) publicaron sus resultados en Science Robotics.
Dos tradiciones que no se habían cruzado
El aprendizaje por refuerzo se volvió una de las herramientas más poderosas de la robótica para generar conductas complejas de forma automática. Está detrás de varios de los avances recientes más llamativos en locomoción con patas y en manipulación robótica.
La robótica de enjambre siguió otro camino. Su propia tradición de métodos de diseño modular arma las conductas de los robots con bloques predefinidos. Esos métodos se transfieren bien a robots reales, pero dependen de procedimientos de búsqueda lentos y costosos. Las dos líneas de investigación casi nunca se habían comparado sobre una base experimental sólida.
¿Cómo funciona el método de IRIDIA?
La idea de los investigadores fue dar a los robots menos libertad a cambio de más confiabilidad. En vez de dejar que el algoritmo de aprendizaje fije directamente la velocidad de cada rueda, lo hicieron elegir, momento a momento, entre un puñado de conductas ya probadas, como avanzar hacia una luz, agruparse con sus pares o explorar.
Esa restricción impide que los robots aprendan a aprovechar rarezas del simulador que no existen en la realidad. Lo que queda por aprender es la parte que importa, cuándo cambiar de una conducta a otra para que el grupo trabaje en conjunto.
"Durante años hemos sostenido que la brecha de realidad es, en el fondo, un problema de sobreajuste: un método de diseño demasiado flexible aprende el simulador en vez de la tarea", dijo Mauro Birattari, quien dirigió la investigación. "El aprendizaje por refuerzo es muy bueno para encontrar lo que sea que funcione en simulación, incluidos trucos que solo funcionan ahí. Al limitar lo que los robots pueden aprender, le dejamos al algoritmo solo las decisiones que siguen teniendo sentido en un robot real".
¿Qué mostraron los experimentos?
El equipo probó el enfoque con un enjambre de 20 robots e-puck en cinco misiones colectivas distintas, con 250 experimentos en total sobre los robots físicos. Los enjambres entrenados así se transfirieron a la realidad de forma confiable.
Superaron por amplio margen a un método de punta en el que el algoritmo controla directamente los motores de los robots, que tuvo problemas apenas salió del simulador. Los investigadores también encontraron que las políticas más simples y restringidas se transfirieron mejor que las más grandes y flexibles. Eso va contra una intuición extendida en inteligencia artificial, la de que los modelos más grandes y flexibles suelen ser mejores.
"Lo que me entusiasma es que esto convierte al aprendizaje por refuerzo en una herramienta práctica para la robótica de enjambre", dijo Ilyes Gharbi, primer autor del estudio. "Diseñar conductas colectivas a mano les toma mucho tiempo a los expertos. Con este enfoque, un enjambre puede entrenarse en simulación para una misión nueva y desplegarse en robots reales con la confianza de que se comportará como se espera. El siguiente paso es probarlo en enjambres más grandes, en otras plataformas de robots y en entornos menos controlados".
El estudio junta dos tradiciones de investigación que se habían desarrollado casi por separado, la eficiencia del aprendizaje por refuerzo y la confiabilidad de los métodos modulares de la robótica de enjambre. Ambas serán necesarias antes de que se pueda confiar en grupos de robots autónomos para tareas como búsqueda y rescate, monitoreo ambiental o exploración de lugares demasiado peligrosos para las personas.
La investigación contó con financiamiento parcial del Fonds de la Recherche Scientifique (FNRS) de Bélgica, a través del proyecto PDR "Reinforcement Learning for Robot Swarms".
Publicación. I. Gharbi, M. Kegeleirs, G. Legarda Herranz, J. Szpirer, K. Hasselmann, M. Birattari, "Structural bias enables reliable sim-to-real transfer in reinforcement learning for robot swarms", Science Robotics (2026).