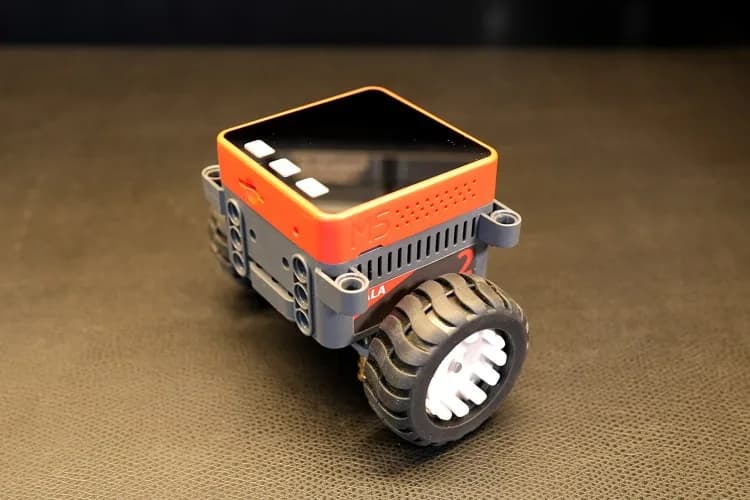
El *aprendizaje por refuerzo* (RL, por reinforcement learning) es una rama de la inteligencia artificial que ha avanzado mucho en tareas complejas. Consiste en entrenar a un *agente* para que cumpla una tarea por ensayo y error. El agente es un programa que observa su entorno y decide qué acción tomar a continuación. La regla que usa para decidir se llama *política* (policy).
El agente también puede recibir una *recompensa* del entorno, como los puntos en un videojuego, ganar una partida de ajedrez o que un robot dé un paso sin caerse. Esa recompensa suele ser un valor numérico, y el agente la usa para mejorar su política. Con el tiempo y con muchas interacciones con el entorno, el agente mejora su capacidad de hacer la tarea que le encargó el programador.
Siempre habrá espacio para los esquemas de control clásicos, como un lazo proporcional, integral y derivativo (PID), un regulador cuadrático lineal (LQR) o el control predictivo por modelo (MPC). Aun así, el RL gana terreno en el mundo de los robots. Configurarlo, entrenar un agente y llevarlo a un robot real puede ser complicado, pero produce controladores que toleran muy bien las variaciones del entorno. En vez de tratar de codificar matemáticamente cada estado o escenario posible, se entrena un agente de RL para que maneje una gran variedad de escenarios, y después el robot debería poder enfrentar situaciones parecidas.
La guía de Make parte con una revisión conceptual del aprendizaje por refuerzo y después muestra cómo entrenar un robot balancín propio con *optimización de política proximal* (PPO, por proximal policy optimization), un algoritmo muy popular. Equilibrar un robot de dos ruedas es un problema que el control clásico resolvió hace tiempo, así que el ejercicio sirve como introducción a los conceptos de RL y muestra cómo entrenar un agente, algo que debería tomar solo unas horas. Sirve para entender cómo funcionan el entrenamiento y el despliegue antes de pasar a robots más complejos, como el nuevo bípedo Microduck de Pollen Robotics y Hugging Face.
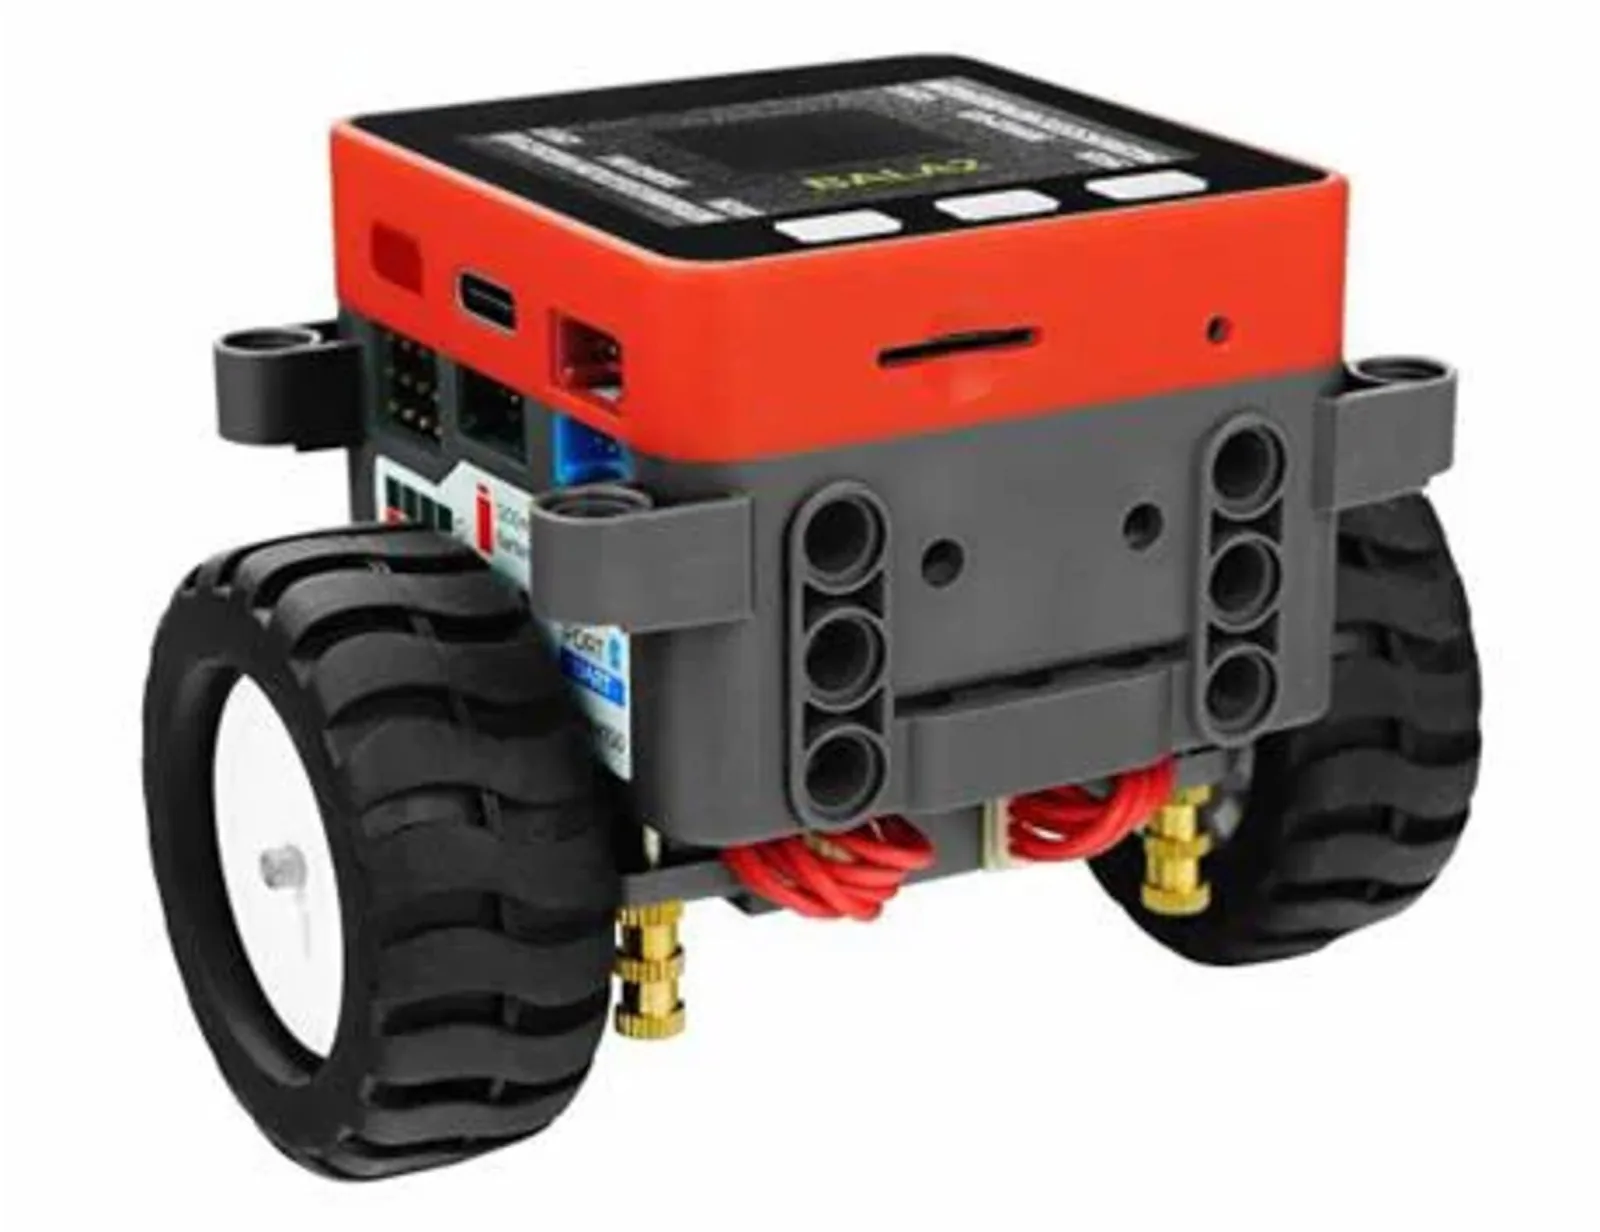
Casi todo el tutorial se puede hacer solo con un computador, porque la mayor parte del entrenamiento se simula. Para llevarlo a hardware real hay que comprar un kit de robot autoequilibrado M5Stack Bala2-Fire.
Breve historia del aprendizaje por refuerzo
El aprendizaje por refuerzo se remonta a los años cincuenta, con la investigación de Richard Bellman sobre programación dinámica, el trabajo de Marvin Minsky sobre aprendizaje computacional por ensayo y error y el famoso programa de damas de Arthur Samuel. Gran parte de ese trabajo temprano se inspiró en la investigación sobre aprendizaje animal, en especial la ley del efecto de Thorndike y el condicionamiento operante de B.F. Skinner.
En las décadas siguientes, la mayor parte de la investigación en RL se concentró en algoritmos que aprenden de la experiencia y no de un modelo matemático completo del entorno. La programación dinámica de Bellman funciona bien cuando se sabe con exactitud cómo se comporta el mundo y la cantidad de situaciones posibles es manejable, pero eso casi nunca ocurre. Incluso los juegos con reglas bien definidas pueden tener demasiadas posiciones para calcularlas con exactitud. En 1992, Gerald Tesauro, de IBM, combinó el aprendizaje por diferencias temporales con una red neuronal para crear TD-Gammon, que aprendió solo a jugar backgammon jugando contra sí mismo y llegó a un nivel cercano al del campeón mundial. El mundo real es todavía más difícil. A diferencia de un juego de tablero, mover un brazo robótico en el espacio implica lidiar con muchísima variabilidad, como el ruido de los sensores, el juego mecánico de los motores o alguien que choca con el brazo.
La revolución del aprendizaje profundo, que partió a comienzos de la década de 2010, también marcó un punto de inflexión para el RL y abrió la era del aprendizaje por refuerzo profundo. En el RL profundo, las redes neuronales pueden estimar cuánta recompensa futura esperar de una situación dada, pueden representar la política misma, o pueden hacer las dos cosas. Eso trajo una serie de éxitos rápidos. La mayor parte de la literatura ubica en 2013 el punto de quiebre de esta revolución, cuando DQN, de DeepMind, aprendió a jugar decenas de juegos de Atari examinando los píxeles de la pantalla.
En 2016, AlphaGo, de DeepMind, le ganó a Lee Sedol, uno de los mejores jugadores de Go del mundo, en una serie de cinco partidas que sorprendió a la comunidad de IA. En 2019, OpenAI Five, otro programa de RL, derrotó al equipo profesional de deportes electrónicos OG en el videojuego Dota 2. Desde entonces, el RL profundo se extendió mucho más allá de los juegos. Se usa para afinar modelos de lenguaje como ChatGPT y Claude, y está impulsando avances rápidos en robótica.
En robótica, en 2024 Boston Dynamics anunció que había integrado RL en el controlador de locomoción de Spot, junto al MPC clásico que usaba hace años. Ese mismo año, Disney Research publicó un artículo sobre sus droides BDX, que usan RL para ejecutar movimientos expresivos diseñados por animadores y que les dan una personalidad realista.
El ciclo de entrenamiento
El aprendizaje por refuerzo consiste en un ciclo de aprendizaje bastante simple. El agente es la parte del código que toma las decisiones. Otras partes del código leen los sensores, miran los píxeles, etc., y le entregan una *observación* al agente. El agente revisa la información de esa observación y elige una *acción* como salida.
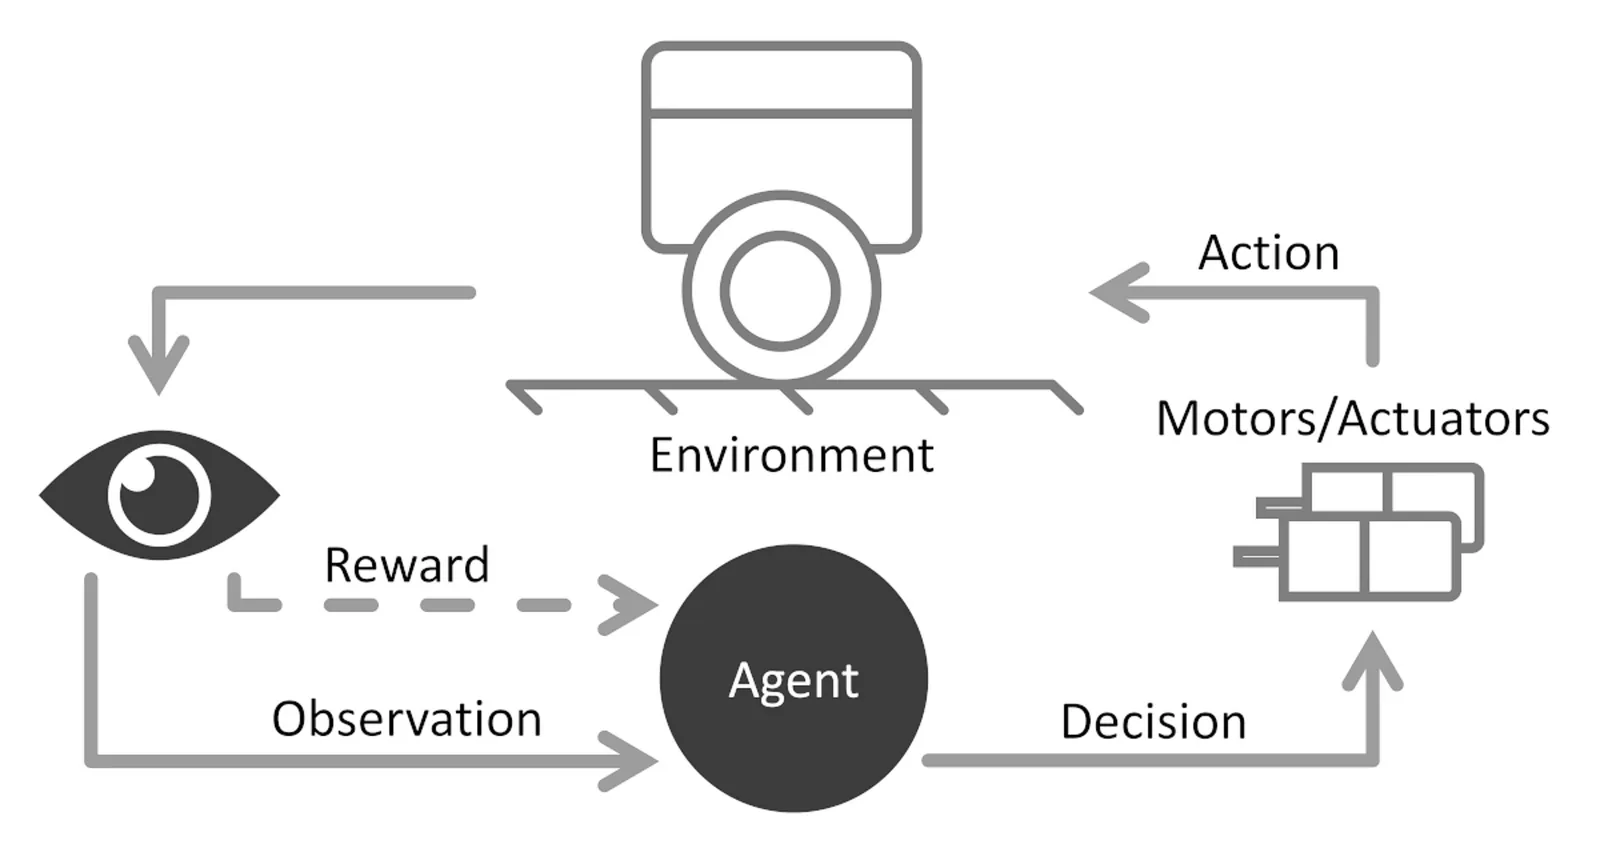
La salida del agente se usa para mover lo que sea que queramos lograr. Pueden ser los controles del personaje de un videojuego, una recomendación de película, la decisión de comprar o vender una acción o, en este caso, la velocidad y el sentido de cada motor del robot balancín.
El agente se refiere a un trozo de código muy específico, formado por la política que toma las decisiones, el estimador de valor (si se usa uno) y el algoritmo de aprendizaje que los actualiza. Todo lo demás se considera el *entorno*. Eso incluye el código de apoyo que lee los sensores y calcula las recompensas, los motores, la electrónica, el chasis del robot y el resto del mundo.
Después de que se ejecuta una acción, el entorno reacciona de alguna forma. En este robot, los motores hacen girar las ruedas, lo que inclina el robot hacia algún lado y puede moverlo hacia adelante o hacia atrás. Luego el código de apoyo lee datos nuevos de los sensores, que en este ejemplo son una unidad de medición inercial (IMU) y dos encoders de motor. Esas mediciones pasan a ser la siguiente observación que recibe el agente.
Durante el aprendizaje también se entrega una recompensa que describe cómo reaccionó el entorno a la decisión anterior del agente. Para este robot, la guía arma una sola recompensa numérica a partir de estos componentes:
- Vivo: en cada paso de tiempo en que el robot no se ha caído, se da una recompensa constante.
- Inclinación: se penaliza al robot (recompensa negativa) en proporción a los grados que se aleja de la vertical.
- Acción: se penaliza al robot por hacer cambios bruscos en las órdenes a los motores, lo que lo empuja a hacer ajustes pequeños para mantenerse de pie.
- Posición: se penaliza al robot por alejarse del origen.
- Velocidad de guiñada: se penaliza al robot por girar sobre su eje vertical (Z), porque se busca que se quede en su lugar sin girar.
El algoritmo de aprendizaje (en este ejemplo, PPO) usa las recompensas para actualizar de forma automática el funcionamiento interno del agente, de modo que en el futuro tome las acciones que maximicen la recompensa total que acumula en el tiempo.
Cuando el desempeño del agente es satisfactorio, se puede desplegar en el robot (o en la simulación del robot). Normalmente se despliega solo la parte del agente que corresponde a la política, a la que en RL profundo se suele llamar *actor. El estimador de valor de PPO, conocido como crítico*, ayuda al algoritmo durante el entrenamiento, pero el robot no lo necesita para decidir después. Además, el código de despliegue puede eliminar la señal de recompensa, porque ahora el agente solo tiene que recibir una observación y tomar una decisión.
En este caso, el aprendizaje se hace en un entorno simulado. Así es fácil reiniciar el robot si se cae, correr el motor de física más rápido que en la vida real y ejecutar varios entornos en paralelo para acelerar el proceso. Al desplegar el agente hay que cuidar especialmente que los valores de observación coincidan con los que vio en la simulación. Cualquier filtrado, normalización o conversión de unidades aplicada en la simulación también tiene que aplicarse en el robot real. Por ejemplo, si en la simulación la aceleración se usó en m/s² y los sensores reales la entregan en fuerza g, hay que convertirla a m/s² antes de pasársela al agente.
Las políticas además suelen diseñarse para entregar acciones normalizadas, que en este caso son un valor de control de motor entre , 1 y 1. En la simulación, ese valor se traduce en una orden continua que va desde "máxima potencia hacia atrás" hasta "máxima potencia hacia adelante". En el robot real, ese mismo valor se escala a una señal PWM para el driver del motor. Por ejemplo, si la política entrega, 0,73 para el motor izquierdo y el valor PWM máximo es 255, el driver se pone en reversa y se le envía un PWM de 186. También es buena práctica recortar la salida de la política al rango de, 1 a 1 antes de escalarla, porque los valores crudos a veces se salen de ese rango. Sea cual sea el mapeo, el objetivo es que la simulación y la realidad sean coherentes. Una salida de 1,0 tiene que significar lo mismo para los motores reales que para los simulados.
Optimización de política proximal
El RL tiene decenas de algoritmos útiles desarrollados a lo largo de los años, y elegir el correcto puede ser un arte en sí mismo. Para esta demostración se usa PPO, descrito en un artículo académico de 2017 escrito por investigadores de OpenAI. Hoy sigue siendo uno de los algoritmos de RL más populares para controlar robots y afinar modelos de lenguaje. La guía no entra en los detalles finos de PPO, porque hay mucha matemática detrás, pero sí repasa lo básico.
Mientras hacía su doctorado en la Universidad Drexel, Costa Huang creó implementaciones de referencia de varios algoritmos de RL, guardadas en github.com/vwxyzjn/cleanrl. La guía usa una versión modificada de su código ppo_continuous_action.py, que conviene revisar mientras se explica cómo funciona PPO.
PPO es un método de tipo *actor-crítico* que usa dos redes neuronales separadas dentro del agente.
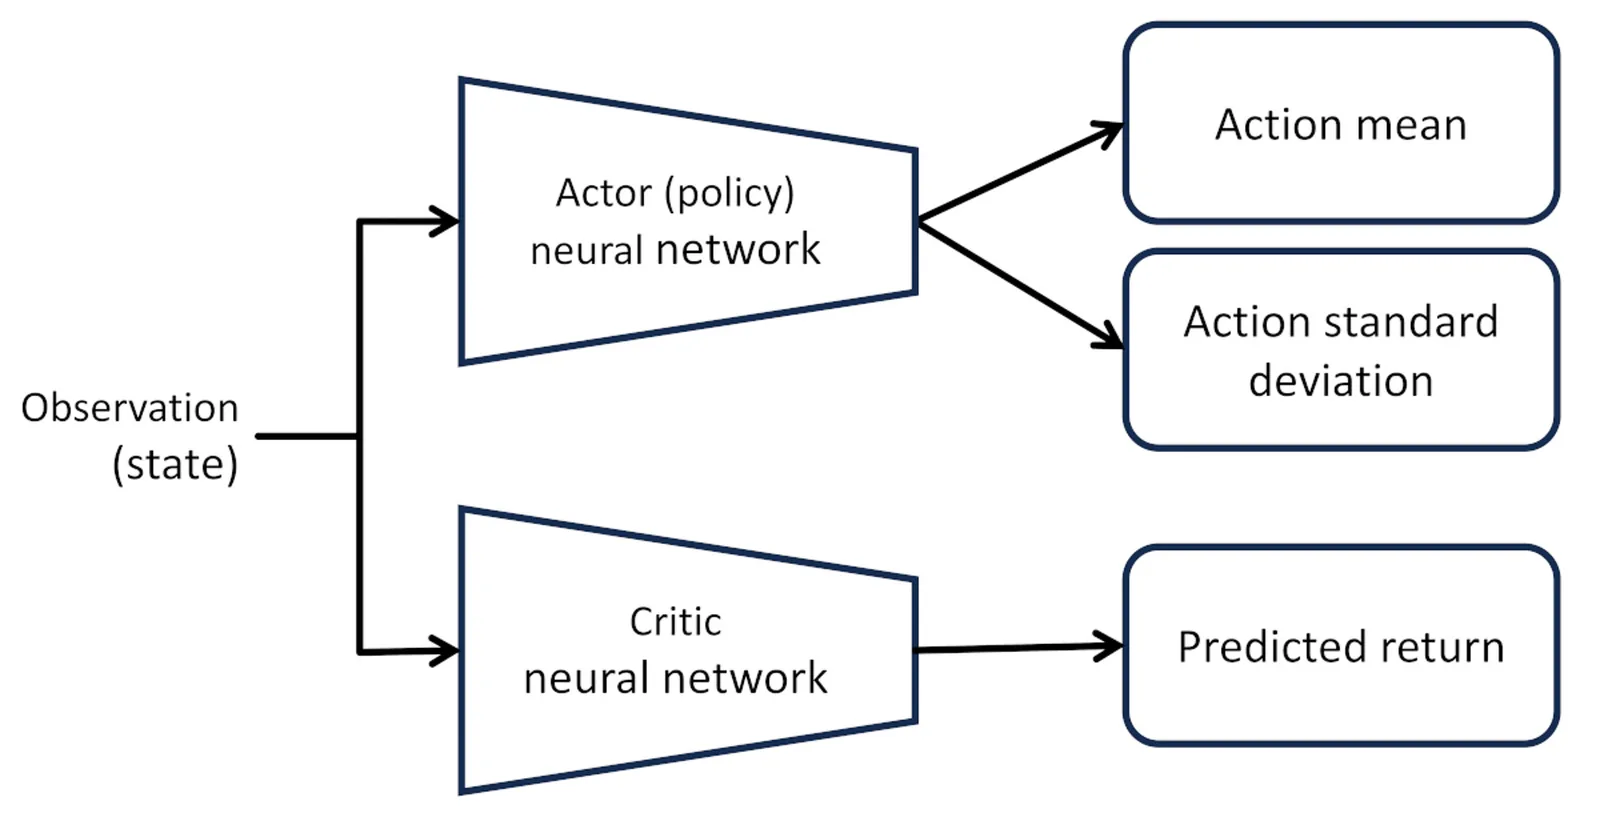
El crítico es una red neuronal que recibe la observación, la cual representa el *estado* del entorno. Una observación puede capturar el estado completo o solo una parte. Los sensores de este robot, por ejemplo, no pueden saber si una rueda está patinando. La observación es un conjunto de valores de las lecturas de los sensores (u otra entrada del entorno, como los píxeles de una imagen). El propósito del crítico es intentar responder la pregunta "¿qué tan bueno es este estado?".
En casos complejos como este robot no se sabe con exactitud cómo responderá el entorno a cada acción. Aunque se entienda la física de un robot balancín, el ruido de los sensores y las variaciones de los motores agregan un azar que es imposible modelar con exactitud. Por eso, en vez de tratar de modelar el entorno, se hace que el crítico aprenda algo más simple, una estimación de la recompensa total que se puede esperar desde un estado en particular.