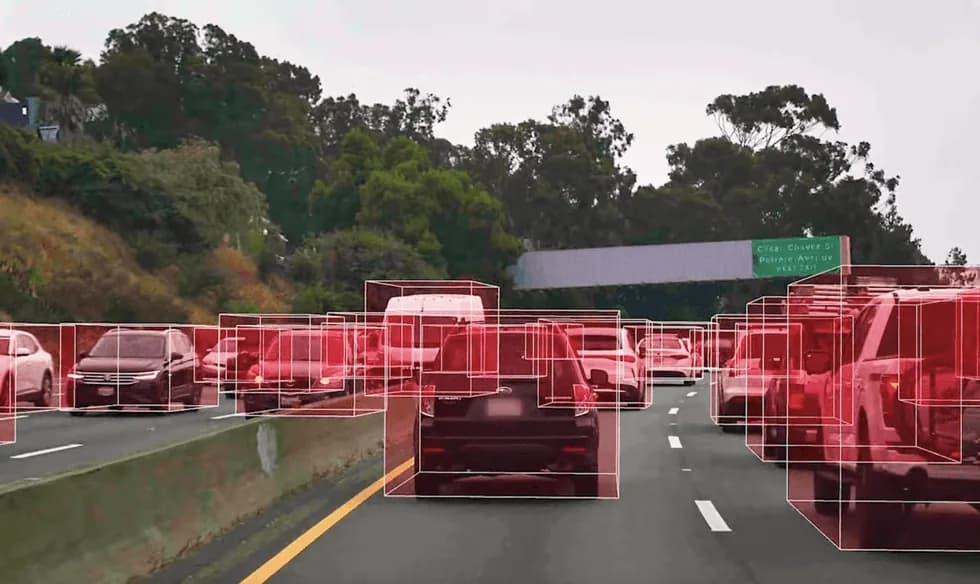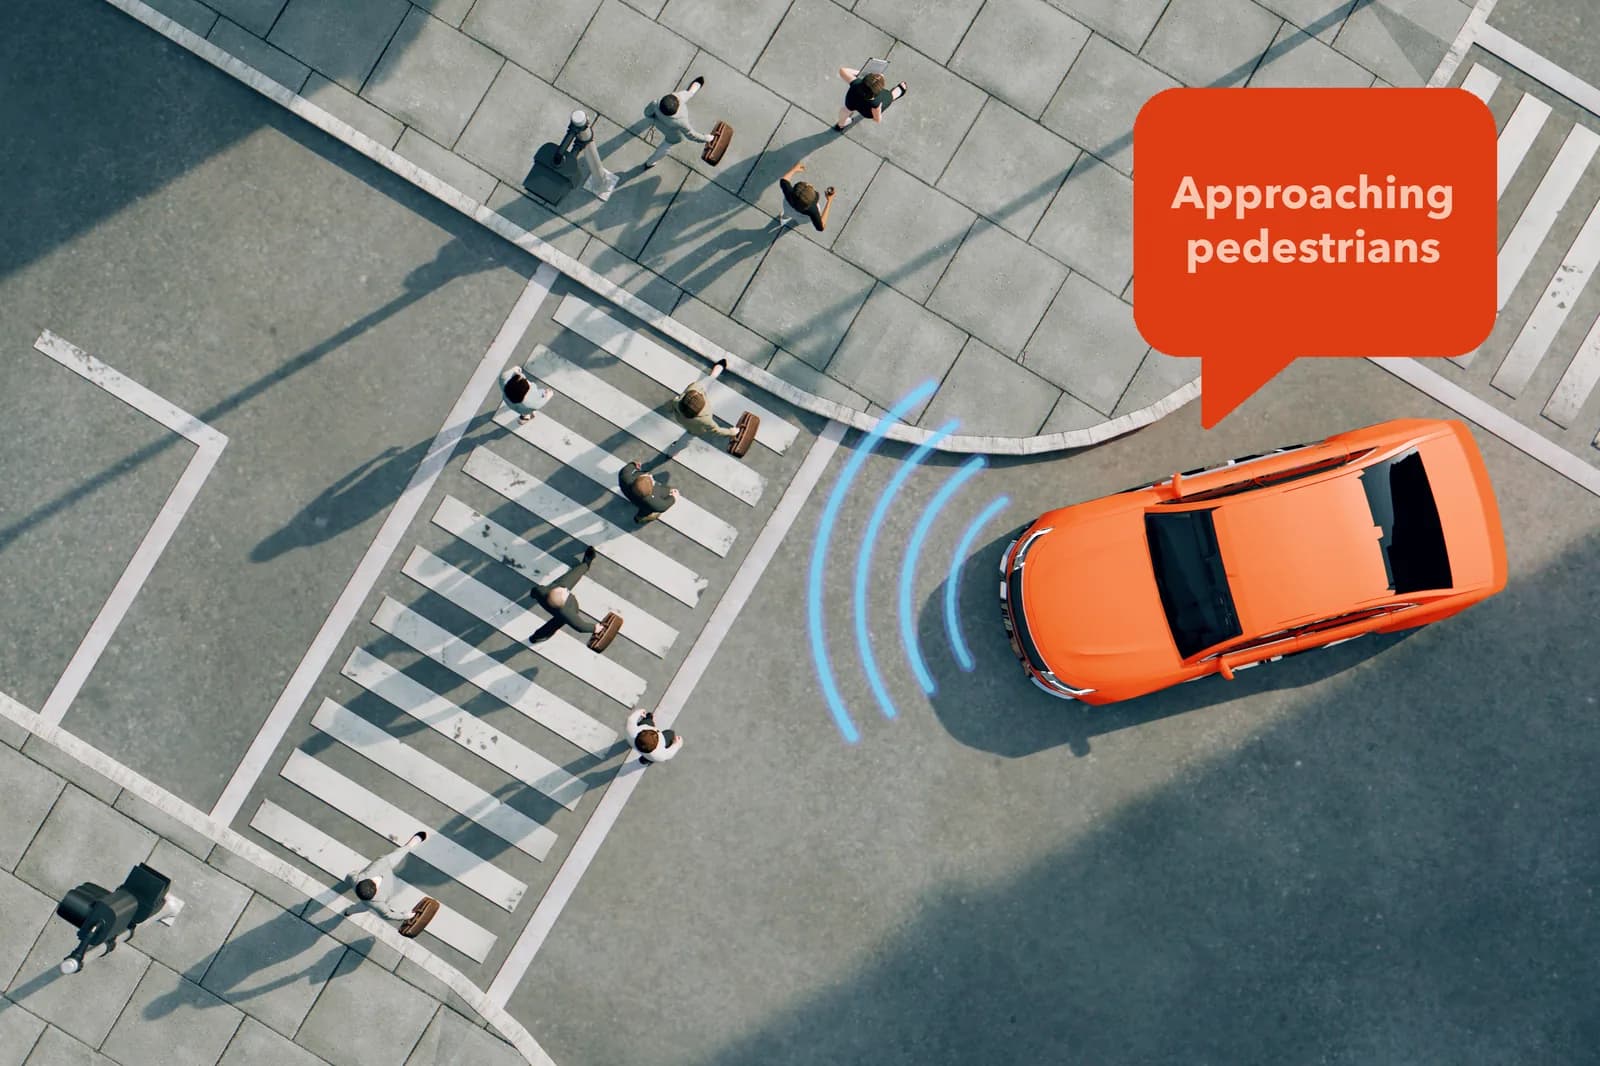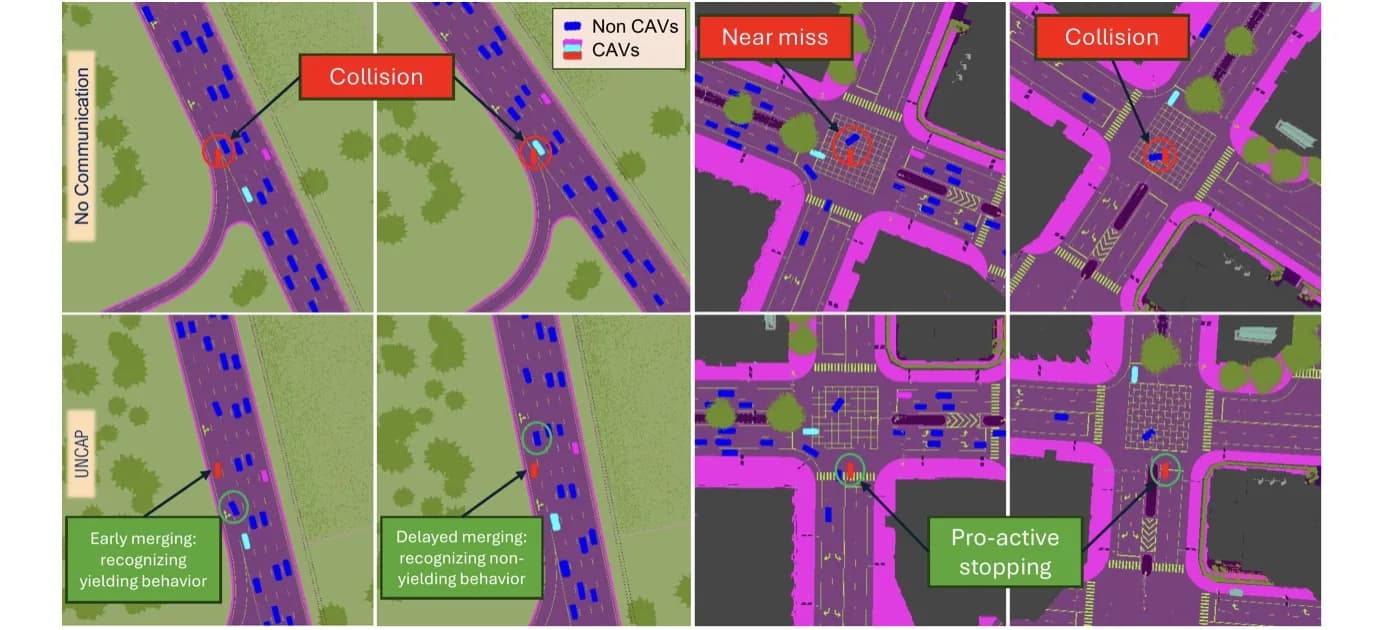
Un auto se acerca a una intersección. Un camión estacionado en la esquina le tapa la vista de otro vehículo que viene rápido por la derecha. El conductor no lo puede ver, pero el auto del lado sí. ¿Y si ese vehículo vecino simplemente le avisara a su auto?
"Vehículo incorporándose por la derecha, a unos 15 metros, a alta velocidad."
Con ese mensaje, el auto sabe algo que sus propios sensores nunca habrían captado.
Esa idea, autos que se ayudan describiendo en lenguaje natural lo que ven, es la base de UNCAP, un sistema de conducción autónoma cooperativa que sus autores presentaron en Robohub el 14 de octubre de 2026. El punto clave es que no todo vehículo vecino vale la pena de escuchar, y no todo mensaje merece la misma confianza.
UNCAP les enseña a los vehículos autónomos con quién hablar y cuánto creerle a lo que escuchan.
¿Por qué hablar con lenguaje en vez de compartir datos de sensores?
Hace tiempo que los investigadores imaginan flotas de vehículos autónomos que cooperan para hacer más segura la conducción. Las esquinas ciegas, las oclusiones y los peatones ocultos serían mucho menos peligrosos si los autos cercanos compartieran lo que observan.
El enfoque tradicional es directo. Los autos intercambian datos crudos de sensores, como imágenes de cámara, nubes de puntos de LiDAR o mediciones de radar. Eso se vuelve poco práctico a escala por varias razones. Los flujos de datos crudos consumen un ancho de banda enorme, exigen mucho cómputo para procesarlos y suponen que todos los vehículos tienen hardware de sensado comparable.
En la realidad, con el avance de la conducción autónoma, por las calles circula una mezcla de fabricantes, configuraciones de sensores y pilas de software distintas.
El lenguaje natural es una alternativa a compartir datos de sensores. En vez de transmitir megabytes de imágenes, un vehículo podría decir "peatón cruzando detrás del bus" o "motocicleta acercándose por la izquierda, a alta velocidad". Esos mensajes son diminutos, no dependen del hardware y los modelos de visión y lenguaje actuales los entienden de inmediato.
El lenguaje trae otro problema. En una intersección congestionada, un vehículo puede tener diez o veinte vecinos. ¿Debe escucharlos a todos? Y si dos vehículos se contradicen, ¿a cuál le cree? UNCAP apunta a responder esas preguntas.
¿Cómo funciona UNCAP?
UNCAP funciona por completo en modo *zero-shot*. No entrena un modelo nuevo, algo que consume muchos recursos. Sigue una estrategia de "trae tu propio modelo", se apoya en modelos de visión y lenguaje existentes y les agrega una estrategia de comunicación para que los vehículos cooperen. El sistema tiene cuatro etapas.
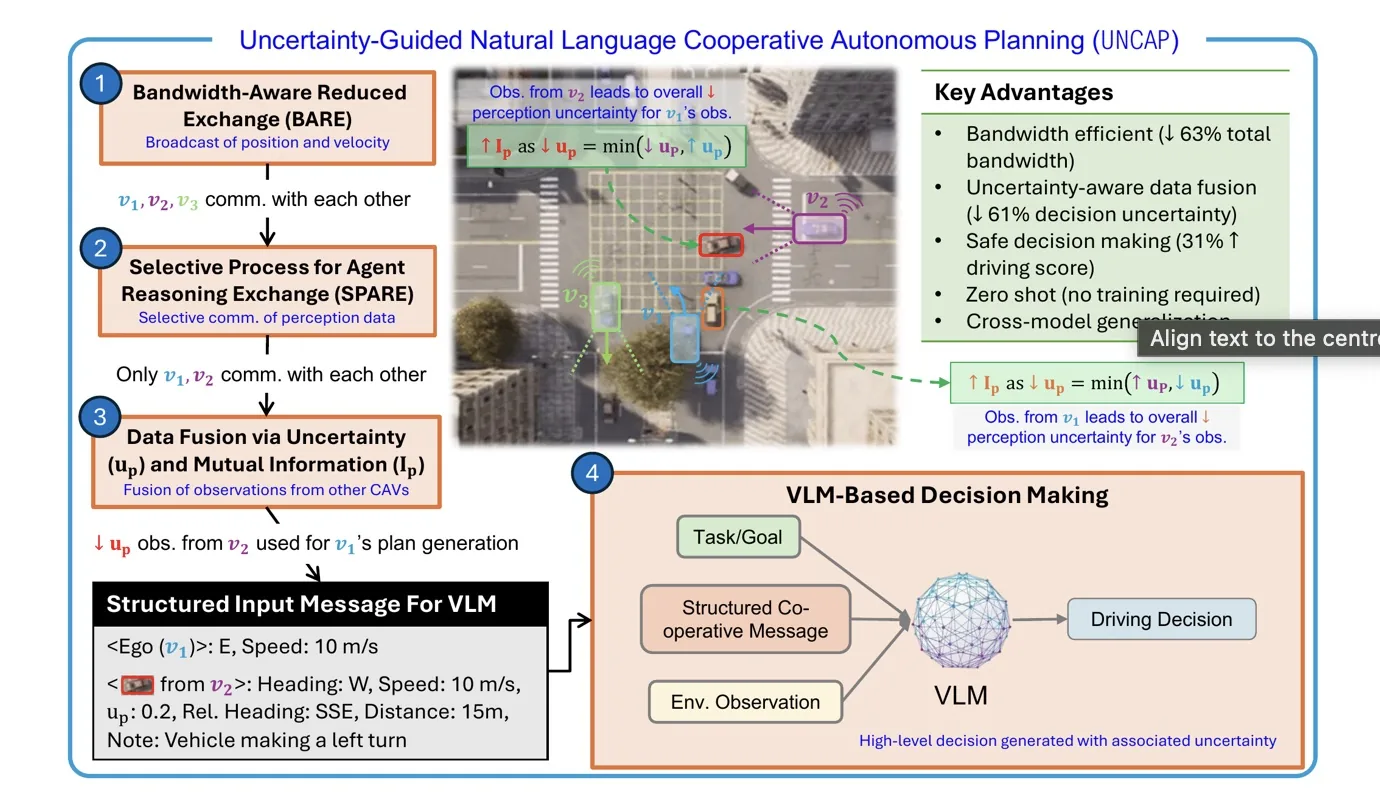
UNCAP ayuda a cada vehículo a decidir qué vecinos importan. Los mensajes describen vehículos cercanos, movimiento y nivel de confianza, y UNCAP los combina antes de tomar una decisión de conducción.
1. Descubrir los vehículos cercanos
Cada vehículo emite cada cierto tiempo un pequeño "latido" de información con solo su posición y su dirección de avance. Ese latido ocupa apenas unos pocos bytes. Basta para que los vehículos cercanos sepan quién anda alrededor.
2. Decidir quién importa
En la calle, la mayoría de los vehículos cercanos no aporta nada. Un auto que se aleja de la intersección entrega poca información útil, mientras que uno que se acerca al mismo cruce puede tener justo la observación que hace falta. UNCAP razona sobre qué vecinos están lo bastante cerca y tienen probabilidad de afectar la trayectoria futura del vehículo.
Ese filtro reduce mucho el ancho de banda que se gasta en comunicación innecesaria y el cómputo que necesitan las etapas siguientes. Gracias a eso UNCAP escala a grupos grandes de vehículos.
3. Intercambiar observaciones y evaluar la confianza
Los vehículos relevantes describen lo que ven en lenguaje natural, junto con estimaciones de confianza calibradas. UNCAP usa predicción conforme, un método de calibración liviano que hace que los valores de confianza reflejen la fiabilidad real de la información recibida.
Cada vehículo evalúa luego si un mensaje entrante de verdad reduce su incertidumbre sobre la escena. Para eso, UNCAP mide la información mutua que aporta cada observación. Así el vehículo le da más peso a los mensajes que aclaran la escena y descuenta las observaciones que no informan o que pueden confundir. En vez de tratar igual a todos los vecinos, cada vehículo arma una comprensión del entorno que toma en cuenta la incertidumbre.
4. Tomar una decisión de conducción
Al final, la descripción de la escena que sale de razonar sobre todos los mensajes se le entrega a un modelo de visión y lenguaje comercial. Ese modelo produce una decisión de conducción, como incorporarse, esperar o ceder el paso, con su puntaje de confianza.
¿Qué resultados obtuvo?
Los autores evaluaron UNCAP en el simulador de conducción CARLA con el benchmark OPV2V, muy usado por los investigadores de conducción autónoma. OPV2V incluye incorporaciones en autopista, intersecciones urbanas y otros escenarios donde los vehículos sufren oclusiones con frecuencia.
UNCAP se comparó con vehículos que no se comunican y con enfoques anteriores basados en lenguaje que transmiten cada observación a todos los demás autos. En los distintos escenarios mejoró la eficiencia y la seguridad de forma consistente.
- 63% menos ancho de banda de comunicación
- 31% más de puntaje de conducción
- 61% menos incertidumbre en las decisiones
- márgenes de seguridad 4 veces mayores en situaciones de casi choque
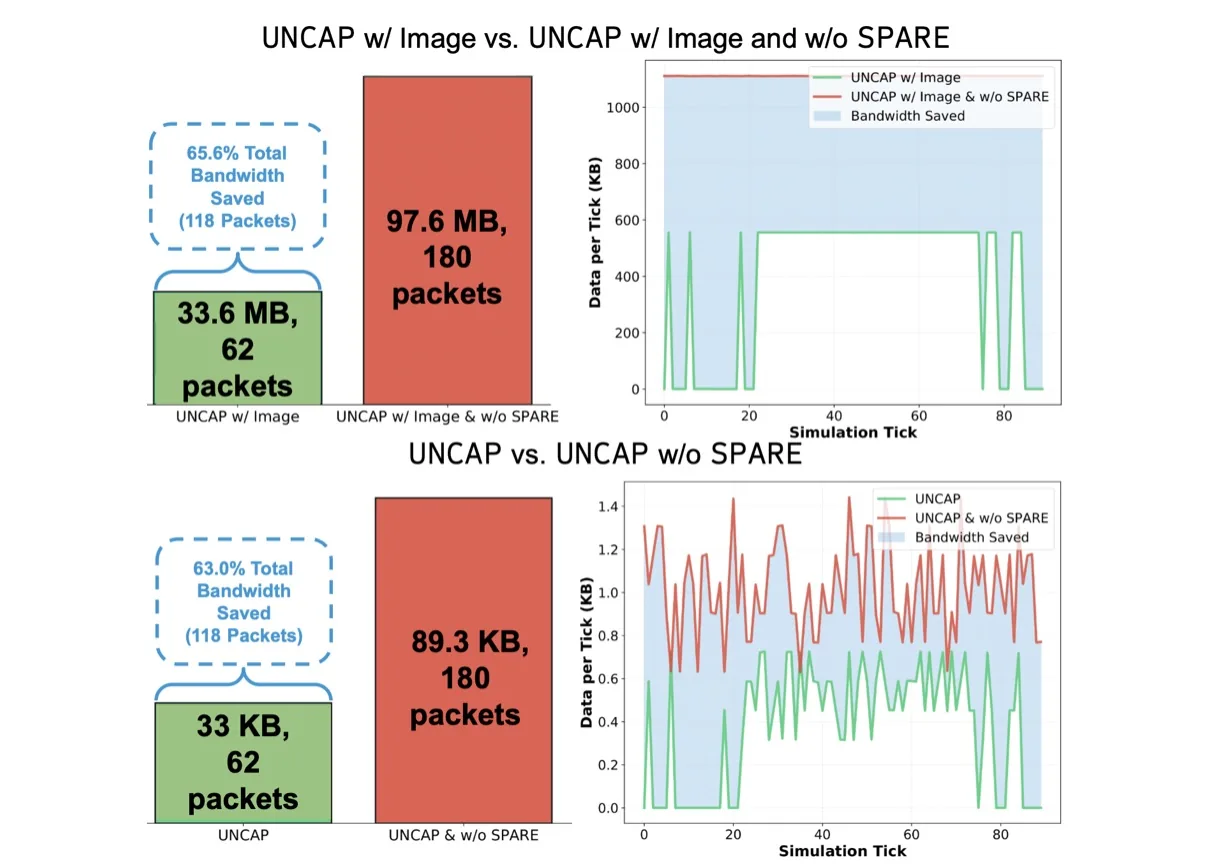
UNCAP evita transmitir cada observación a todos los vehículos cercanos. Reduce mucho el ancho de banda y conserva la información necesaria para decidir.
El resultado que más sorprendió a los autores fue que compartir imágenes crudas funcionó peor que compartir lenguaje.
Según ellos, los modelos de visión y lenguaje actuales tienen problemas para razonar en conjunto sobre varias cámaras capturadas desde puntos de vista distintos. Traducir primero esas observaciones a descripciones breves en lenguaje natural parece funcionar como una forma de razonamiento estructurado, que destila lo esencial antes de que llegue al modelo que decide.
Las mejoras se mantuvieron con varios modelos de visión y lenguaje, entre ellos GPT-4o, GPT-4.1, GPT-4o-mini y GPT-5. Para los autores, eso indica que el beneficio viene de la estrategia de comunicación y no de un modelo en particular.
Las limitaciones que reconocen los autores
La implementación actual tiene límites importantes. Los experimentos se hicieron solo en simulación, así que faltan por explorar las restricciones del mundo real, como sensores con ruido, comunicación inalámbrica poco fiable, retardos de red y pérdida de paquetes. Además, como consultar los modelos de visión y lenguaje actuales toma cerca de un segundo, las decisiones se toman en momentos clave y no de forma continua.
Los autores extienden la idea más allá de la conducción autónoma. A medida que los sistemas de IA operan en equipos, sean flotas de robots, drones o agentes de software, el desafío para ellos ya no es solo hacer más inteligente a cada agente. Es lograr que cada agente aprenda a comunicarse con eficiencia, a decidir qué información creer y a construir una comprensión compartida del mundo.
El artículo completo es UNCAP: Uncertainty-Guided Neurosymbolic Planning Using Natural Language Communication for Cooperative Autonomous Vehicles, de Neel P. Bhatt, Po-han Li, Kushagra Gupta, Rohan Siva, Daniel Milan, Alexander T. Hogue, Sandeep P. Chinchali, David Fridovich-Keil, Zhangyang Wang y Ufuk Topcu. El trabajo fue nominado al premio al mejor artículo de AAMAS 2026.