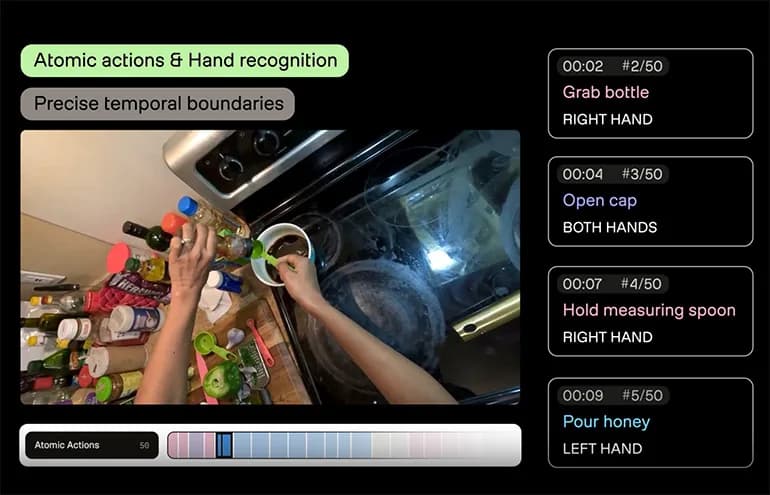
La empresa surcoreana TwelveLabs lanzó este martes Pegasus 1.6, una versión de su modelo de video con capacidades nuevas para entender y recorrer entornos reales complejos. Según la compañía, los equipos de IA juntan enormes cantidades de video complejo a medida que el mundo físico se digitaliza, pero convertir ese material en bruto en modelos útiles sigue siendo un problema difícil.
"Nuestra misión siempre ha sido ayudar a las máquinas a entender cómo funciona el mundo a través del video", afirmó Jae Lee, cofundador y CEO de TwelveLabs. "La IA física es la siguiente expresión de esa misión. La mayor parte de lo que las personas saben sobre hacer trabajo físico, como cambiar el agarre o recuperarse después de que algo se resbala, nunca se ha capturado en una forma de la que una máquina pueda aprender".
"Con nuestro nuevo modelo, ahora podemos convertir esas grabaciones en conocimiento estructurado y revisable, para que los equipos de robótica e IA física entrenen con experiencia humana real en vez de partir de cero", agregó.
TwelveLabs, fundada en 2021, dice haber creado una "plataforma integral de inteligencia de video" con sus modelos Marengo y Pegasus, diseñados para ver y entender video como lo hacen las personas, en una fracción del tiempo. Según la empresa, con sede en Seúl, los desarrolladores pueden usar este sistema único, que mejora con el tiempo, para acceder a todo su contenido de video y actuar sobre él.
Pegasus 1.6 se enfoca en el video egocéntrico
TwelveLabs dijo que esta versión de Pegasus marca su expansión hacia la IA física, con análisis detallados a partir de perspectivas del mundo real. Según la compañía, resuelve problemas propios de cada flujo de trabajo para que máquinas como robots, drones y vehículos autónomos puedan percibir, razonar y actuar con seguridad en el mundo físico.
"Nos enfocamos en la capa de comprensión de video", dijo Jae Lee a The Robot Report. "No puedes tomar millones de horas de video, meterlas en un modelo de robótica y esperar que salgan datos de entrenamiento útiles. Primero necesitas entender qué está pasando en el video, qué acción se está realizando, cuándo ocurre, con qué está interactuando la persona, cómo cambia el comportamiento en el tiempo y cuándo aparecen otras personas o transeúntes en el campo visual".
"Pegasus 1.6 entrega esa comprensión más precisa para que los equipos de robótica y de datos la conviertan en los datos de entrenamiento que necesitan", añadió.
Pegasus 1.6 es el primer modelo de la empresa construido para entender video egocéntrico, es decir, grabado desde el punto de vista de la persona que hace el trabajo. Puede ser alguien cocinando, ensamblando piezas en una línea de producción u operando un robot a distancia. Según Lee, el modelo no exige cámaras específicas.
"No les pedimos a los equipos de robótica que usen una cámara en particular ni hardware propietario para capturar esas grabaciones", dijo. "Lo que importa es poder capturar las acciones e interacciones que ocurren desde el punto de vista del operador".
Pegasus 1.6 además funciona con video que los equipos ya tienen, y permite analizar imágenes fijas.
"Una de las razones por las que nos enfocamos en el video egocéntrico es que es mucho más fácil de recolectar y escalar que los datos de teleoperación", reconoció Lee. "El objetivo es tomar esas grabaciones y hacerlas más útiles para los equipos de robótica, identificando las acciones que ocurren, dividiéndolas en segmentos de tiempo precisos y capturando detalles más finos del comportamiento".
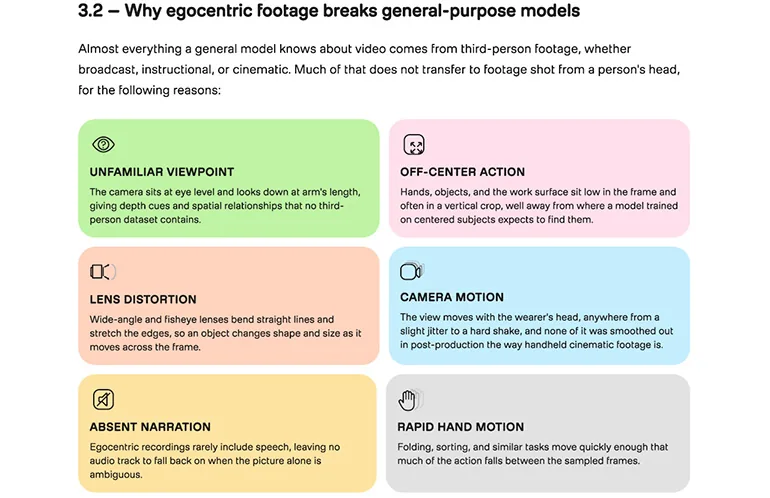
Las grabaciones con cámara montada en la cabeza pueden confundir a modelos entrenados con video de transmisiones, tutoriales y cine. Fuente: TwelveLabs.
¿Qué flujos de trabajo cubre?
Pegasus 1.6 admite por ahora cinco flujos de trabajo basados en su modelo nativo de video.
- Segmentación y etiquetado de acciones. Genera de forma automática etiquetas de acción con marca de tiempo para tareas, pasos, objetos e interacciones entre mano y objeto a partir de video en bruto, ajustadas a la taxonomía propia de cada cliente. Sirve para entrenar modelos con conjuntos de datos estandarizados.
- Etiquetado con descripciones densas. Produce descripciones detalladas en lenguaje natural de relaciones espaciales, contexto de la escena e interacciones mano y objeto, para entrenar políticas de robots condicionadas por lenguaje.
- Puntaje de calidad. Evalúa y califica los clips por claridad de la acción, encuadre y estabilidad antes de enviarlos a revisores humanos, para descartar el video de baja calidad.
- Búsqueda y curaduría. Encuentra eventos poco frecuentes, escenarios de cola larga y clips duplicados en todo un repositorio de video mediante búsquedas en lenguaje natural.
- Alertas de consentimiento y cumplimiento. Detecta y marca rostros, transeúntes y datos sensibles en pantalla o en papel antes de que el video entre a las etapas siguientes de desarrollo.
Lo que hereda de Pegasus 1.5
Pegasus 1.6 se apoya en las capacidades de comprensión de video que TwelveLabs desarrolló para empresas con grandes bibliotecas de video.
La nueva versión amplía funciones de Pegasus 1.5 que le trajeron varios clientes nuevos. TwelveLabs mencionó los metadatos basados en tiempo (TBM), que permiten definir un esquema propio y recibir de forma automática metadatos estructurados y con marca de tiempo a partir del video. Según la empresa, esto ayuda a entender el contexto, porque en los clips egocéntricos la gente suele narrar lo que está haciendo.
Pegasus 1.6 mejoró también el reconocimiento de entidades, con un seguimiento más consistente de manos, objetos y herramientas entre clips. Según TwelveLabs, el modelo procesa además más rápido y a menor costo los volúmenes altos de video.
Lee dijo que el sistema de TwelveLabs agrega comprensión de video a otras modalidades de sensores.
"Nos enfocamos en entender el comportamiento que podemos observar en el video", dijo. "Pegasus 1.6 puede identificar la acción que se está realizando, segmentarla con precisión en el tiempo, entender qué hacen la mano izquierda y la derecha, y cómo cambia el entorno".
"También podemos dar una comprensión aproximada de cómo se mueven las extremidades a partir del video, pero no intentamos reemplazar la sensórica táctil ni la de los actuadores del robot", agregó. "Nuestro papel es darles a los equipos de robótica una comprensión más rica del comportamiento en el video, que puedan combinar con los datos de sus propios sensores para construir trayectorias y políticas de aprendizaje más precisas".
TwelveLabs dijo que Pegasus 1.6 amplía sus colaboraciones con desarrolladores de robótica.
"Trabajamos con laboratorios de robótica y equipos de datos que usan video para ampliar los datos disponibles para entrenar robots", dijo Lee. "Gran parte del trabajo se centra en destreza y manipulación, tareas como empaque, ensamblaje y limpieza, además de aplicaciones industriales más especializadas como el control de calidad de semiconductores. El objetivo más amplio es ayudar a estos equipos a que cantidades mucho mayores de video de comportamiento humano sirvan para entrenar, algo mucho más escalable que los datos de teleoperación".