Apple desarrolla servidores de IA basados en sus propios procesadores de la serie M y está evaluando la tecnología NVLink Fusion para las interconexiones, según The Information. Las máquinas usarían procesadores M8 Ultra y llegarían en 2029, sostiene el reporte. Por ahora el uso de la plataforma NVLink Fusion no está formalizado y no lo confirmó ni Apple ni NVIDIA, pero si Apple se decide por ella en vez de las soluciones que compiten, el efecto en el mercado va bastante más allá de una compra de hardware.
¿Qué servidores está armando Apple?
Apple estaría considerando al menos dos configuraciones de servidor. Una máquina más chica equipada con dos procesadores M8 Ultra y una versión de gama alta con cuatro SoC M8 Ultra.
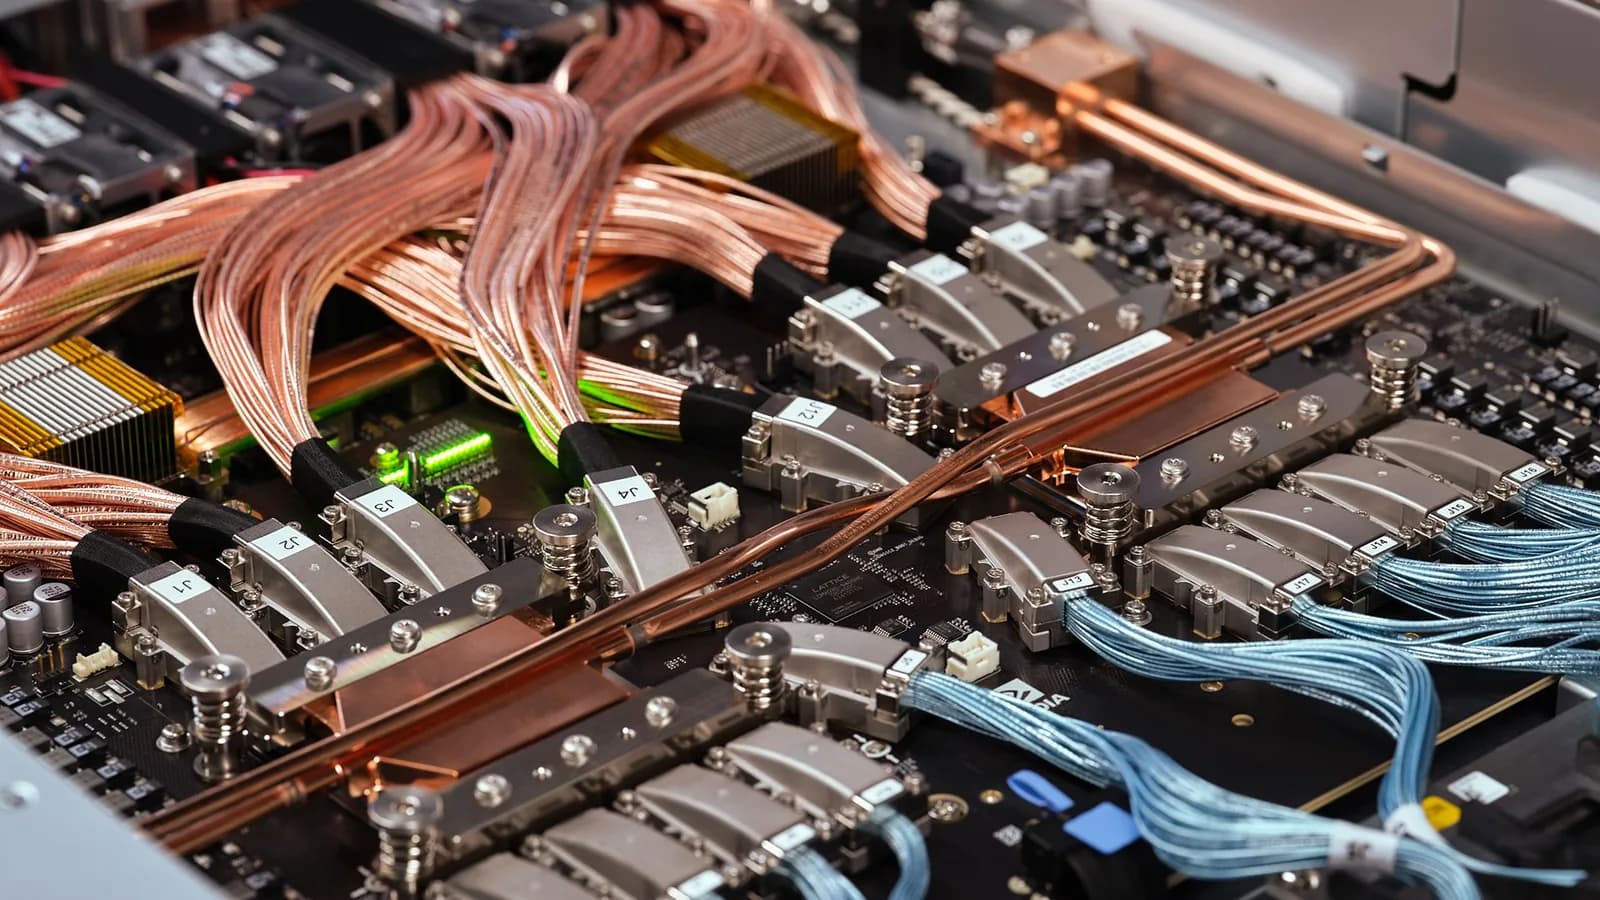
La empresa ya tiene su tecnología UltraFusion para coser dos SoC de gama alta y que se comporten como uno, pero no parece tener una solución propia para la conectividad de escalado vertical y horizontal de sus procesadores. Ahí entra NVLink Fusion. Lo que Apple querría usar es la infraestructura completa, con los switches, los chiplets que agregan conectividad NVLink y la pila de software. El protocolo de interconexión es apenas una parte de ese paquete.
El proyecto arrancó hace alrededor de un año y lo respaldó John Ternus mientras encabezaba la organización de ingeniería de hardware de Apple.
La empresa ya fabrica servidores propios para Private Cloud Compute, que se hacen cargo de las cargas de IA demasiado exigentes para correr localmente en un iPhone o en un Mac, afirma The Information. La mayoría de esas máquinas usa tecnologías de conectividad desarrolladas en casa que, según el reporte, resultan demasiado lentas y demasiado caras para un despliegue comercial a gran escala. Por eso Apple está mirando afuera.
Por qué NVLink no es la herramienta obvia
The Information menciona específicamente la necesidad de Apple de una tecnología de conectividad apta para despliegues a gran escala, aunque no explica qué significa eso en términos de arquitectura. Si la publicación se refiere a conectar varios servidores en clústeres más grandes, ese trabajo lo hacen normalmente las tecnologías de escalado horizontal como Ethernet o InfiniBand, no un tejido de escalado vertical como NVLink.
NVIDIA desarrolló NVLink justamente para escalar el rendimiento de sus aceleradores, así que la tecnología está optimizada para la conexión entre aceleradores y permite que un rack de GPU funcione como un dominio de cómputo acoplado. Existe una implementación distinta, NVLink-C2C, que es una interfaz coherente de chip a chip para conectar CPU con aceleradores y CPU con CPU.
¿Cómo se engancha un M8 Ultra a NVLink?
Los procesadores M Pro y M Ultra actuales de Apple son sistemas en paquete formados por un chiplet de CPU y un chiplet de GPU con motor neuronal, cosidos con la tecnología SoIC-mH de TSMC. Si Apple mantiene esa arquitectura, algo bastante probable, un M8 Ultra se puede leer como una CPU y un acelerador a la vez. Queda la pregunta de cómo piensa Apple conectar los M8 Ultra a NVLink y qué partes del sistema en paquete entrarían al dominio.
Una posibilidad es que Apple exponga la porción de acelerador del M8 Ultra a NVLink a través de un chiplet NVLink Fusion, lo que en la práctica significa tratarla como un acelerador dentro de un dominio de escalado vertical. La otra es que Apple esté desarrollando una arquitectura de acelerador distinta para sus servidores, por ejemplo poniendo el chiplet de GPU y NPU en un sustrato aparte con su propia memoria. No hay evidencia que confirme ese diseño para un chip que está a años de distancia.
El detalle de UALink
Hay otro dato que conviene tener presente. Apple es miembro del consorcio UALink, la organización que desarrolla las interconexiones estándar de la industria entre aceleradores, con soporte para hasta 1.024 aceleradores. Hoy la oferta de switches UALink es limitada, pero para 2029 habrá switches estándar de la industria con distintas prestaciones, lo que vuelve todavía más extraña la elección de NVLink como tejido de escalado vertical.
Una explicación posible es que a Apple le interese bastante más que NVLink. NVLink Fusion es parte de la arquitectura de infraestructura de centro de datos y de escala de rack de NVIDIA, que puede combinar la conectividad vertical de NVLink con las redes horizontales Spectrum-X Ethernet o Quantum-X InfiniBand, incluidos switches con óptica copaquetada. Por esa vía Apple podría adoptar tecnología de NVIDIA tanto para el escalado vertical como para el horizontal, en lugar de desarrollar una pila completa de redes de centro de datos propia.
Eso es especulación por ahora. Un camino así significaría que Apple construye servidores de IA sobre porciones importantes de la arquitectura de centro de datos de NVIDIA, manteniendo sus propios procesadores y sin usar aceleradores de NVIDIA. Si ocurre, es la prueba de que NVIDIA fija hoy los estándares de facto de los centros de datos de IA, sin importar qué aceleradores y qué CPU se usen.
Del Bumpgate a 2029
NVIDIA es el proveedor líder de hardware para centros de datos, así que trabajar con la empresa es lo lógico si las dos están efectivamente armando la plataforma de centro de datos de Apple. El problema es el historial.
Apple y NVIDIA no son exactamente buenos socios. La disputa entre las dos empresas empezó a comienzos de los años 2000, cuando Steve Jobs acusó a NVIDIA de infringir patentes de Pixar y NVIDIA respondió que tenía más propiedad intelectual gráfica que Pixar y que por lo tanto podía demandarla. Más tarde vinieron los desacuerdos por decisiones de diseño de las GPU que NVIDIA le suministraba a Apple.
Después llegó el "Bumpgate". NVIDIA entregó GPU defectuosas a Apple y a otros fabricantes de PC entre 2007 y 2008, no reconoció el problema y se resistió a compensar del todo los costos de reparación. Ahí la relación quedó especialmente mal. Apple siguió usando GPU de NVIDIA hasta 2014 o 2015, cuando se pasó a las Radeon de AMD, y luego abandonó por completo las GPU discretas de terceros.
El acercamiento es más reciente. La última versión de Siri funciona principalmente con los Apple Foundation Models desarrollados en colaboración con Google sobre tecnología Gemini. La inferencia del lado del servidor pasa por la arquitectura Private Cloud Compute y muchas de esas cargas están alojadas en GPU NVIDIA Blackwell dentro de Google Cloud. Usar hardware de NVIDIA en la nube y adoptar sus tecnologías para tu propia plataforma son dos cosas distintas.