DeepSeek actualizó su modelo de pesos abiertos V4.1 Flash a la revisión 1017. Lo que parece una revisión menor puede ser un paso importante en eficiencia. En la página del producto, DeepSeek usa el lema "wish-driven programming made real" (programación guiada por deseos, hecha realidad), una probable referencia al vibe coding, lo que sugiere que el modelo encaja en tareas abiertas con descripciones amplias. El modelo es barato y puntúa bien, pero tiende a alucinar.
Los modelos de lenguaje se reparten a grandes rasgos en dos grupos. Por un lado están los modelos comerciales cerrados de los laboratorios de frontera, caros de correr y con resultados excelentes. Por otro, los competidores chinos de pesos abiertos, que en general cambian confiabilidad por un costo de operación mucho menor, sobre todo en tareas agénticas largas.
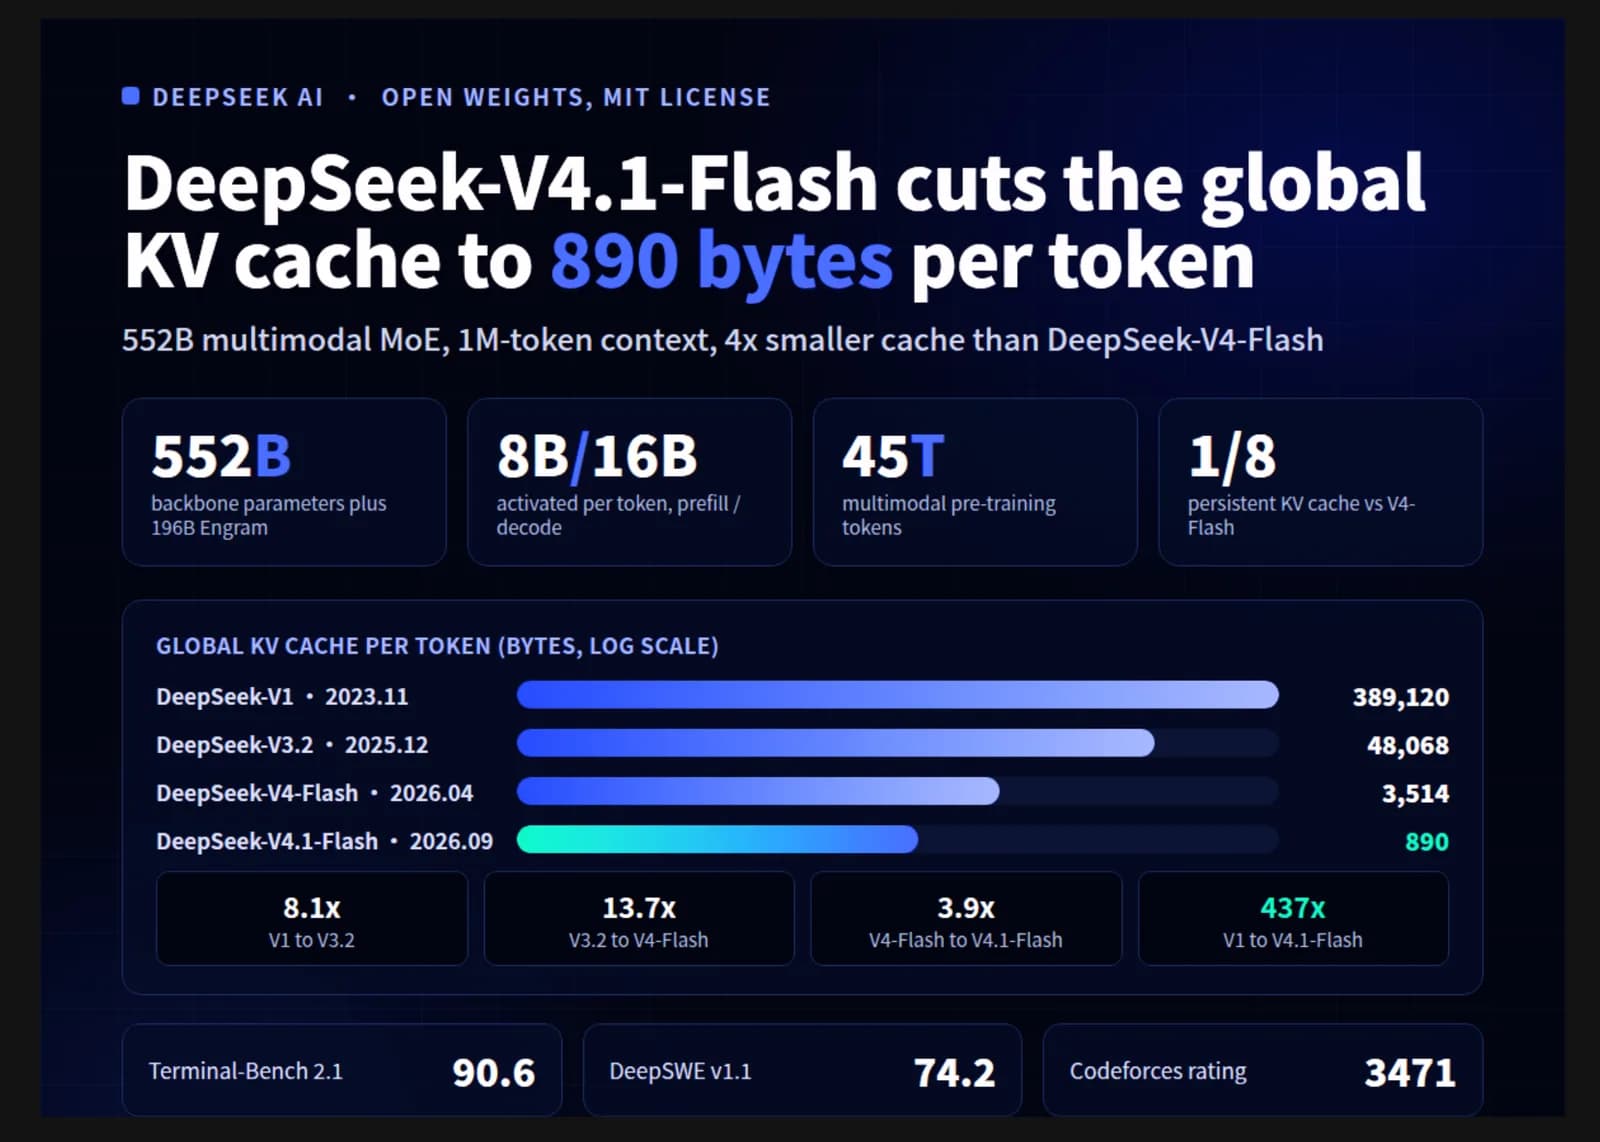
DeepSeek V4.1 Flash es un modelo de mezcla de expertos (MoE) con 552.000 millones de parámetros totales, de los que 16.000 millones quedan activos en cada ejecución. Es multimodal, acepta texto e imágenes como entrada y su ventana de contexto mide 1 millón de tokens, que ya es el estándar.
¿Qué cambió en la revisión 1017?
Según los benchmarks internos de DeepSeek, el modelo queda entre GPT-5.6 Sol y Claude Opus 5, e incluso supera al modelo de Anthropic en pruebas de tareas. La revisión destaca en rendimiento por tarea y en eficiencia de tokens. El paso de V4 Flash a V4.1 Flash redujo mucho los requisitos de hardware. V4.1 usa solo un cuarto de la HBM y un octavo del almacenamiento SSD para su caché KV frente a su antecesor, con 890 bytes por entrada de token.
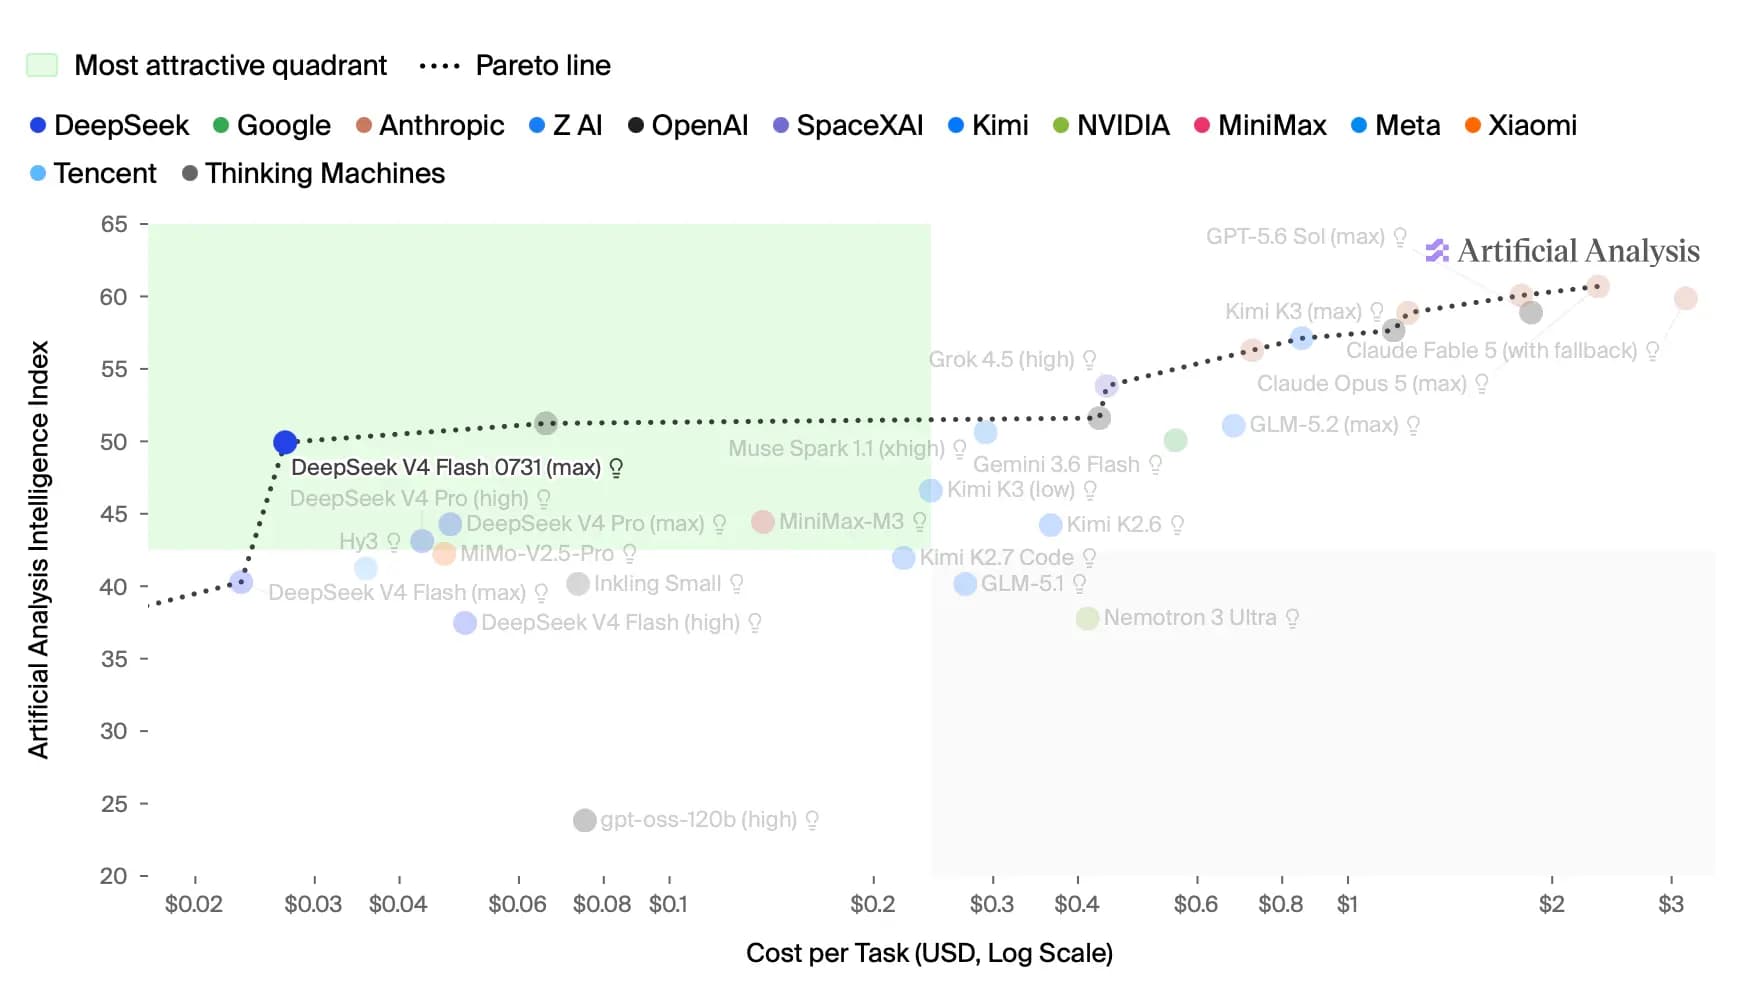
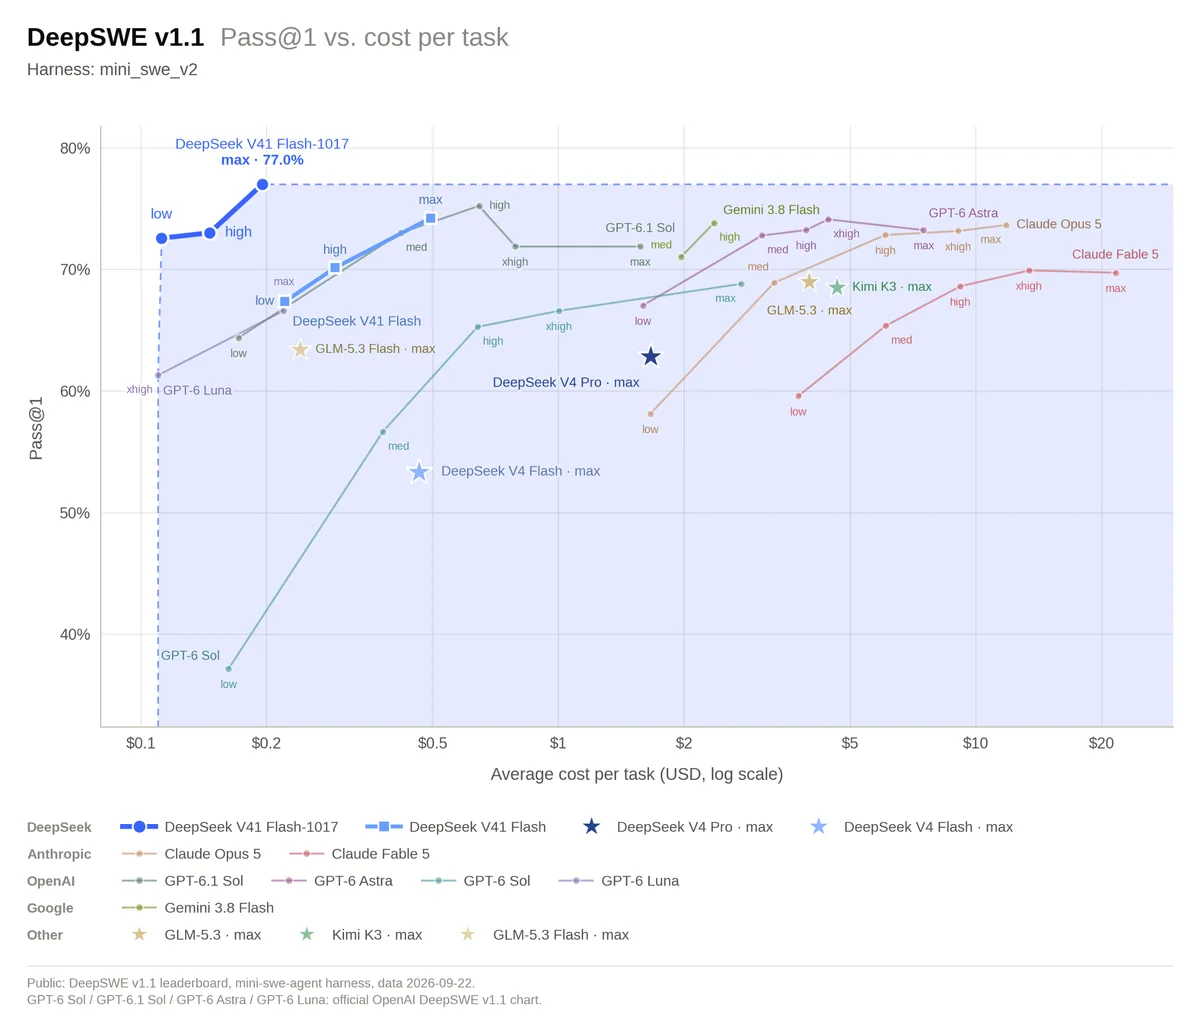
La empresa lo ilustra con un gráfico de costo por tarea basado en el conjunto de datos de DeepSWE del 2 de septiembre, al que agrega sus propios puntos para DSF y DSF-1017. Las dos variantes se agrupan en la zona superior izquierda, la deseable, e incluso las corridas de bajo esfuerzo de DSF-1017 logran una tasa de tareas completadas cercana a la de los ajustes "max" de competidores caros. DeepSWE es solo uno de muchos benchmarks.
¿Cuánto cuesta usarlo?
Con los precios de la propia DeepSeek (y es un modelo abierto que se puede correr en cualquier parte), el millón de tokens en horario de baja demanda cuesta 0,15 dólares de entrada y 0,6 dólares de salida. Con aciertos de caché, la entrada baja a 0,003 dólares. Proveedores externos ya han cobrado menos que la API de DeepSeek, así que comparando proveedores de inferencia esas cifras pueden bajar más. DeepSeek ofrece además búsqueda a 0,75 dólares por cada 1.000 consultas, por debajo de la competencia, donde el más cercano es Parallel con 1 dólar.
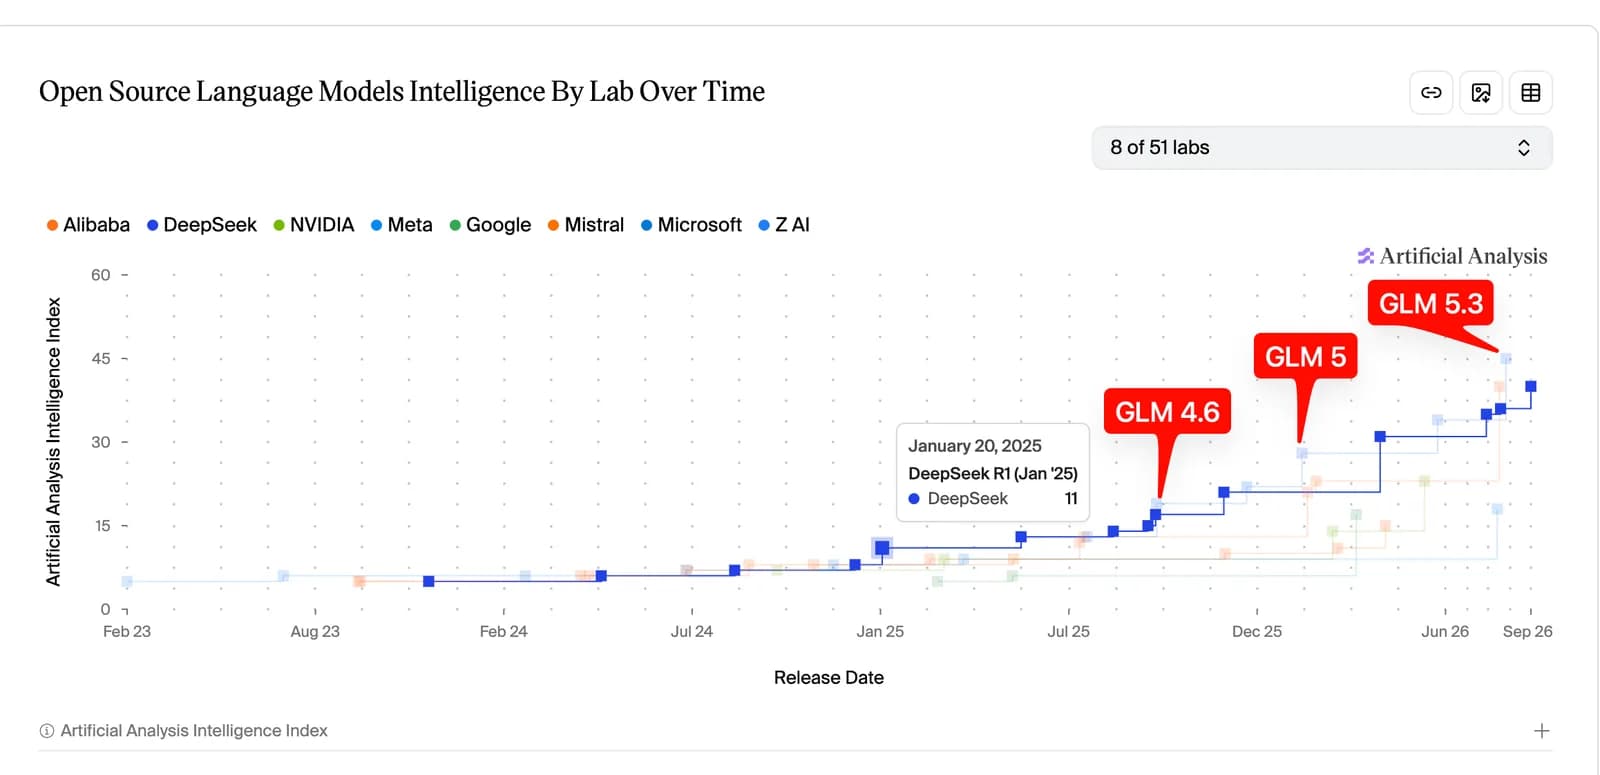
En Artificial Analysis, DSF-1017 (max) aparece segundo en su índice de inteligencia dentro de la clase de modelos abiertos grandes, con 45 puntos. Como referencia, el modelo mejor ubicado, Claude Opus 5.5 (max con fallback), marca 58. Es también uno de los más rápidos de su categoría, y en costo por tarea solo lo supera el MiMo V2.6-Pro de Xiaomi.
El problema de las alucinaciones
Hay un dicho conocido, "rápido, barato y confiable, elige dos". En este caso lo que falla es la alucinación. Que un modelo sea inteligente no lo hace confiable. En general los usuarios prefieren modelos que no responden cuando les faltan hechos de respaldo, y DSF-1017 no parece reconocer bien lo que no sabe.
El benchmark Omniscience de Artificial Analysis lo deja claro y ubica al modelo entre los más bajos. Respondió bien el 43% de las preguntas, de lo mejor entre los modelos abiertos pero por debajo de la competencia propietaria. Eso sería aceptable si se abstuviera cuando no tiene base, pero alucinó en el 67% de los casos en que no debió responder.
El índice principal del benchmark suma puntos por respuestas correctas, resta por las incorrectas y no cuenta las abstenciones. DSF-1017 saca 5 puntos, contra 20 de Kimi K3-max, y los modelos de frontera llegan a 42 o más. O sea DSF-1017 está lejos de ser incompetente, pero hay que elegir bien qué tareas se le asignan.
Las tareas con resultados verificables, como programación, OCR con revisión y conversión de formatos, funcionan bien, porque el agente puede verificar su trabajo y reintentar. La investigación abierta, la búsqueda de datos y la interpretación o redacción de documentos que exigen precisión quedan mejor en manos de un modelo de frontera, o de una persona, porque las alucinaciones probablemente no se van a contener y los resultados no serán confiables.
Bruno Ferreira, autor de la nota de Tom's Hardware, ve una tendencia entre los modelos abiertos más competentes. Cuando salió Kimi K3, hace varios meses, se celebró lo efectivo y barato que era y su promesa de inteligencia de frontera por una fracción del precio. Ferreira cuenta que su experiencia con Kimi duró poco, porque incluso búsquedas de datos cortas y precisas le devolvían información inventada, y los datos de Artificial Analysis respaldan esa observación.
Aun así, los modelos abiertos siguen siendo importantes para abaratar el acceso a agentes de IA y como herramienta para bajar el costo de la inteligencia frente a posibles alzas de precio de los laboratorios de frontera.