Los agentes de horizonte largo convirtieron el servicio de modelos de lenguaje en una carga de trabajo dominada por la entrada. Los prefills repetidos y los contextos de un millón de tokens dejan cachés KV que tensionan la memoria HBM, la capacidad de los discos de estado sólido y el ancho de banda. DeepSeek AI construyó su lanzamiento más reciente justamente alrededor de ese cuello de botella.
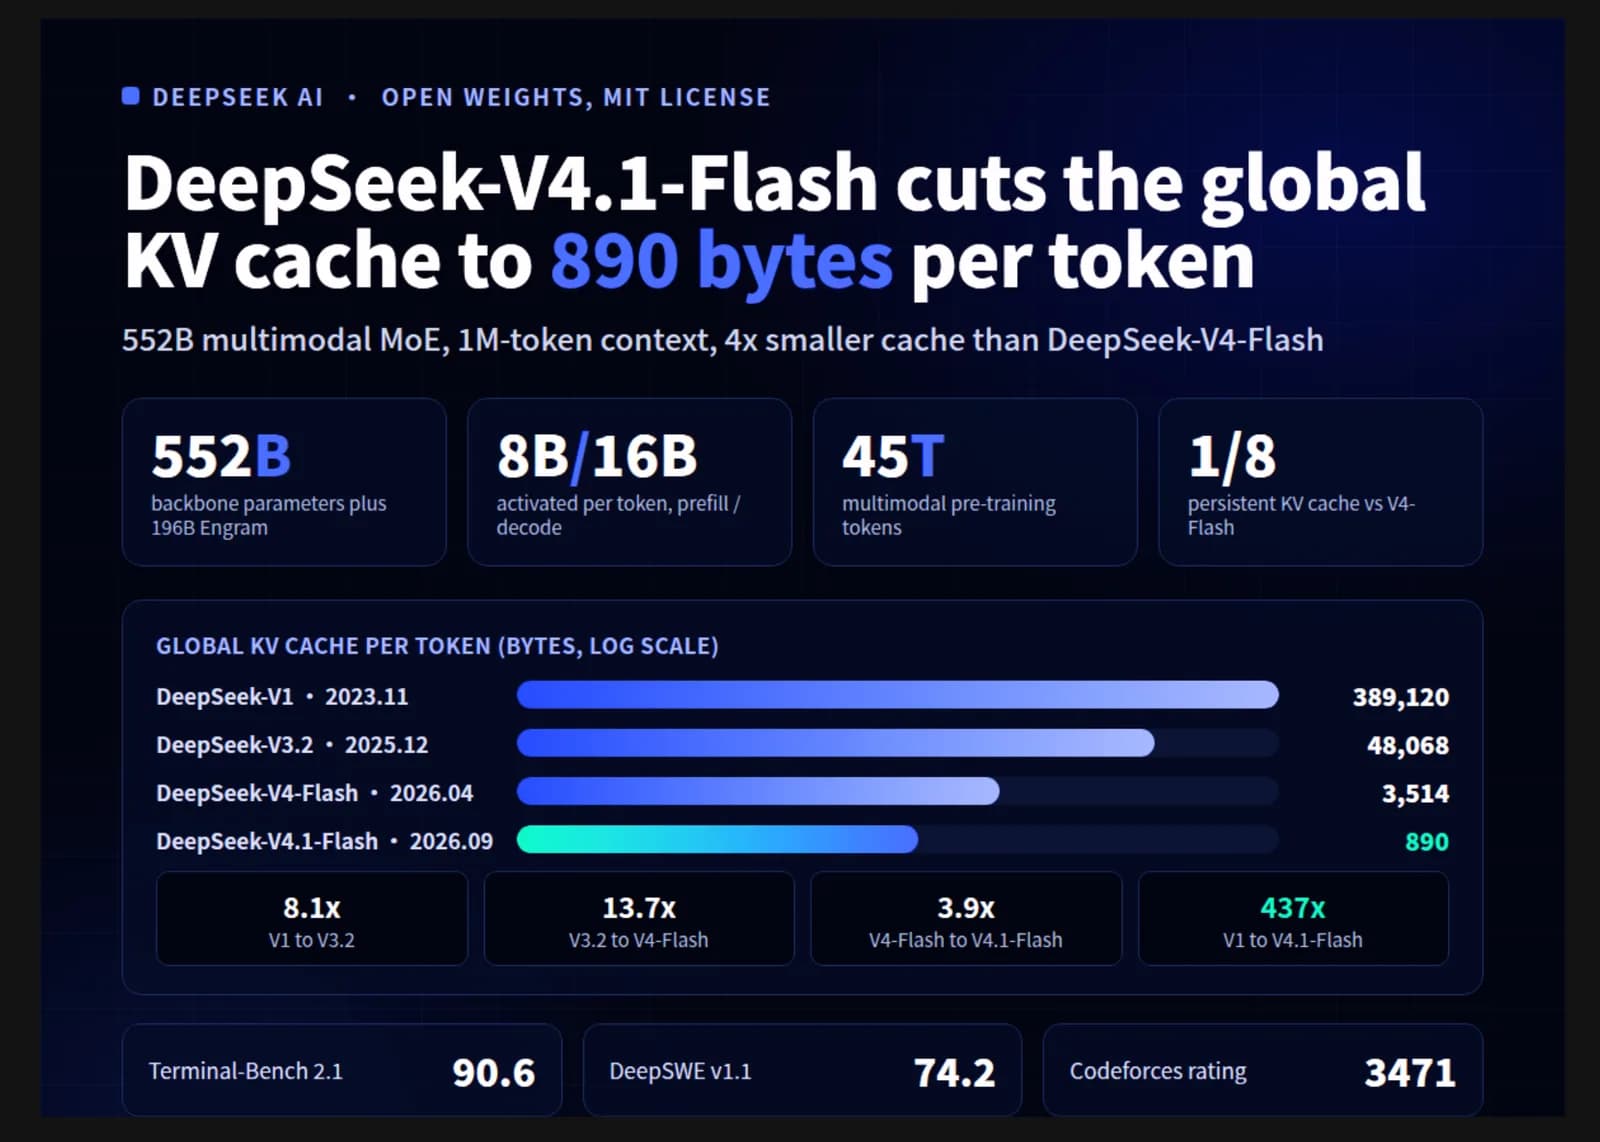
DeepSeek-V4.1-Flash es un modelo multimodal de mezcla de expertos con 552.000 millones de parámetros en el troncal, 196.000 millones adicionales de parámetros Engram y una ventana de contexto de un millón de tokens. Activa 8.000 millones de parámetros por token durante el prefill y 16.000 millones durante el decode. La cifra principal es la huella de caché KV global: 890 bytes por token, cerca de un cuarto de la de DeepSeek-V4-Flash y unas 437 veces menor que la de DeepSeek-V1.
¿Se puede desplegar hoy?
Sí. Los pesos abiertos salen bajo licencia MIT, con caminos de despliegue por vLLM, SGLang y Transformers en Hugging Face. El equipo de investigación describe además una interfaz pública con niveles de razonamiento bajo, alto y máximo.
Codificador y decodificador causal: la mitad del prefill
El troncal de 40 capas se divide en un codificador causal de 20 capas y un decodificador de otras 20. Inspirado en YOCO, el decodificador no calcula su propio KV global: pesos de proyección por capa lo derivan del último estado oculto del codificador. Los tokens del prompt se detienen entonces en el codificador, lo que casi divide a la mitad el cómputo de prefill.
La atención de ventana deslizante, con una ventana de 128 tokens, sigue corriendo en todas las capas, así que los estados de ventana deslizante del decodificador se reconstruyen reproduciendo solo los últimos 128 tokens del prompt. El equipo llama a esa técnica Decoder SWA Bounded Replay.
Compressed Sparse Attention 2
DeepSeek-V4 mezclaba atención comprimida dispersa con atención fuertemente comprimida. V4.1-Flash usa CSA2 puro y ataca el tamaño de la caché a lo largo del eje de las capas. Cada capa CSA2 recibe de forma estática uno de tres modos:
- Full: calcula su propio KV principal, proyecta desde él la K del indexador y selecciona índices frescos entre los 512 mejores.
- Reindex: reutiliza el KV principal y la K del indexador de la última capa Full, pero los vuelve a puntuar con su propia Q de indexador.
- Reuse: reutiliza tanto el KV principal como los últimos índices Top-K, y se salta el indexador por completo.
Cada capa conserva su propia Q principal y su KV de ventana deslizante. Las 18 capas CSA2 del codificador usan una razón de compresión de 2 en tres grupos de seis (una Full y cinco Reuse). Las 20 capas del decodificador usan razón 1 en cinco grupos de cuatro: el primero es Full más tres Reuse, y el resto Reindex más tres Reuse. Un indexador disperso jerárquico en el decodificador permite que la capa Full arme un conjunto candidato de hasta 16.384 posiciones (2.048 bloques de ocho), de modo que las capas Reindex posteriores puntúan un conjunto acotado en vez del contexto completo.
KV en FP4 y otras extensiones
La caché KV principal se cuantiza a E2M1 con una escala E4M3 por cada 16 canales, siguiendo NVFP4 pero sin su escala global. Se introduce mediante entrenamiento consciente de la cuantización en la etapa de post-entrenamiento y casi divide a la mitad el almacenamiento frente a la caché FP8 de V4.
A nivel de despliegue, el KV de ventana deslizante ya no se persiste en disco. Vive en un fondo distribuido tomado del 10% de la memoria DRAM del anfitrión, con un tiempo de vida de minutos, mientras que el KV global mantiene una vida garantizada de 72 horas. Ante un fallo de caché, la reproducción acotada del codificador recalcula solo 128 tokens en lugar del producto entre capas y ventana.
Otros cambios incluyen mHC de pasada única, que desplaza en un bloque los coeficientes de mezcla de entrada para que un núcleo fusionado Mega-mHC reduzca a la mitad el tráfico de memoria de activaciones; el módulo de memoria condicional Engram en las capas 1 y 14; decodificación especulativa DSpark entrenada después del pre-entrenamiento con el troncal congelado; y Muon por cabeza. Los FLOPs de decodificación de un token suben apenas un cuarto cuando el contexto crece de 4.000 a un millón de tokens.
¿Con qué se entrenó y qué resultados da?
El pre-entrenamiento cubre 45 billones de tokens multimodales en una proporción de 7 a 1 entre texto y multimodal. La atención dispersa se entrena desde cero con secuencias de 64.000 tokens, sin calentamiento denso, y el contexto se extiende al millón en los últimos 34 billones de tokens. El modelo base iguala a DeepSeek-V4-Pro-Base en conocimiento del mundo y programación usando un tercio de los parámetros totales y un cuarto de los activados.
El post-entrenamiento no introduce algoritmos nuevos. Las mejoras vienen de la síntesis a gran escala de tareas de agente verificables, de aprendizaje por refuerzo sobre andamiajes heterogéneos (Claude Code, Codex, OpenCode, Pi, mini-SWE y el arnés propio de DeepSeek) y de destilación en política desde más de 40 modelos maestros.
Lo que hay que retener
- La caché KV global cae a 890 bytes por token, cerca de un cuarto de la de V4-Flash y 437 veces por debajo de la de V1.
- El codificador y decodificador causal corre solo 20 capas de codificador en el prefill, activando 8.000 millones de parámetros frente a 16.000 millones en el decode.
- CSA2 comparte KV principal, K de indexador e índices Top-K entre capas en los modos Full, Reindex y Reuse.
- El KV principal en FP4 más la reproducción acotada recortan la caché persistente a cerca de un octavo de la de V4-Flash.
- Según el reporte, supera a Opus-5 y a GPT-5.6 Sol en Terminal-Bench 2.1 y en DeepSWE v1.1, con pesos bajo licencia MIT.
Están disponibles el modelo en Hugging Face y el reporte técnico.
Para equipos de la región que evalúan alojar el modelo por su cuenta, el dato que más pesa no es el conteo de parámetros sino esos 890 bytes por token: un contexto lleno de un millón de tokens ocupa cerca de 890 megabytes de caché KV, contra los más de tres gigabytes que exigía la generación anterior con la misma ventana. Esa diferencia es la que decide si una sesión larga cabe o no en el mismo acelerador.