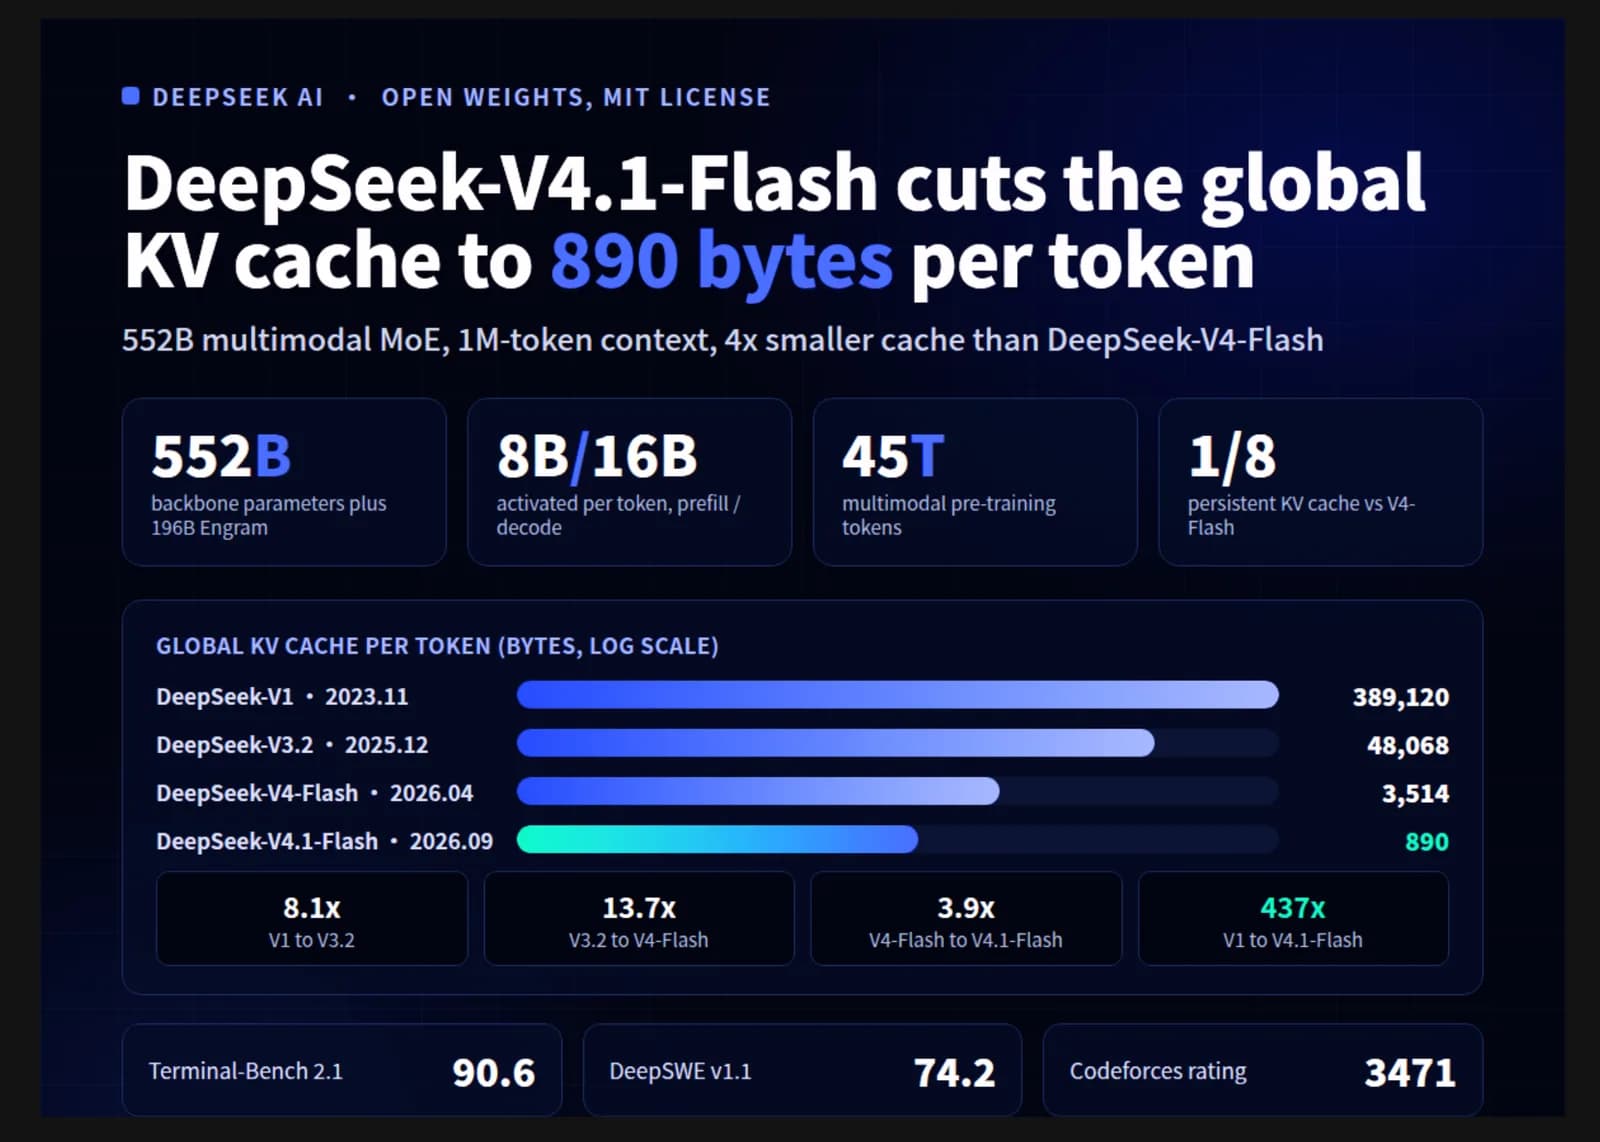
Son 763.000 millones de parámetros totales, de los cuales el modelo activa 8.000 millones para leer lo que entra y 16.000 millones para escribir lo que sale. Con esa cuenta apareció DeepSeek V4.1 Flash, de pesos abiertos y licencia MIT, y de ahí viene la notación 763B-P8B-D16B con que lo anotó Latent Space en su recuento del 9 y 10 de septiembre de 2026. La dispersión queda entre 1% y 2%.
El número de parámetros activos cambia según la etapa, y la notación habitual de los modelos de mezcla de expertos no contemplaba esa distinción, así que hubo que estirarla. La letra P marca los que se encienden al procesar la entrada y la letra D los que se encienden al generar la respuesta.
En paralelo DeepSeek retiró en silencio al V4 Pro y movió su apuesta al modelo nuevo, que pese al cambio de arquitectura igual tituló como una versión menor. Latent Space lee ahí un mensaje cruzado. Quien mire solo el número de versión y el titular de los benchmarks va a concluir que esto es un ajuste de mantención, y no lo es. La arquitectura del codificador y decodificador causal, además, recupera un esquema que la industria había dejado de lado desde el trabajo original de Attention is All You Need, ahora apilado sobre las innovaciones que vinieron después.
¿Qué tiene de nuevo la arquitectura?
Artificial Analysis describe un encoder-decoder causal nuevo, con 8.000 millones de parámetros activos para la entrada y el prellenado, y 16.000 millones para la salida y la decodificación.
Sebastian Raschka la calificó de "reforma grande" y agregó que "deberían haberlo llamado DeepSeek V5", y señaló el esquema de codificador y decodificador como el quiebre con las generaciones previas de la casa.
Varios lectores técnicos leyeron el diseño como un híbrido poco común. Uno de ellos, la cuenta _xjdr, lo describió así.
"Una mezcla muy interesante de ideas muy conservadoras y a veces viejas en investigación con eficiencia y diseño de hardware potencialmente de punta en ingeniería."
La cuenta Stochastic Chasm resumió el arreglo como una rama local de ventana deslizante sumada a una rama de recuperación dispersa, y lo emparentó con HySparse, NSA y las propias CSA y HCA que DeepSeek estrenó en el V4. Su lectura es que ese híbrido de local y disperso se está volviendo un patrón compartido y no una rareza de una sola casa.
El ahorro está en la caché
El informe técnico del V4.1 Flash suma un mecanismo llamado Sliding-Window Attention Bounded Replay. Con eso la huella de la caché de claves y valores baja hasta un octavo de la que tenía el V4 Flash. Ese es el dato que le importa a quien corre agentes de sesión larga, porque la caché es lo que crece mientras la conversación avanza, y es lo que termina mandando en la factura y en la latencia.
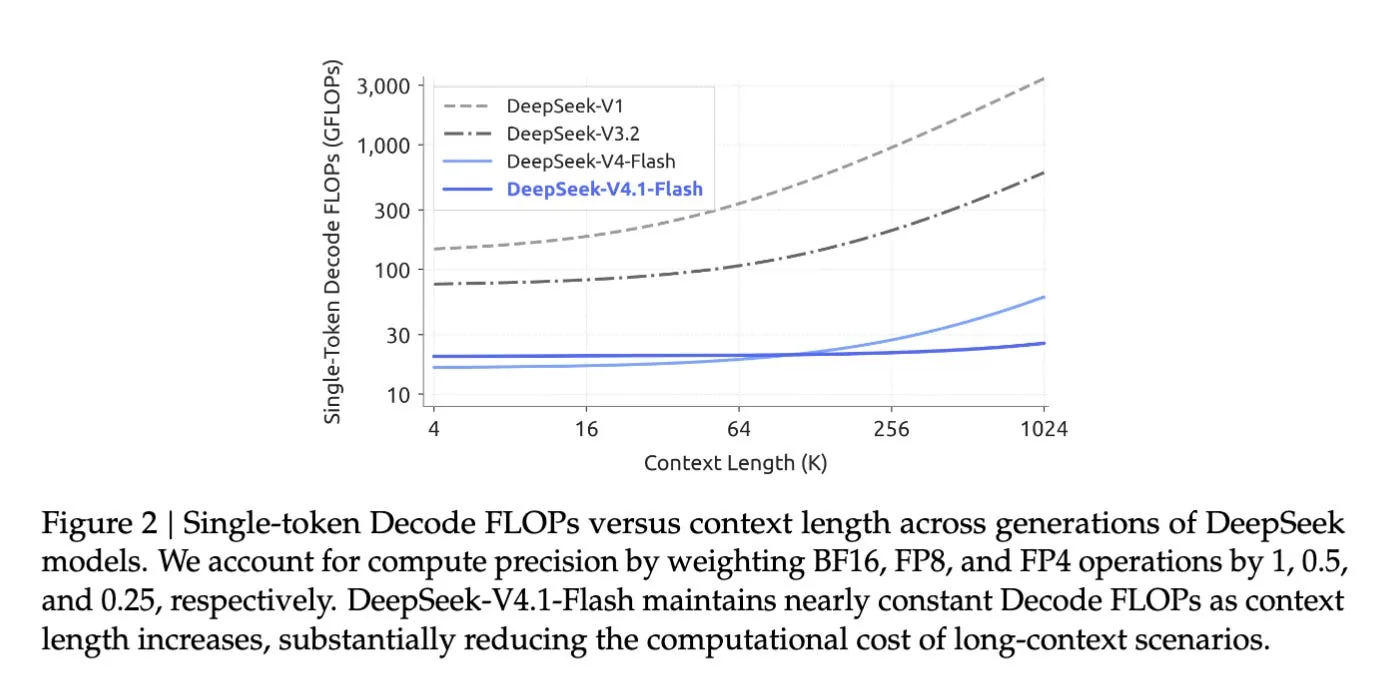
La cuenta nrehiew midió esa huella en cerca de 890 bytes por token en el régimen de puntaje evaluado, y resumió el modelo como un caso de estudio de "cómo obsesionarse con la compresión de la caché de claves y valores te deja un modelo de frontera hipereficiente". En una nota posterior concluyó que el arreglo se ve más limpio que la combinación de HSA y CSA del V4, y que está "muy claramente diseñado para inferencia".
Stochastic Chasm dedujo además que la caché lleva entrenamiento consciente de la cuantización, lo que explicaría por qué el modelo rinde mejor que sus pares cuando esa caché corre en FP4.
¿A qué precio y dónde se puede usar?
| Concepto | Precio por millón de tokens |
|---|---|
| Entrada | 0,30 dólares |
| Salida | 1,20 dólares |
| Entrada servida desde caché | 0,006 dólares |
A esa lista se suma un descuento de 50% en horario de baja demanda. El modelo acepta texto e imagen, tiene ventana de contexto de un millón de tokens y se ofrece por la API propia de DeepSeek en Estados Unidos.
Baseten habilitó soporte el mismo día del lanzamiento y describió el producto como más inteligente, más rápido y más eficiente que el V4 Pro 0813, con texto y visión, disponible solo en Estados Unidos y con retención cero de datos. Ollama empezó a repartirlo en las cuentas Max y Team, y después lo extendió a los suscriptores del plan Pro.
Para quien integra desde Chile, los pesos publicados y la licencia MIT dejan abierta la opción de alojarlo en infraestructura propia, y el precio de la API de DeepSeek queda como la referencia contra la cual comparar esa alternativa.
¿Dónde queda en los rankings?
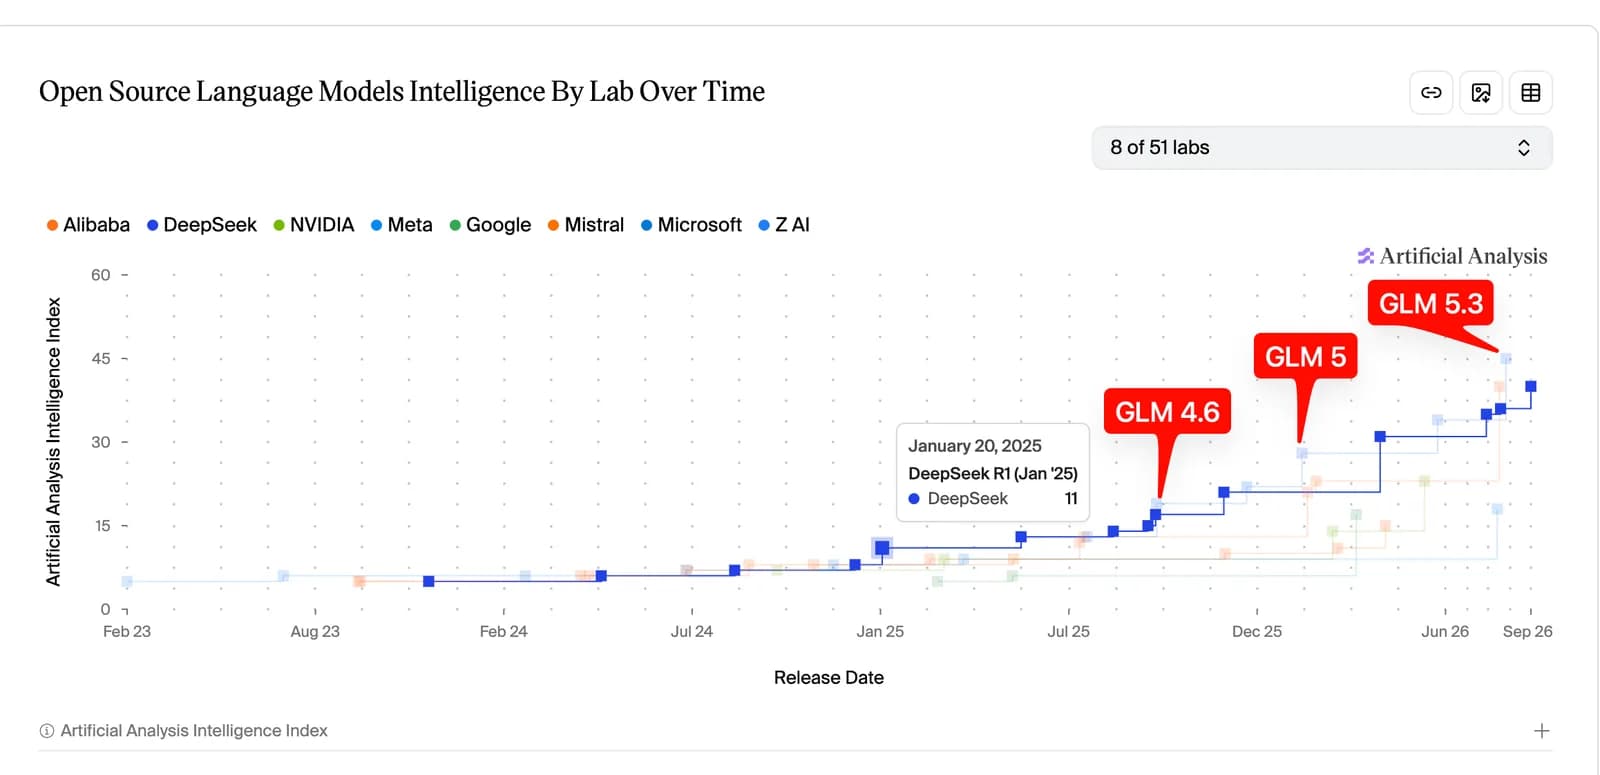
Artificial Analysis le asignó 40 puntos en su Intelligence Index, por encima del DeepSeek V4 Pro 0813 y por debajo del GLM-5.3-Flash. La cuenta Scaling01 llegó al mismo número por su lado.
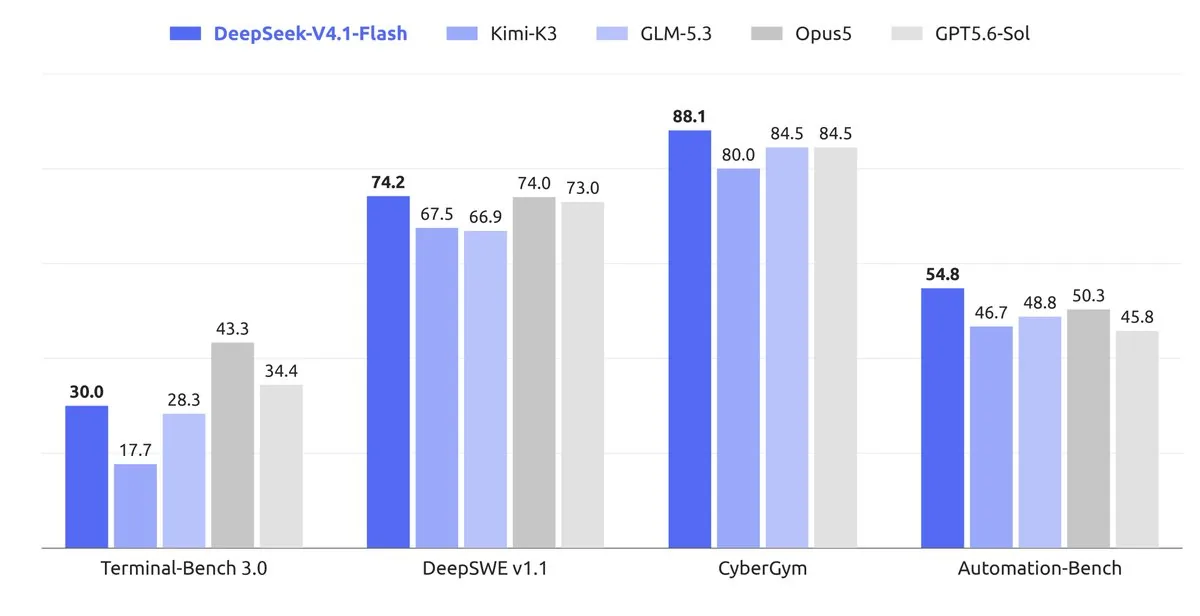
Vals lo dejó primero entre los modelos de pesos abiertos de su índice, por delante del Kimi K3, con un costo de 0,30 dólares por prueba, el más barato de los diez primeros de esa categoría. La evaluación corrió con contexto de un millón de tokens, un máximo de 384 tokens de salida, temperatura 1, top-p y top-k por defecto y esfuerzo de razonamiento alto.
Las mediciones independientes coinciden en que el modelo rinde fuerte en inteligencia ajustada por costo, en contexto largo y en tareas de automatización. El reparo que aparece de forma transversal es la verbosidad de las respuestas.
Latent Space defiende que ese lugar en las tablas no es el punto. Su argumento es que todavía no existe una prueba que capture lo que persigue el V4.1, que describe como el uso más creativo y eficiente del contexto explicado abiertamente hasta ahora.
Las capas y el detalle de visión
TeortaxesTex notó un patrón que DeepSeek repite, hacer algo distinto en las primeras capas. Antes eran densas o con enrutado por hash, y ahora quedaron solo con atención de ventana deslizante. Su hipótesis es que detrás hay dificultades de entrenamiento que se repiten en esa zona de la red. El mismo lector calculó después que la pila baja a 40 capas, de las cuales discute que solo 20 sean capas decodificadoras legítimas, y sostuvo que la casa está usando varias frecuencias de compresión a la vez.
En la parte multimodal el cambio es menor. Según Stochastic Chasm, DeepSeek deja que la columna vertebral del modelo se haga cargo de casi todo y le entrega tokens visuales. Lo que sí cambia es el pixel unshuffle de 3x3 en lugar del 2x2 más habitual. La misma cuenta marcó después una diferencia grande con los codificadores de visión del K3, es decir que el frente visual se aparta de lo que vienen haciendo sus pares chinos.
Cómo se entrenó
Del informe salieron varios detalles de infraestructura. Una estrategia de despacho para reducir las esperas de cola larga, repetición del enrutador desde puntos de control previos, tope a nivel de conjunto de datos para manejar los efectos fuera de política de las respuestas cortas, esquemas de descarte, razón fuera de política acotada con enmascarado de pérdida, y claves, valores y enrutadores persistentes cuando se actualiza un punto de control. La etapa final usó destilación de política en línea sobre vocabulario completo con más de 40 modelos maestros.
En lo que toca al post entrenamiento, los autores se alinean en buena medida con lo que viene sosteniendo el profesor Jie Tang.
De dónde viene este modelo
DeepSeek trabaja con un método reconocible. Entre una versión mayor y la siguiente, de la v2 a la v3 y de ahí a la v4, publica papers intermedios con una sola mejora arquitectónica muy acotada cada vez, y Latent Space le atribuye a esa tanda una tasa de acierto que raya el 100%. Por ahí pasaron Math, con el método de aprendizaje por refuerzo GRPO que después copió media industria, y Coder y R1, más el trabajo posterior de Engram, las hiperconexiones con restricción de variedad y la atención dispersa comprimida.
Después de la atención que le trajo el paper de R1 en la primera mitad de 2025, la casa pasó cerca de un año en silencio y dejó que GLM y Kimi tomaran la delantera en modelos abiertos. Hubo semanas en que su continuidad como laboratorio de punta se puso en duda.
La visión llegó esta vez dentro del mismo modelo, sin el lanzamiento aparte que la casa había hecho en agosto para esa capacidad.