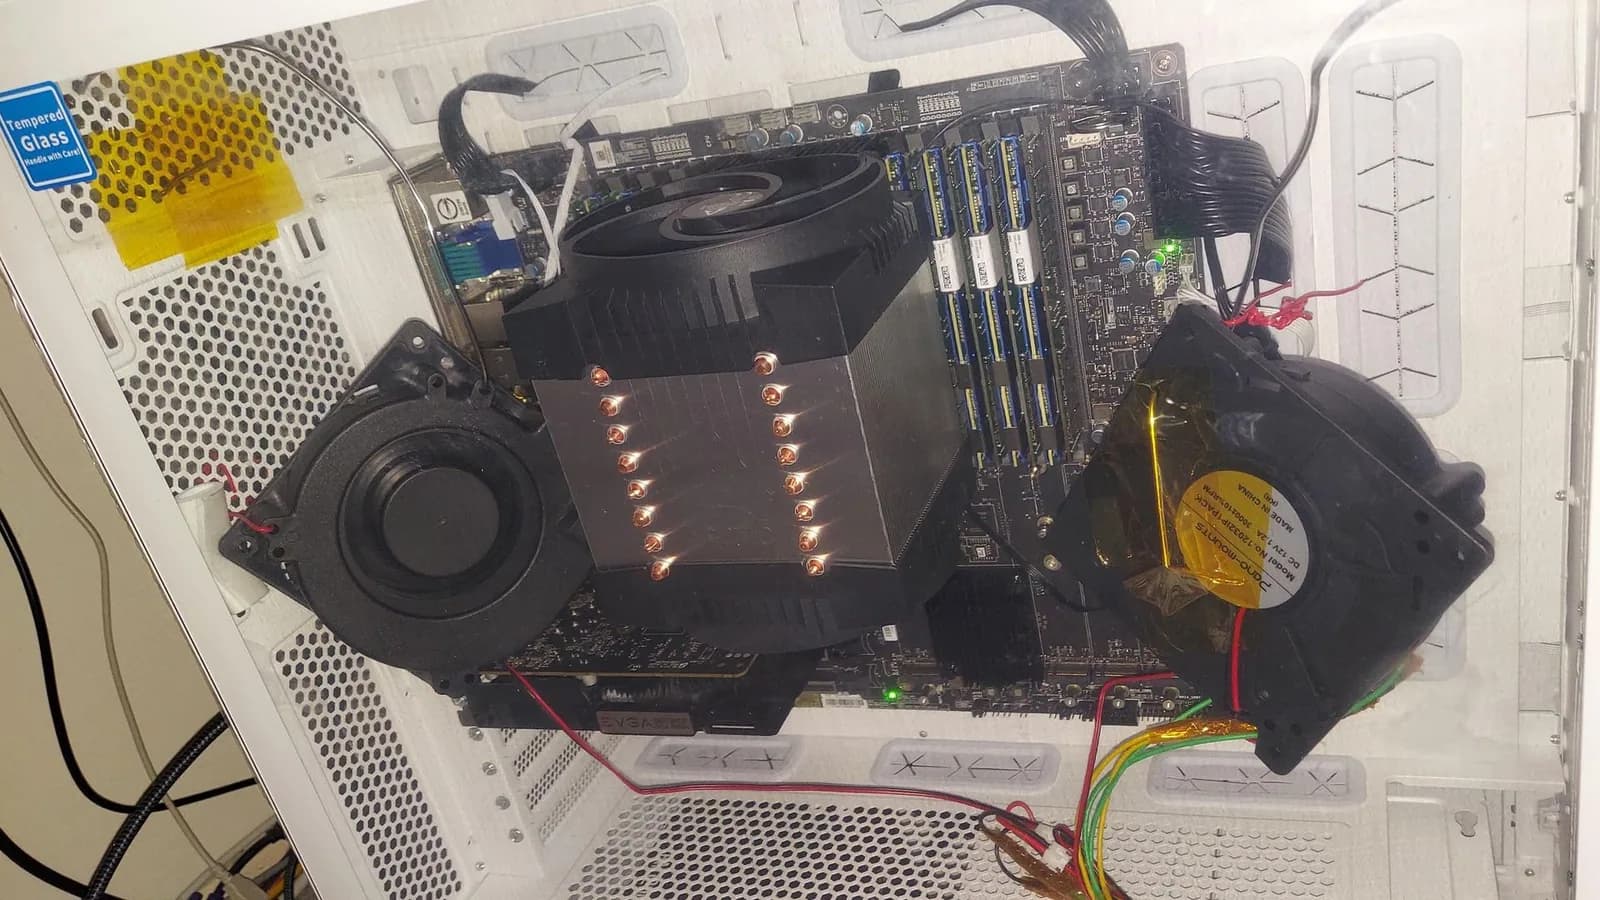
Un usuario de Reddit que arma servidores caseros logró correr Kimi K3, el modelo de IA de 2,8 billones de parámetros de Moonshot AI, sobre memoria Optane PMem 200 de segunda generación, un producto que Intel ya descontinuó. La inferencia la hace una CPU Xeon Scalable de tercera generación con 40 núcleos, sin GPU.
El equipo se calienta, y el consejo de su autor es "tratar el enfriamiento activo de los DIMM como obligatorio". Para controlar las temperaturas puso dos ventiladores tipo blower de 12 W apuntando directo a los módulos. El proyecto es la continuación de otro montaje con Optane de primera generación que hizo un usuario distinto a comienzos de este año, y corre a unos lentos 0,85 tokens por segundo, incluso con cuantización de 1 bit.
¿Por qué Optane y no DRAM?
Kimi K3 no está pensado para uso doméstico, según la evaluación de Tom's Hardware. Moonshot AI recomienda motores de inferencia de centro de datos para correrlo, y hasta la cuantización comunitaria más chica exige al menos 610 GB de RAM. Optane de segunda mano es una de las pocas maneras de llegar a esa capacidad en casa. A eso se suma que los precios de la DRAM se dispararon, y el autor dice que la memoria Optane le costó "una fracción" de lo que vale la cantidad equivalente.
Intel lanzó la serie Optane Persistent Memory 200 (PMem 200) en 2020 para sus procesadores Xeon Scalable de tercera generación, en capacidades de 128, 256 y 512 GB. En plataformas Xeon de dos sockets funciona a una tasa efectiva de MT/s más alta que la primera generación (PMem 100), la que usó el primer proyecto, y puede entregar en promedio hasta 32% más ancho de banda de memoria.
Optane trabaja en dos modos, Memory Mode y App Direct Mode, y las dos plataformas permitían cualquiera de ellos. En Memory Mode, Optane funciona como memoria del sistema y la DRAM le sirve de caché. Ese fue el método del primer montaje. App Direct, el modo del segundo, expone Optane como una región persistente aparte que el software mapea directamente. Según el autor del primer proyecto, u/APFrisco, que planeaba probarlo, esto da "más control sobre dónde viven los tensores del modelo".
¿Cuánto rinde frente al montaje anterior?
Usar Optane en vez de DRAM le pega al rendimiento. Con una cuantización más alta, de 3 bits, la velocidad bajó todavía más, a 0,75 tokens por segundo. Un comentarista calculó que una tarea de 50.000 tokens tomaría 13 horas a cerca de un token por segundo, y otro respondió que a los trabajos por lotes que corren de noche la velocidad les importa menos.
| Montaje | Modelo | Memoria | Cuantización | Velocidad |
|---|---|---|---|---|
| Primero (u/APFrisco) | Kimi K2.5, 1 billón de parámetros | PMem 100 en Memory Mode, más una RTX 3060 | 2 bits | cerca de 4 tokens/s |
| Segundo | Kimi K3, 2,8 billones de parámetros | PMem 200 en App Direct, sin GPU | 1 bit | 0,85 tokens/s |
| Segundo | Kimi K3, 2,8 billones de parámetros | PMem 200 en App Direct, sin GPU | 3 bits | 0,75 tokens/s |
En el primer caso, la RTX 3060 se encargaba de una parte del modelo, que además era más chico y anterior.
El problema del calor
El autor más reciente también tuvo que lidiar con el calor. Los DIMM Optane se ponían "extremadamente calientes" con inferencia sostenida, una situación que según él puede poner en peligro la DRAM que está al lado. Ese calor calza con las especificaciones de la propia Intel, que pide para estos módulos un flujo de aire forzado de 2,4 a 2,7 metros por segundo, lo normal en un centro de datos. En un computador doméstico no suele haber ese nivel de aire apuntando directo a las memorias.
Según las condiciones de operación esperadas, cada módulo Optane disipa 12 o 15 W, sin importar su capacidad. Con cuatro módulos, serían hasta 60 W de calor justo al lado de la memoria del sistema. Los módulos bajan su velocidad a los 83 °C y se apagan a los 85 °C, mientras que la memoria DDR4 típica de servidor está especificada para 85 °C y hasta 95 °C en rango extendido. Hay que sacar mucho calor del equipo para que siga funcionando.
Las cifras de rendimiento son previas a cualquier ajuste, sin optimizar la cantidad de hilos ni la afinidad NUMA, así que hay margen para mejorar. Un comentarista preguntó además por usar Memory Mode con la DRAM como caché de los expertos más usados. El autor planea sumar GPU y cargar partes del modelo en DRAM como un nivel más rápido junto a Optane, y promete "más pruebas por venir".