Seeed corre un LLM de 7B local con 26 TOPS por 379 dólares
El kit combina el módulo reComputer RK3576 con la aceleradora RK1820 de Rockchip y apunta a inferencia en el borde sin GPU de estación de trabajo ni API en la nube.
8 notas publicadas

El router virtual descubre los computadores de la red doméstica y distribuye entre ellos las peticiones independientes de un sistema multiagente, sin tocar el código del agente.

El Personal AI Router es software libre, funciona con GeForce RTX 20 en adelante y también con chips Apple M4, y aprovecha los equipos mientras nadie los usa.

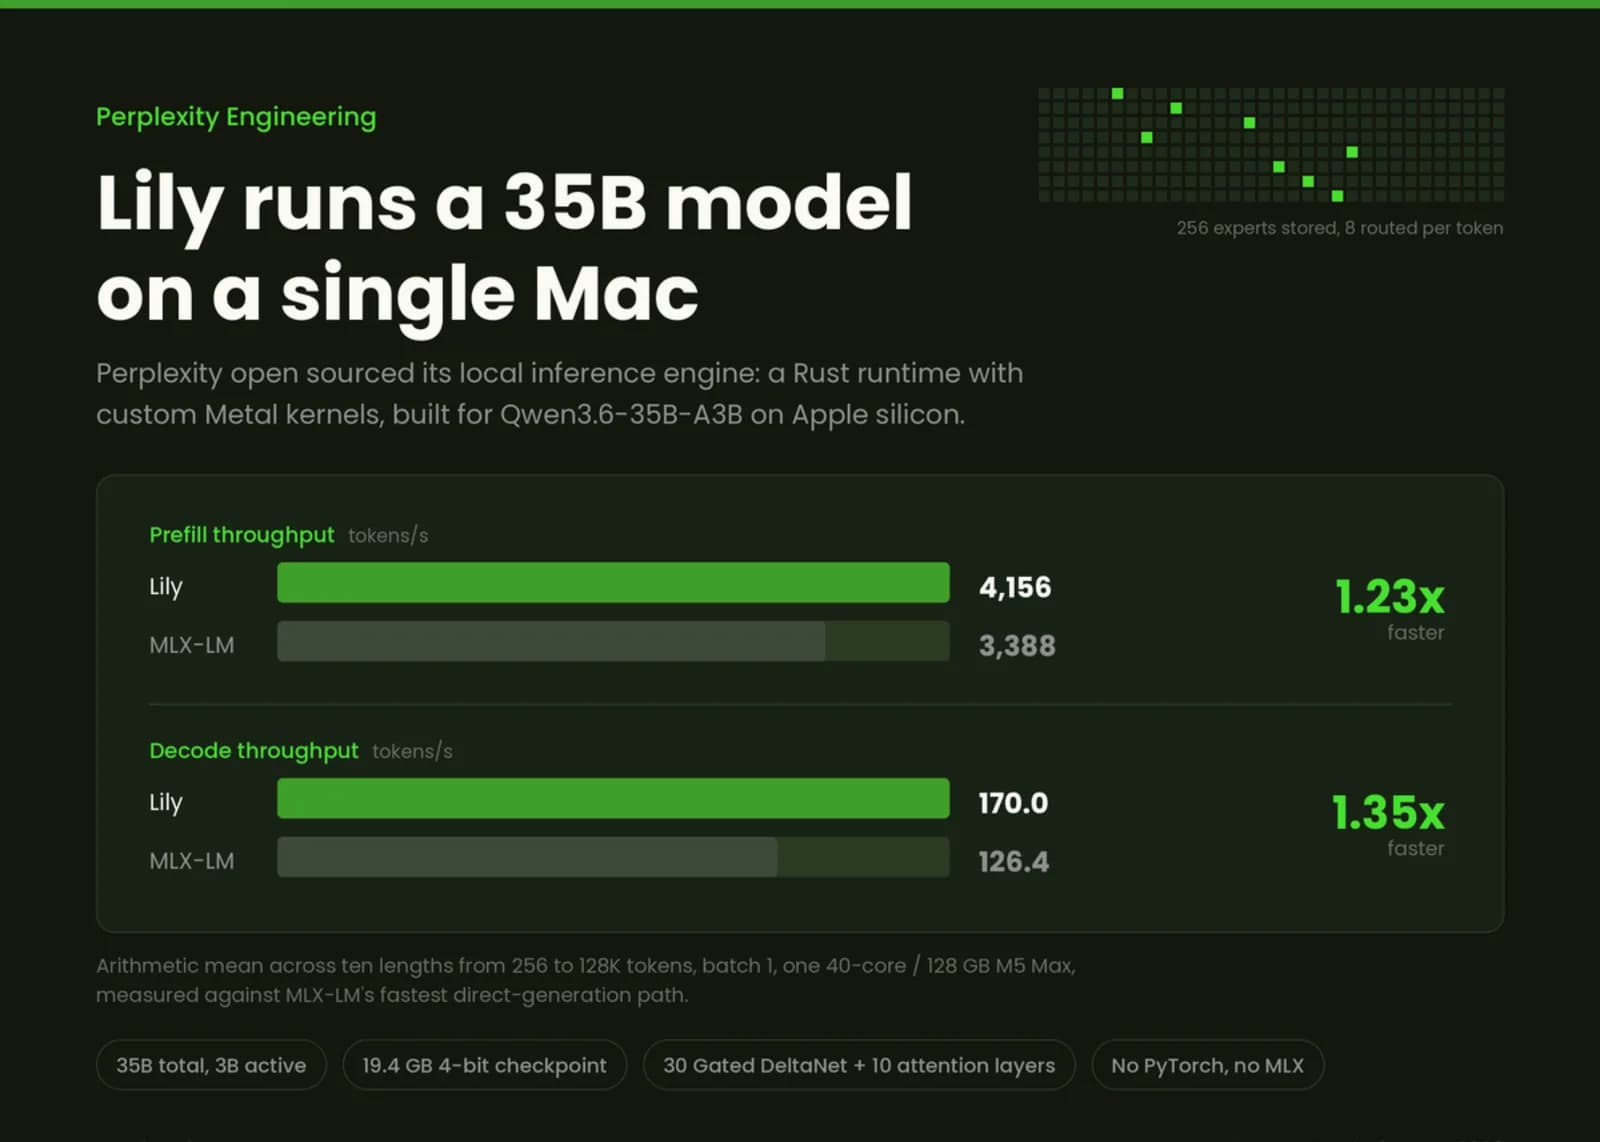
El motor detrás de Hybrid Compute corre Qwen3.6-35B-A3B sin PyTorch ni MLX en el camino de ejecución, con kernels Metal escritos a mano.

El servidor local de IA respaldado por AMD suma soporte experimental de HRX sobre llama.cpp, con mejoras de 30% a 50% en la fase de prellenado frente a los backends Vulkan y HIP existentes.

Las versiones cuantizadas del modelo abierto de 27.000 millones de parámetros funcionan en equipos de 32 GB de RAM, y hasta en uno de 16 GB con calidad degradada.

Las nuevas versiones del stack en Docker de Intel suman soporte el mismo día del lanzamiento para el modelo de 30B de Meta, más generación de video local y mejoras de latencia en Gemma 4.

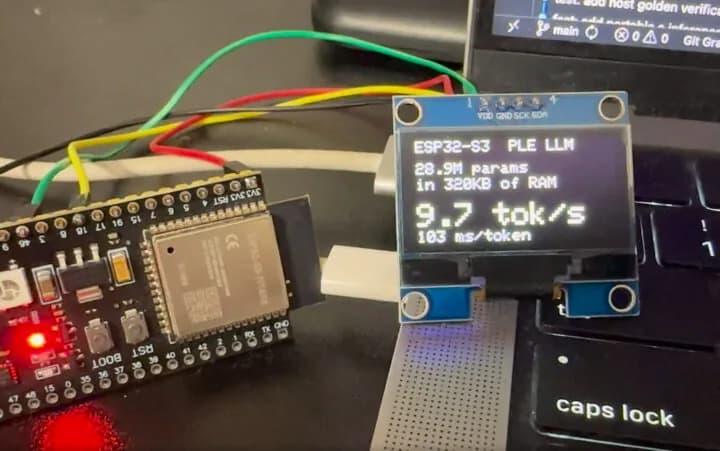
El desarrollador Slava S. logró que un modelo de lenguaje completo se ejecute sin conexión en una placa de unos 8 dólares, apoyándose en la técnica de embeddings por capa de Google.
Otros temas que aparecen junto a #inferencia local en nuestra cobertura editorial.