Un grupo de investigadores de NVIDIA publicó en noviembre VFlash, un método de planificación visual que acelera hasta 12 veces la decodificación de trayectorias de robots. En algunas pruebas también redujo hasta 61% el error de predicción en trayectorias 3D, según reportó Interesting Engineering.
VFlash permite que los modelos de visión y lenguaje (VLM) generen una trayectoria de robot completa, u otras predicciones espaciales, en una sola pasada. Los modelos convencionales producen las coordenadas de a una.
En pruebas de manipulación robótica, VFlash recortó cerca de 80% la latencia total de inferencia en las plataformas Jetson Thor y DGX Spark de NVIDIA. Un robot que planifica más rápido puede reaccionar antes cuando cambia su entorno.
El problema de generar coordenadas de a una
Los VLM convencionales suelen generar sus predicciones espaciales coordenada por coordenada. A medida que un robot necesita predecir trayectorias más largas, seguir más objetos y procesar información espacial más detallada, ese enfoque secuencial alarga el tiempo de cómputo.
VFlash aprovecha la estructura conocida de las predicciones visuales para generar un objeto geométrico o una trayectoria entera en una sola pasada hacia adelante del modelo.
¿Cuánto baja la latencia?
En las pruebas de manipulación los investigadores midieron estas latencias de inferencia.
| Plataforma | Decodificación autorregresiva | VFlash |
|---|---|---|
| Jetson Thor | 3.552,7 ms | 703,3 ms |
| DGX Spark | 3.356,5 ms | 649,9 ms |
En el Jetson Thor eso equivale a una reducción aproximada de 80% frente a la decodificación autorregresiva convencional.
¿Cómo predice la trayectoria completa?
VFlash identifica primero la estructura de la predicción visual que se le pide y después genera las coordenadas. Una caja delimitadora, por ejemplo, tiene un formato fijo de coordenadas, mientras que una trayectoria puede contener una cantidad variable de puntos en dos y tres dimensiones.
El modelo usa un borrador liviano basado en difusión para predecir todas esas coordenadas juntas en una sola pasada. La decodificación especulativa convencional verifica cada token generado contra un modelo objetivo. VFlash, en cambio, puede aceptar una predicción visual que sea estructuralmente válida sin exigir coincidencia token por token.
Los investigadores evaluaron el método en varias tareas de predicción de trayectorias de robot en 2D y 3D. En varias pruebas redujo el error frente al enfoque autorregresivo de base. En las de trayectorias 3D bajó el error de desplazamiento promedio hasta 61%, según el conjunto de datos y la configuración de entrenamiento.
También lo probaron en la predicción de movimiento de puntos 3D, donde el modelo anticipa cómo se moverán los objetos a lo largo de los cuadros de un video. Las mediciones preliminares, con una sola ejecución, mostraron una generación cerca de 25 veces más rápida que la decodificación autorregresiva.
Más éxito en las tareas del robot
El equipo revisó además si las predicciones más rápidas mejoran a los sistemas de control que vienen después.
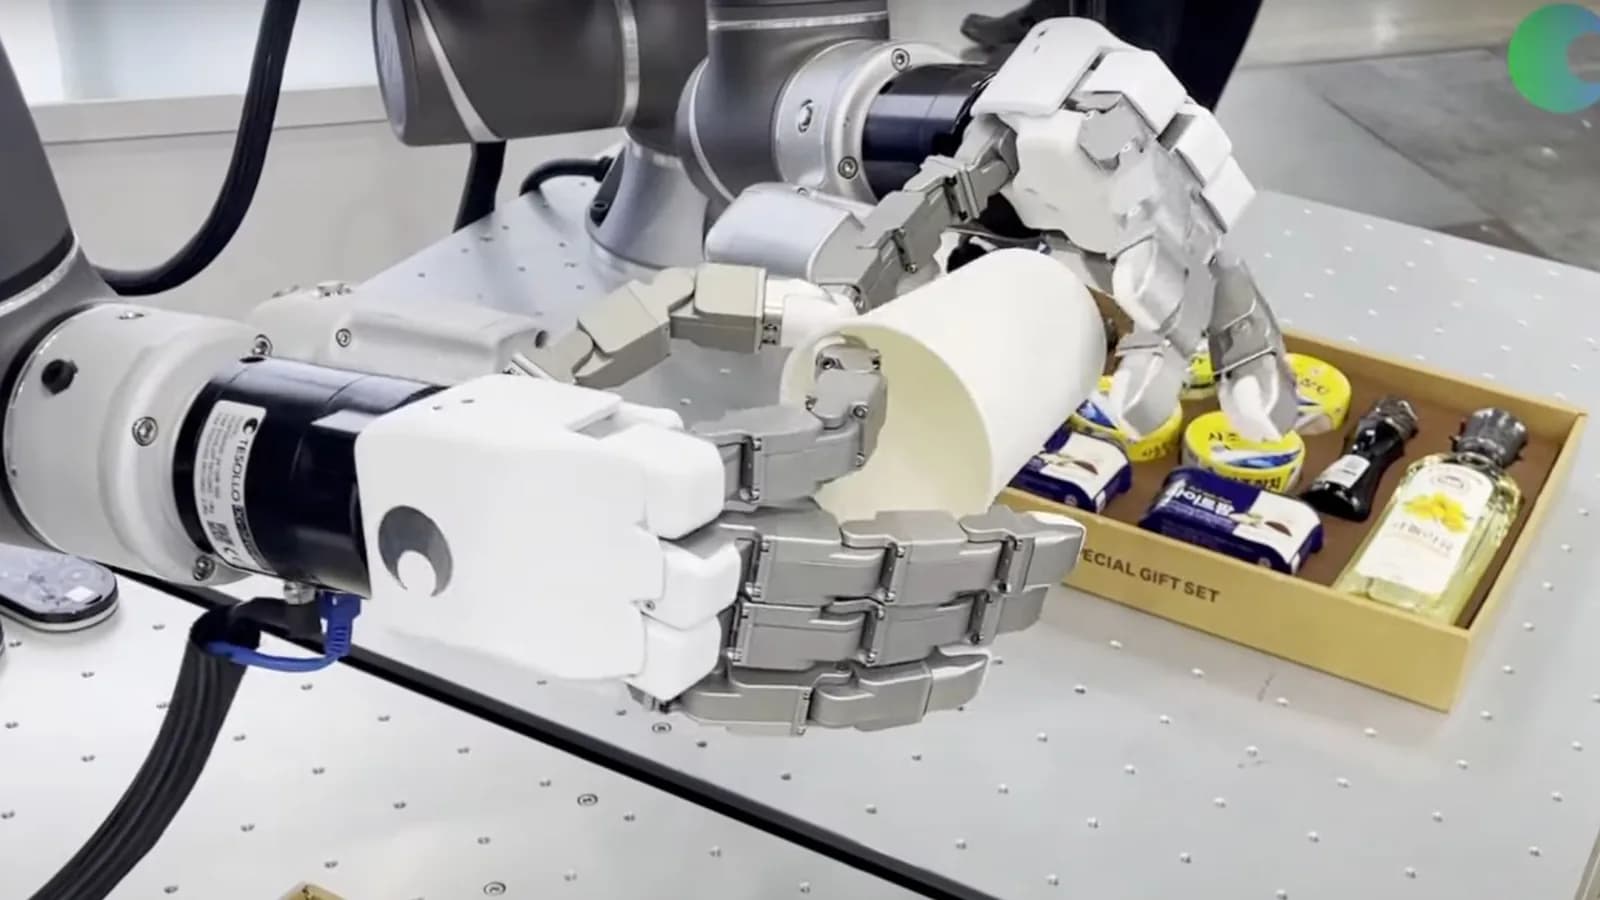
Conectaron las trayectorias de VFlash a un modelo de acción del mundo evaluado en MolmoSpaces, un banco de pruebas de manipulación robótica. El modelo logró una tasa de éxito promedio de 70,2% en cuatro grupos de tareas, contra 62,6% del sistema de base.
Las mayores mejoras aparecieron en las tareas de tomar y dejar objetos y en las de cerrar objetos, con alzas de 11,6 y 12,8 puntos porcentuales.
Fuera de la robótica, el método se probó en conducción autónoma con los conjuntos de datos NAVSIM y Waymo. Generó trayectorias de manejo con resultados competitivos en esos bancos de prueba, y el aprendizaje por refuerzo mejoró todavía más su planificación.
El trabajo se titula VFlash: Fast, Accurate Visual Planning via Flash Primitive Decoding y lo publicaron investigadores de NVIDIA junto a colaboradores en noviembre de 2026.