El grupo de trabajo de integración de aceleradores de PyTorch (Accelerator Integration Working Group) publicó el 5 de octubre en el blog del proyecto un resumen de lo que logró en el primer semestre de 2026. El grupo define cómo se conectan las arquitecturas de hardware nuevas al ecosistema abierto de IA, con mecanismos de integración neutrales frente a los fabricantes que evitan parches de código a medida y reducen la fragmentación. El balance cubre mejoras de infraestructura, flujos de pruebas unificados y backends de referencia en toda la plataforma.
Un ecosistema de hardware cada vez más diverso
El ecosistema de hardware de PyTorch sigue diversificándose, con más plataformas de cómputo de IA que adoptan la integración nativa con el framework. Esa adopción crea un problema común para la comunidad. Hay que simplificar los caminos de integración, bajar la complejidad, estandarizar los mecanismos y montar una infraestructura de validación confiable y unificada para plataformas heterogéneas.
Esa es la misión del Accelerator Integration Working Group. Con la vista puesta en un ecosistema de hardware escalable e inclusivo, colaboradores de distintas comunidades trabajan en mejoras al framework principal, herramientas compartidas e implementaciones de referencia estandarizadas.
En el primer semestre de 2026 el grupo avanzó en varios frentes. Reorganizó las suites de pruebas para que se reutilicen entre backends, creó el mecanismo Cross-Repository CI Relay (CRCR), sumó soporte de perfilado para backends basados en PrivateUse1, siguió madurando OpenReg como backend de referencia y avanzó en capacidades distribuidas, integración con backends de compilador, infraestructura de CI y paneles de visibilidad.
Cross-Repository CI Relay
Autores: Subin George, Jiahao Chen, Jiahao Tan, Jiawei Li y Jewel K. M.
Objetivos
La comunidad de PyTorch presentó Cross-Repository CI Relay (CRCR), un sistema nuevo que cierra una brecha de visibilidad que su ecosistema de integración continua arrastraba hace tiempo. PyTorch está al centro de una red grande de proyectos que dependen de él. Están los aceleradores, como Intel XPU, AMD ROCm, Apple MPS, Qualcomm AI Engine y varios integrados mediante el mecanismo PrivateUse1, y están las bibliotecas del ecosistema, como vLLM, SGLang y Hugging Face Transformers.
La CI propia de PyTorch es madura y extensa, pero corre dentro del repositorio pytorch/pytorch. Los repositorios que dependen de él no tenían una forma estándar de saber cuándo probar contra los cambios de arriba, de reportar resultados de vuelta ni de relacionar fallas entre proyectos. Eso generaba un problema de coordinación. Quien contribuía a PyTorch no podía saber si su PR afectaría a otros backends antes de integrarlo, y los responsables del hardware solo podían opinar cuando el cambio ya estaba hecho.
Beneficios
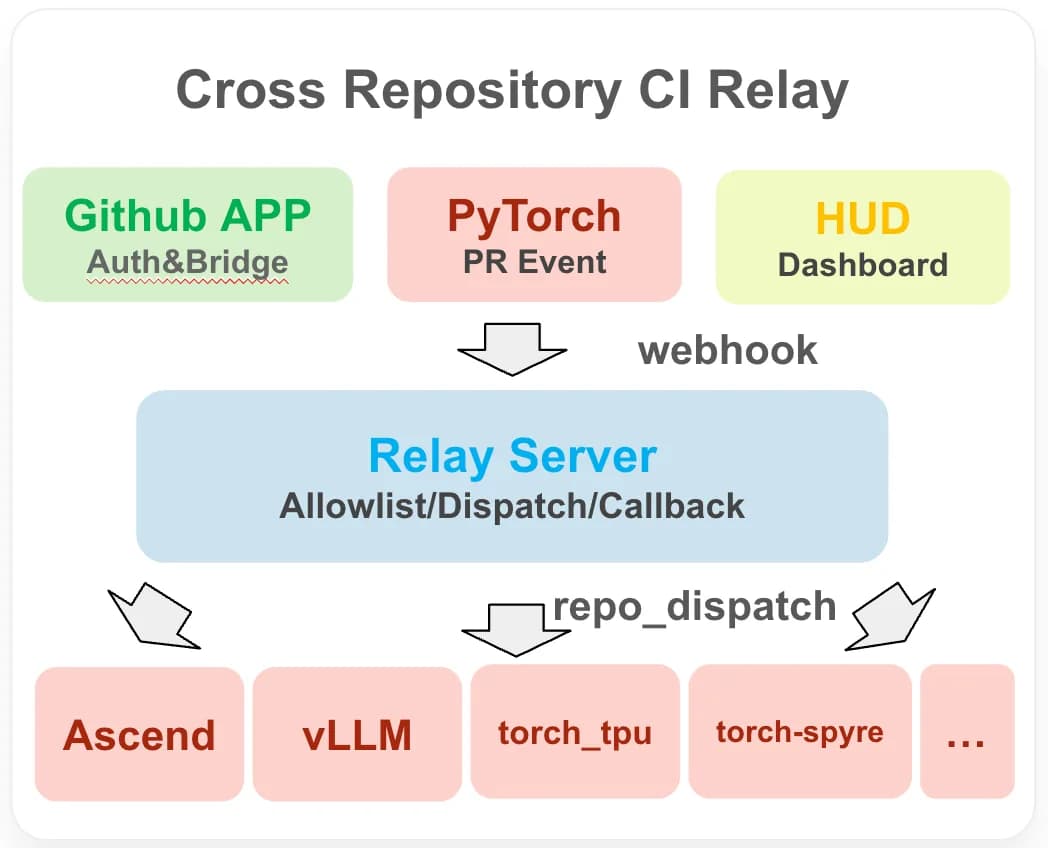
CRCR resuelve esto con un flujo totalmente automático. Cuando se abre un PR o se empuja un commit a pytorch/pytorch, un webhook dispara eventos en paralelo hacia todos los repositorios dependientes registrados.
Cada repositorio corre su propio flujo de CI y reporta el estado de vuelta mediante una llamada autenticada, con un token OIDC de GitHub que verifica criptográficamente la identidad del repositorio que llama. Los resultados llegan en segundos al panel de CI de PyTorch (hud.pytorch.org/crcr), y los responsables ven en un solo lugar la salud de la CI propia y la de los repositorios externos.
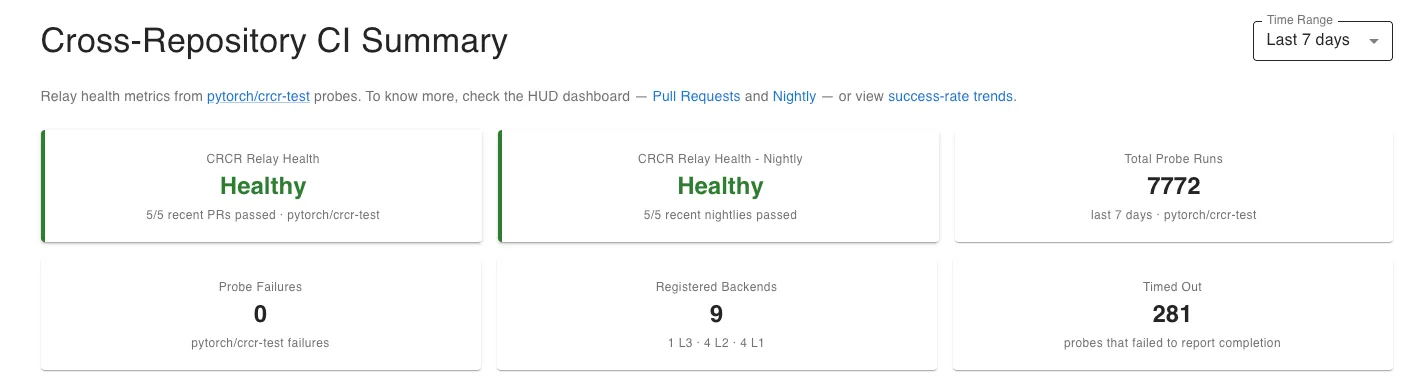
Figura 2. Panel de CRCR en el HUD.
El sistema usa una lista de autorización por niveles, con cuatro niveles de participación (L1 a L4). Un repositorio externo puede avanzar desde las simples notificaciones de despacho al reporte completo en el HUD, y de ahí a verificaciones que primero no bloquean y después sí bloquean los PR de PyTorch.
La seguridad descansa en cinco capas de validación. Verificación de identidad OIDC, autorización por lista, límite de tasa, chequeos de máquina de estados y separación estricta entre datos confiables y datos autorreportados. Así, incluso un repositorio externo comprometido solo puede alterar el estado de CI que se muestra para él mismo, no la infraestructura de compilación de PyTorch ni sus decisiones de integración. Sumarse exige poco a los responsables de cada repositorio, apenas una entrada en la lista de autorización y un archivo de flujo de trabajo liviano, sin código de autenticación propio.
Reorganización de las pruebas
Autores: Riya Punia, Tanmay Kumar, Jiahao Chen, Jiahao Tan y Jiawei Li
Objetivos
Validar un backend de acelerador nuevo contra la suite de pruebas de PyTorch es de las formas más efectivas de asegurar que la implementación es correcta y de detectar a tiempo los cambios de arriba. PyTorch mantiene más de 600.000 casos de prueba que cubren operadores, autograd, perfilado, entrenamiento distribuido y más. En teoría, cualquier backend podría aprovechar esa superficie de validación.
En la práctica, muchas de esas pruebas se escribieron para un grupo específico de aceleradores. Las cadenas de dispositivo, las actividades del perfilador, las API de memoria y los decoradores para saltar pruebas venían escritos a mano por todas partes, amarrando la lógica de las pruebas a backends concretos en vez de expresarla de forma independiente del dispositivo. Antes de esta reorganización, la única opción era mantener casos de prueba propios mediante parches. Cada actualización de PyTorch exigía mucho trabajo manual, y el ritmo de versiones más rápido de PyTorch empeoraba esa duplicación.
En el primer semestre de 2026 el grupo lanzó un esfuerzo sistemático para desacoplar la suite de pruebas de PyTorch del hardware específico. El trabajo se sigue en un issue central, un RFC sobre la reorganización de casos de prueba y un RFC sobre la clasificación de clases de prueba, con 259 elementos registrados en el proyecto de reorganización de pruebas de PyTorch.
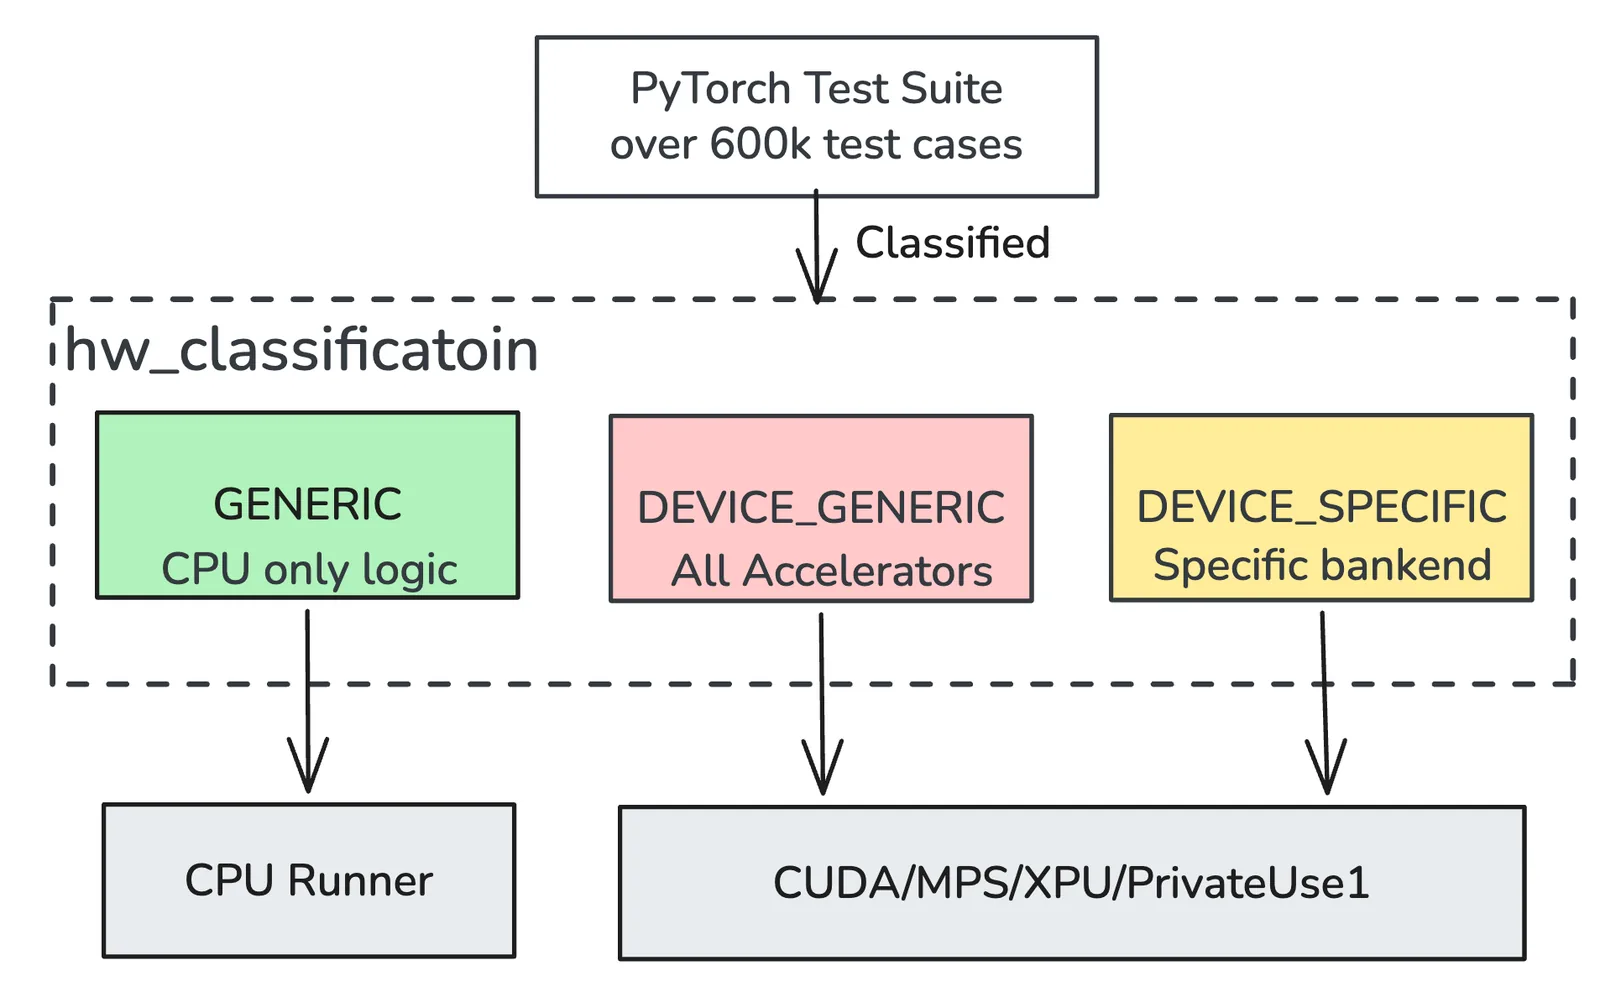
Figura 3. Arquitectura de la reorganización de pruebas.
El esfuerzo tiene tres frentes.
Migración a pruebas independientes del dispositivo. Se reemplazan las referencias fijas a un dispositivo (device="cuda", torch.cuda.synchronize(), @onlyCUDA) por equivalentes parametrizados (device=device, getattr(torch, device.type), instantiate_device_type_tests()). Cada clase de prueba se clasifica como ajena al acelerador (solo CPU, para funciones genéricas como el Dispatcher), agnóstica al acelerador (parametrizada por dispositivo, corre en todos los backends) o específica de un acelerador (atada a las API internas de un backend). Durante el semestre, los colaboradores migraron más de 276 archivos de prueba que abarcan dynamo, el perfilador, los módulos nn, linalg, los optimizadores, las convoluciones, la serialización, el multiprocesamiento y el dataloader.
Metadatos de clasificación por hardware. A partir de la clasificación de clases de prueba que propuso Alban, el grupo implementó un atributo de clase hw_classification (GENERIC, DEVICE_GENERIC, CUDA, XPU, MPS) y una opción --hw-classification en todos los caminos de ejecución (unittest, pytest, subprocesos, ejecución en paralelo, salida XML y el reenvío de run_test.py). Con eso, cada ejecutor de CI elige solo el subconjunto de pruebas que corresponde a su hardware.
Barreras en la CI. Un linter HW_CLASSIFICATION obliga a que cada clase de prueba nueva declare su clasificación. Los archivos que todavía no la tienen (1.191 al lanzarlo) quedaron en una lista de excepción que se va vaciando de a poco, con el despliegue por fases acordado con los responsables de PyTorch. Más adelante se planea una capa de linter con IA para hacer cumplir casos más finos.
Beneficios
Para quien desarrolla un acelerador, estos cambios dan vuelta la experiencia de incorporarse. En vez de parchar decenas de archivos de prueba para adaptarlos a su hardware, los fabricantes pueden usar instantiate_device_type_tests() para generar de forma automática las variantes de prueba de su backend. Pruebas que antes eran invisibles para los backends que no son CUDA, porque estaban detrás de @onlyCUDA o tenían device="cuda" escrito a mano, ahora corren en cualquier acelerador registrado. Una sola prueba independiente del dispositivo produce configuraciones validadas a la vez para los backends CUDA, MPS, XPU, ROCm y PrivateUse1.
Para el propio proyecto, el sistema hw_classification es la base de infraestructura para agregar metadatos de hardware y de frecuencia por clase, con el fin de reducir pruebas duplicadas, mejorar la visibilidad de la CI y ordenar la programación de pruebas. La migración hecha en el semestre, que dejó las pruebas en clases bien clasificadas, es un requisito previo estricto de ese plan.
Para el ecosistema en general, el mecanismo de omisión de pruebas en varios niveles (por función, clase, prueba y operador), sumado a la clasificación por hardware, les da a los fabricantes de backends un control fino sobre qué pruebas correr y cuáles saltar según la madurez de su implementación, sin tocar el código de pruebas de PyTorch.
Próximos pasos
En el segundo semestre la prioridad es llevar a cero la lista de excepción de archivos sin clasificar, extender la cobertura independiente del dispositivo a los módulos distributed, JIT y autograd, y conectar hw_classification con la programación de la CI para que cada ejecutor elija sus pruebas solo. El grupo también estudia un registro declarativo de capacidades por operador, donde cada acelerador declare los tipos de datos que soporta y sus ajustes de precisión sin modificar las entradas de OpInfo de PyTorch.
Perfilado
Autores: Vishal Goyal y Anisha Kushwaha
Objetivos
Integrar un acelerador nuevo con el perfilado de PyTorch exige más que medir tiempos por operador. Los fabricantes necesitan un contrato claro para las líneas de tiempo a nivel de kernel, los eventos de memoria y de ejecución, y la correlación entre CPU y dispositivo en las trazas de Chrome y Perfetto.
Sin una referencia externa que funcione, quien desarrolla un backend tiene dos opciones incompletas. Una es el camino antiguo de ProfilerStubs y KINETO_PRIVATEUSE1_FALLBACK, que solo registra un tiempo de dispositivo grueso por operador. La otra es hacer ingeniería inversa de los plugins de Kineto que viven dentro del árbol, como CUPTI y XPUPTI, que mezclan herramientas propias de cada fabricante con los patrones de integración.
En el primer semestre de 2026, el perfilado siguió el enfoque mínimo de OpenReg. El resultado es lo justo para mostrar cómo funciona la integración, y no está pensado como perfilador de producción. El trabajo se apoya en la API de registro del núcleo de PyTorch (REGISTER_PRIVATEUSE1_PROFILER), que permite a los backends externos conectar un IActivityProfiler a Kineto sin más cambios en PyTorch ni en Kineto. Sobre esa base, el grupo integró una pila de referencia de OpenReg (un trazador más IActivityProfiler y su sesión, RFC #177978) que cubre el ciclo de vida de la sesión, los tipos de actividad y los identificadores de correlación. La respaldó con pruebas de extremo a extremo del ciclo de vida de la sesión y del camino de respaldo usando torch.profiler, y con documentación tanto para el camino antiguo como para el de plugins de Kineto.