Interconnects publicó las notas que preparó para una sesión informativa con legisladores y asesores del Congreso de Estados Unidos sobre el estado de los modelos de pesos abiertos frente a China. Su autor trabajó dos años y medio en el Instituto Allen de IA, donde ayudó a construir los modelos Olmo.
Qué es un modelo abierto y qué es uno cerrado
Los modelos de lenguaje abiertos son aquellos cuyos pesos están disponibles públicamente para inspección o para uso posterior. Se contrastan con los modelos cerrados, que se ofrecen solo a través de interfaces de programación que un desarrollador puede consultar directamente, como GPT-4 o Claude Opus 4.5, o a través de productos como ChatGPT y Claude Code.
Dentro de los abiertos hay dos grupos. Los de pesos abiertos son la forma más común e incluyen a Llama de Meta, Qwen de Alibaba, Gemma de Google y los modelos de DeepSeek. Se rigen por licencias, documentos que dictan qué se permite hacer con ellos, y suelen venir acompañados de código de inferencia en bibliotecas como Transformers, VLLM o SGLANG. Desde abril de 2025, más o menos, las empresas chinas de IA son las líderes claras en esta categoría.
Los modelos de código abierto de verdad agregan una parte más. Traen los pesos, las licencias y el código de inferencia, y además toda la información necesaria para reproducir el modelo, o sea el código de entrenamiento y los datos de entrenamiento. Los más prominentes se construyeron en Estados Unidos, encabezados por los modelos Olmo del Instituto Allen de IA. Los otros también salen de organizaciones sin fines de lucro estadounidenses, los Marin de OpenAthena y los Pythia de EleutherAI.
Las etiquetas funcionan como un espectro y no como cajones. Los modelos Nemotron de Nvidia son mucho más abiertos que la mayoría de los de pesos abiertos, porque liberan grandes cantidades de sus datos de entrenamiento bajo licencias permisivas, pero no llegan a ser de código abierto completo porque no liberan todos los datos. Los cerrados también viven en un espectro, según lo que revela la interfaz y según los términos de uso.
¿Cuánta ventaja tienen hoy los modelos chinos?
GLM-5.2 y Kimi K3, dos de los últimos modelos chinos de punta, produjeron un cambio de escalón en la viabilidad comercial de los modelos abiertos. Cruzaron en capacidades agénticas un umbral parecido al que cruzó Claude Code de Anthropic en diciembre de 2025.
Estados Unidos fue el líder temprano en modelos de lenguaje abiertos, sobre todo con los Llama de Meta, que se usaron de forma extensa en investigación y en tareas comerciales. Los modelos chinos de pesos abiertos los superaron en estas dos áreas hace unos 18 meses. La métrica que lo muestra son las descargas en Hugging Face, donde China tomó la delantera en julio de 2025 gracias al éxito de los Qwen de Alibaba.
Desde que el autor publicó el proyecto ATOM en agosto de 2025, la ventaja china en descargas creció a unos 1.600 millones, con un total de 3.200 millones de descargas, el doble del total estadounidense.
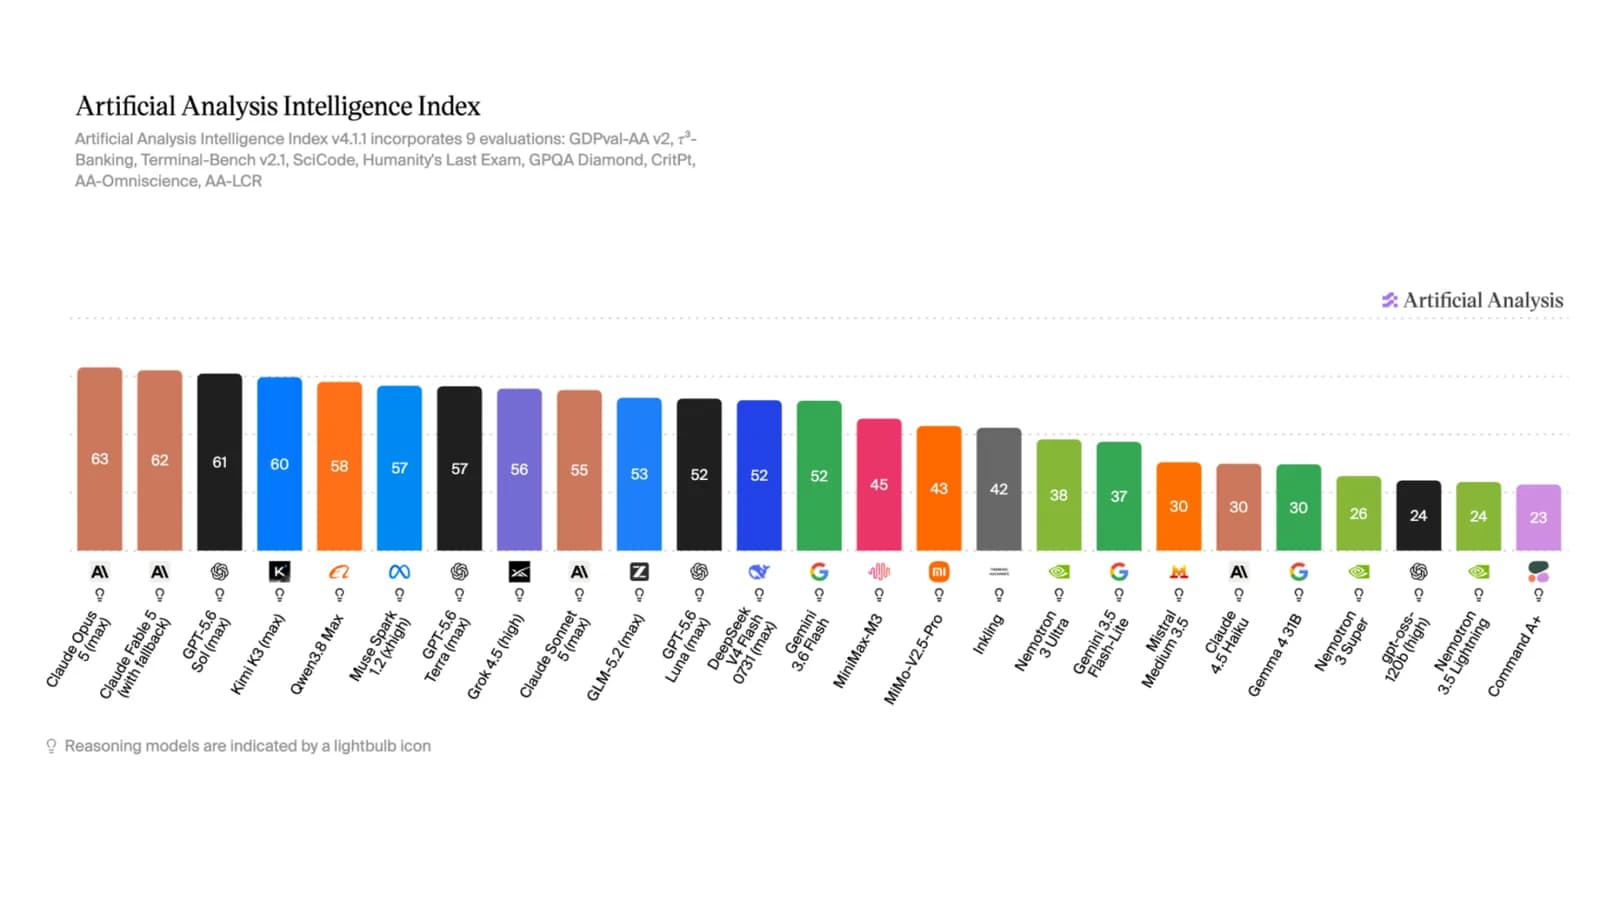
En los índices de capacidad la distancia también se ve. Al 14 de septiembre de 2026, los tres primeros del Artificial Analysis Intelligence Index son chinos.
| Modelo | Empresa | Puntaje |
|---|---|---|
| GLM-5.3 | Z.ai | 45 |
| Kimi K3 | Moonshot AI | 44 |
| GLM-5.3-Flash | Z.ai | 42 |
| Inkling | Thinking Machines | 26 |
| Inkling Small | Thinking Machines | 26 |
| Nemotron 3 Ultra | Nvidia | 23 |
Los mejores modelos estadounidenses de la tabla se lanzaron en junio y julio de 2026, y se actualizan con menos frecuencia que sus contrapartes chinas. Los laboratorios chinos habían publicado modelos por encima de esos puntajes entre dos y seis meses antes de que las empresas estadounidenses llegaran ahí, con GLM-5 o con DeepSeek V4 Pro. Hay una tendencia a que más empresas estadounidenses publiquen modelos, con nombres como Arcee AI, Poolside e IBM, pero no están cerrando la brecha con rapidez. Otras pruebas cuentan una historia parecida.
Sumado todo, los modelos chinos de pesos abiertos están entre dos y cinco meses detrás de la frontera cerrada estadounidense. Los modelos estadounidenses de pesos abiertos están entre seis y nueve meses detrás de OpenAI y Anthropic. Los laboratorios chinos aparecen más cerca en tareas con demanda clara de usuarios, como la programación agéntica, y más lejos en tareas científicas abiertas como física o biología.
¿Por qué rinden tanto con menos recursos?
Sigue siendo un debate abierto, influido en buena parte por culturas de trabajo distintas, y también por algunos factores técnicos. Los laboratorios chinos publican sus modelos más rápido y se concentran en una distribución de tareas algo más estrecha, lo que los favorece un poco en las pruebas públicas. Publicar rápido ayuda a puntuar mejor porque todos los laboratorios avanzan de forma sostenida, así que un modelo terminado es una foto del rendimiento en ese momento, y los laboratorios que llegan más tarde tienden a puntuar más alto.
Aun así, los modelos que construyen los laboratorios chinos son genuinamente fuertes y representan competencia real para la industria estadounidense. Esa competencia no va a disminuir de forma apreciable a medida que los laboratorios cerrados tapen las vulnerabilidades de sus interfaces que habilitan la destilación.
La destilación pesa más en dominios nuevos y no vuelve trivial construir un modelo final fuerte en todo. El autor estima que si se impidiera por completo, por ejemplo con herramientas de identificación de clientes en Anthropic y en OpenAI, la brecha entre los modelos estadounidenses más fuertes y los chinos de pesos abiertos crecería solo entre uno y dos meses.
Hay otro cambio en curso. Los laboratorios chinos están modificando rápido su postura sobre pagar por datos de entrenamiento durante 2026. A comienzos de año, los principales, entre ellos Moonshot AI y Z.ai, preferían con fuerza armar sus flujos de datos en casa. Para el verano ya habían empezado a comprar datos de punta, entornos de aprendizaje por refuerzo difíciles para tareas agénticas, tanto a empresas estadounidenses establecidas como a startups chinas nuevas.
El riesgo no se resuelve cerrando la puerta
Con el avance de los modelos chinos de pesos abiertos hacia la frontera de capacidades, y con los riesgos crecientes que se documentaron en áreas como ciberseguridad, aumentó la incertidumbre regulatoria sobre cómo las publicaciones sucesivas pueden habilitar un ecosistema más seguro. El incidente entre OpenAI y Hugging Face es el caso que lo puso sobre la mesa.
El desafío estructural es que hay pocos métodos efectivos para impedir que una pieza de software abierto llegue a un actor malicioso. Si se intentara restringir el acceso a los modelos chinos de pesos abiertos más fuertes porque amplifican riesgos, los perjudicados serían las empresas estadounidenses.
Ya existe un ejemplo. Hugging Face usó un modelo chino de pesos abiertos para entender el ciberataque que sufrió, porque los modelos cerrados no respondían a sus consultas. Por eso gestionar los riesgos de los modelos de pesos abiertos suele terminar dependiendo de la preparación del ecosistema.
El argumento del informe es que los modelos de pesos abiertos se están volviendo una herramienta central para la difusión de la IA, y que el mejor camino para adelantarse a estos riesgos y a las relaciones desbalanceadas donde las empresas estadounidenses dependen de modelos construidos en China pasa por seguir habilitando inversión en modelos abiertos dentro de Estados Unidos. Tener modelos propios permite coordinar y preparar riesgos que son globales por naturaleza, y al mismo tiempo acelera la llegada de servicios de IA a la economía interna.
¿Quién está usando estos modelos?
Los modelos de lenguaje de pesos abiertos crecieron bastante en interés general y en viabilidad económica durante 2026, lo que permite comparar de forma más directa la adopción de modelos estadounidenses, chinos o de otros orígenes, por encima de las métricas de Hugging Face.
Un ejemplo es el uso en OpenRouter, una plataforma de inferencia popular que entrega una sola interfaz para cambiar entre modelos abiertos y cerrados, de Estados Unidos y de China. Se la conoce sobre todo por probar distintos modelos de pesos abiertos. La plataforma publica datos de uso de los modelos más usados desde el 1 de enero de 2025, y ahí se ve el crecimiento desde cerca de 1 billón de tokens procesados de modelos abiertos en una semana de septiembre de 2025 hasta unos 80 billones de tokens por semana hoy. En ese lapso, los modelos chinos pasaron de cerca del 70% de participación a más del 80% del uso.
Otras plataformas pensadas para comercializar modelos abiertos muestran datos parecidos. El agente de programación de código abierto OpenCode muestra un volumen de inferencia de 95% o más con modelos chinos.
Estas plataformas abiertas son la mejor aproximación disponible al uso real de modelos abiertos. Una proporción grande de ese uso ocurre en plataformas que no publican el desglose por modelo, como Together AI o Fireworks AI, y en despliegues privados de aplicaciones empresariales.
Varias empresas de tecnología y startups conocidas construyeron sus funciones de IA sobre modelos chinos de pesos abiertos. Entre ellas Harvey, el agente legal, Cursor, el agente de programación, el uso de los modelos Kimi por parte de DoorDash, el uso de Qwen por parte de Airbnb y el uso de DeepSeek por parte de Perplexity. Son la punta del iceberg, porque una franja amplia de startups jóvenes de Silicon Valley construye sobre modelos chinos para tener opciones flexibles y de bajo costo.
Hay además una tendencia creciente de empresas estadounidenses que firman acuerdos empresariales con laboratorios chinos para conseguir permiso de usar sus modelos dentro de sus productos. El autor la describe como una forma nueva de colaboración tecnológica transfronteriza que no había visto en su carrera.
La base se extiende más adentro del ecosistema. En una primera aproximación, la mayor parte de la investigación académica se hace sobre la familia Qwen de Alibaba. El autor cuenta que conoció a varios miembros del equipo de liderazgo de Qwen durante su viaje a China, y que están muy interesados en ese tipo de adopción y son deliberados al respecto, algo que no va a ser fácil de recuperar para los modelos estadounidenses.