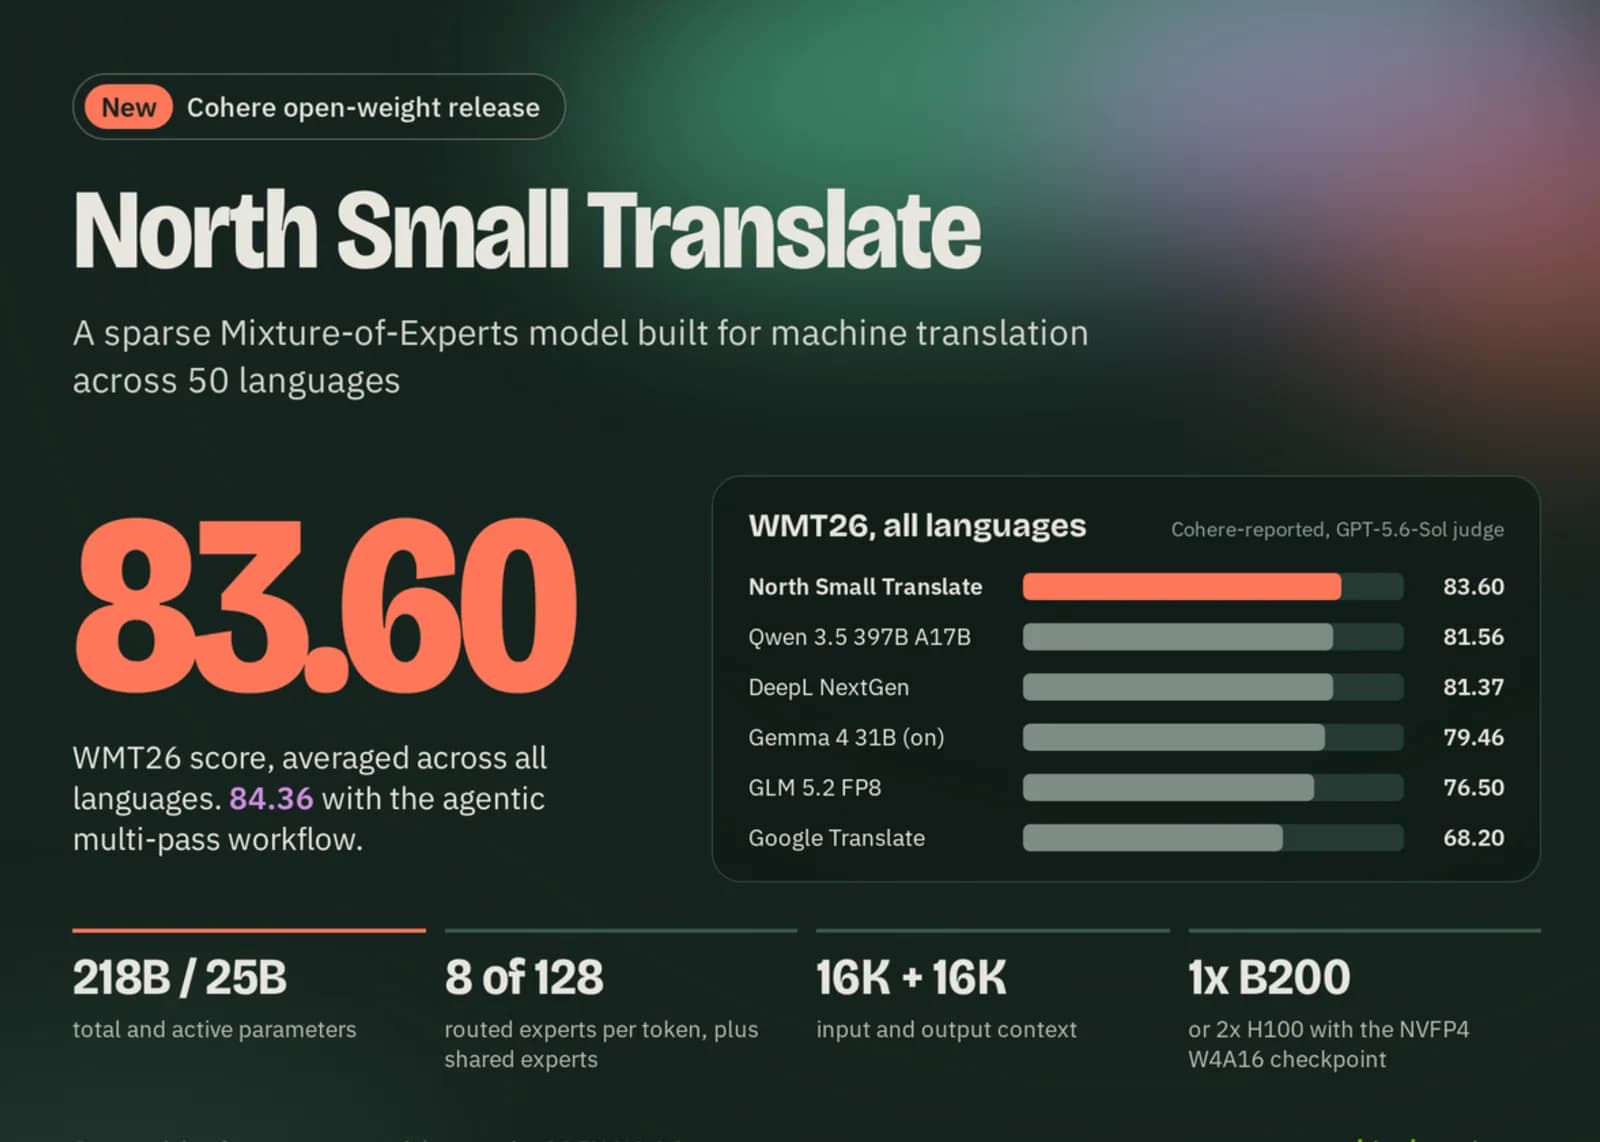
Cohere liberó North Small Translate, un modelo de traducción automática de pesos abiertos desarrollado por la compañía y Cohere Labs. Es un modelo disperso de mezcla de expertos, conocido como MoE, con 218.000 millones de parámetros totales y 25.000 millones activos. Cubre 50 idiomas, desde el albanés hasta el vietnamita. En la evaluación WMT26 de la propia Cohere obtiene 83,6 puntos promediados sobre todos los idiomas. La empresa afirma que eso supera a DeepL y Google Translate, además de opciones abiertas como GLM 5.2 y Mistral Large 3.
¿Es desplegable? Sí. Se puede llamar gratis desde la API de Cohere hasta los límites de tasa, alojar por cuenta propia con fines no comerciales, o licenciar para uso comercial.
Volver al problema donde empezó el Transformer
Investigadores de Google presentaron el Transformer en 2017 con Attention Is All You Need. Sus resultados principales venían de las tareas de traducción inglés-alemán e inglés-francés de WMT 2014. Nueve años después, Cohere regresa a ese problema original con un modelo dedicado. Su anuncio de lanzamiento plantea la traducción como un asunto de soberanía: las organizaciones que no pueden comunicarse globalmente no pueden mantenerse soberanas.
North Small Translate es el primer modelo de traducción de la familia North de Cohere. Sigue a Tiny Aya y Command A Translate en el linaje multilingüe de la compañía. Fue construido junto a RWS, cuyos científicos y expertos en lenguaje de Language Weaver moldearon su calidad en escenarios reales.
¿Cómo está armado por dentro?
La estructura del modelo describe un Transformer decodificador con MoE disperso. Los detalles clave:
- Expertos: 128 en total, 8 activados por token, más expertos compartidos que se aplican a cada token.
- Enrutador: una función sigmoide sobre los logits de los expertos, normalizada sobre el top-k seleccionado.
- Atención: capas con ventana deslizante de 4096 y RoPE, alternadas con capas globales sin codificación posicional, en proporción 3 a 1.
- Linaje: esa disposición de atención se introdujo por primera vez en Command A.
- Contexto: 16K tokens de entrada y 16K de salida, solo texto.
- Entrenamiento: post-entrenado específicamente para calidad de traducción.
Cerca del 11,5% de los pesos queda activo por token. El cómputo por token sigue a los 25.000 millones de parámetros activos, pero la memoria igual tiene que sostener los 218.000 millones completos. Ahí está la trampa del formato disperso: es barato de correr, caro de alojar.
Velocidad, documentos largos y costo
En las pruebas de Cohere, el modelo produjo 112 tokens de salida por segundo contra 81 de Gemma 4 31B, en baja concurrencia y sobre hardware idéntico. En alta concurrencia las cifras fueron 39 contra 30. Cohere lo describe como hasta 1,4 veces más rendimiento.
Los documentos largos son un punto más fuerte. El modelo obtiene 48,9 al traducir dos capítulos de libro en una sola llamada. Google Translate obtiene 21,3 y Gemma 4 31B llega a 19,4. La calidad se mide por párrafo con xCOMET-XL.
| Modelo | Costo por tarea (USD) |
|---|---|
| North Small Translate | 0,000676 |
| Qwen 3.5 397B A17B | 0,004525 |
| Command A+ | 0,005158 |
| Gemini 3.1 Pro Preview (alto) | 0,038928 |
Con un promedio de 661 tokens por tarea, la diferencia frente a Gemini 3.1 Pro es de 58 veces. Llevado a volumen: un millón de tareas costarían unos 676 dólares con North Small Translate y cerca de 38.900 dólares con la alternativa más cara de la tabla. Para una agencia de traducción o un medio regional que procese catálogos completos, esa brecha decide qué se automatiza y qué no.
Regionalmente, ambas versiones superan a Gemma 4 31B en Europa: en idiomas de la Unión Europea el modelo estándar marca 82,17 contra 72,73 de Gemma. En el sur de Asia la comparación se estrecha y se da vuelta, con 86,16 para North contra 88,04 de Gemma.
La advertencia que hay que leer
La variante agéntica corre un flujo de múltiples pasadas que encuentra y corrige sus propios errores, y llega a 84,36. Las bandas de puntuación de Cohere tratan el rango de 80 a 100 como traducción perfecta o con errores menores.
Hay un reparo que importa: estas son corridas de la propia Cohere, con GPT-5.6-Sol actuando como juez. Conviene tratarlas como cifras declaradas por el proveedor hasta que aparezcan resultados independientes de WMT26.
¿Cómo se ejecuta?
El camino más rápido es la API Chat V2 de Cohere, donde el modelo es gratuito hasta los límites de tasa:
from cohere import ClientV2

co = ClientV2(api_key="<TU_API_KEY>")
response = co.chat(
    model="north-small-translate-1-0",
    messages=[{"role": "user",
               "content": "Traduce al francés todo lo que sigue:\n\nLas empresas necesitan traducciones precisas de documentos críticos."}],
)
print(response.message.content[0].text)
Para alojamiento propio, Cohere publica tres puntos de control, los mismos que sirve en producción. El de 4 bits corre sobre una B200 o dos H100. Ese requisito es coherente con la aritmética: 218.000 millones de parámetros a medio byte cada uno dan alrededor de 109 GB solo de pesos, que no caben en una tarjeta de 80 GB pero sí en dos.