Google lanzó EmbeddingGemma 2, un modelo abierto que convierte texto, imágenes, video, audio y código en vectores numéricos, para que el contenido parecido se pueda encontrar y comparar con más facilidad. Lo informó The Decoder el 6 de octubre.
Con 740 millones de parámetros, Google dice que es el modelo más compacto de su tipo y que supera a modelos competidores de hasta el doble de su tamaño en los benchmarks de embeddings multimodales.
¿Cuánto mejora frente a la primera versión?
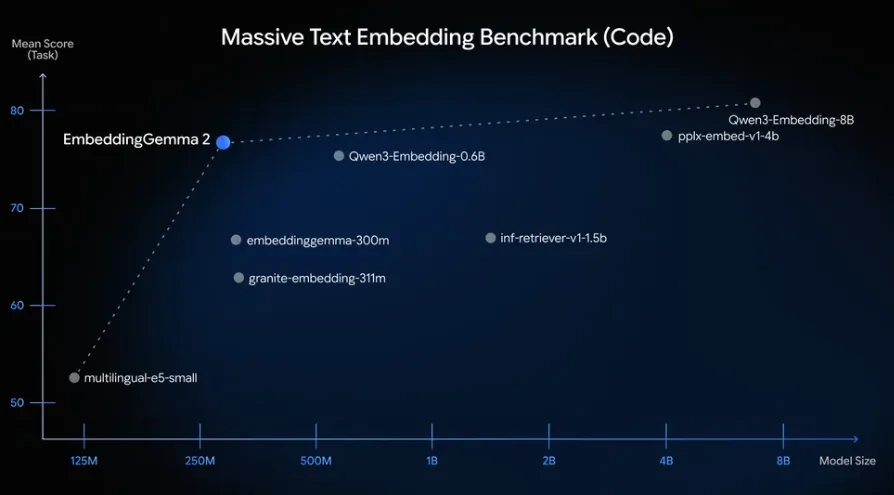
EmbeddingGemma 2 obtiene 78,68 puntos en el Massive Text Embedding Benchmark en su apartado de código (MTEB Code), un salto de casi 10 puntos sobre su antecesor, que marcaba 68,76. Con ese resultado queda a la par de modelos mucho más grandes, según el gráfico que publicó Google.
¿Qué se necesita para correrlo?
El modelo funciona en local y sin clave de API. Cada consulta tarda entre 20 y 70 milisegundos usando WebGPU dentro del navegador. Necesita solo unos 191 MB de RAM y reduce hasta seis veces el espacio que ocupa una base de datos vectorial local. Para tareas que son solo de texto alcanza con una versión de 270 millones de parámetros.
Combinado con modelos abiertos pequeños como Gemma 4, EmbeddingGemma 2 permite armar aplicaciones de RAG (generación aumentada por recuperación) que funcionan sin conexión, sin enviar datos a servidores externos. La búsqueda y la recuperación de documentos ocurren en el mismo equipo del usuario.
Los pesos están disponibles en Hugging Face y Kaggle, junto con una guía para desarrolladores y la documentación del modelo.