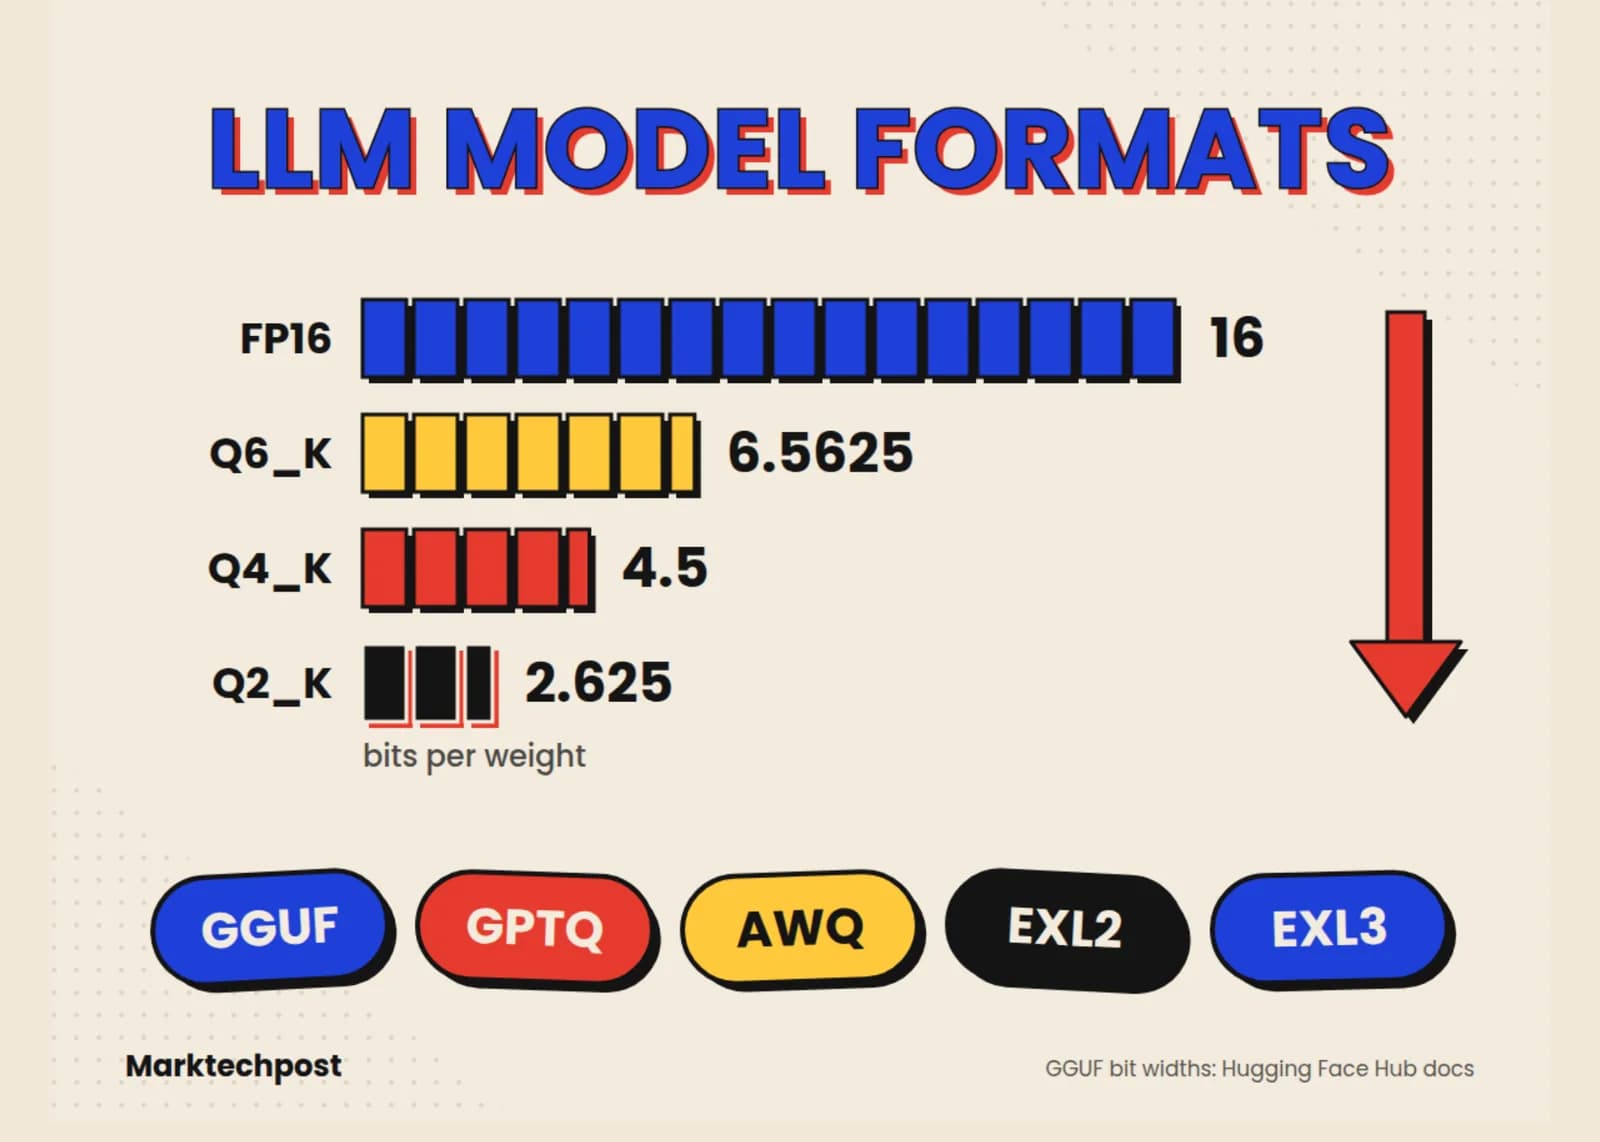
La mayor parte de la confusión con los formatos de modelos viene de mezclar dos capas.
Un contenedor define cómo se guardan los tensores en el disco. Un método de cuantización define cómo se aprietan los pesos en menos bits.
- Contenedores, safetensors, GGUF y el pickle de PyTorch (
.biny.pt). - Métodos, GPTQ, AWQ, NF4 de bitsandbytes, y los K-quants e I-quants de llama.cpp.
- Las dos cosas a la vez, EXL2 y EXL3 son un método más una disposición de almacenamiento atada a una sola biblioteca de inferencia.
Para la memoria hay una regla rápida. La memoria de los pesos es aproximadamente los parámetros por los bits por peso, dividido en 8. Es aritmética, no el benchmark de un proveedor, y cubre solo los pesos. La caché KV y el gasto del propio motor suman aparte.
Precisión completa, safetensors y el .bin de PyTorch
Los modelos sin cuantizar suelen distribuirse con pesos de 16 bits, sea en pytorch_model.bin o en model.safetensors.
Los archivos .bin y .pt, los más antiguos, usan el pickle de Python. Cargar un pickle puede ejecutar código arbitrario, así que un punto de control de origen desconocido es un riesgo de seguridad.
Safetensors, creado en Hugging Face, saca ese riesgo del medio. El archivo es una cabecera JSON chica más los búferes de tensores en crudo, sin nada ejecutable adentro. Los tensores se pueden mapear en memoria y cargar de a uno, sin leer el archivo completo. Hoy safetensors figura como proyecto de la PyTorch Foundation.
Hay un matiz que conviene tener claro. La mayoría de los modelos GPTQ, AWQ, EXL2, EXL3 y MLX también se guardan en archivos .safetensors. La cuantización vive en el contenido de los tensores y en un archivo de configuración, no en un contenedor nuevo.
¿Qué es GGUF y por qué reemplazó a GGML?
GGUF es un formato binario para correr modelos con GGML y con los ejecutores basados en GGML, como llama.cpp. Lo creó Georgi Gerganov, que también lidera llama.cpp, según la documentación de Hugging Face. Se presentó el 21 de agosto de 2023 como reemplazo del formato GGML anterior.
Los archivos GGML, GGMF y GGJT no podían declarar a qué arquitectura pertenecía un modelo. Agregar un hiperparámetro nuevo rompía todos los archivos existentes. GGUF cambió a metadatos tipados de clave y valor, así los campos nuevos entran sin romper los archivos viejos.
La especificación lista cinco objetivos, despliegue en un solo archivo, extensibilidad, compatibilidad con mmap, carga simple e información completa dentro del archivo. A diferencia de los formatos que solo guardan tensores, GGUF puede llevar el tokenizador, los tokens especiales y una plantilla de chat en Jinja junto a los pesos.
Cómo se lee el nombre de un GGUF
El sufijo de un nombre como Q4_K_M.gguf indica el esquema.
La cuenta del Q4_K sale así. Un superbloque guarda 256 pesos. Esos 256 por 4 bits dan 1.024 bits. Se suman 8 bloques por 12 bits de escalas y mínimos, o sea 96 bits. Se suma una superescala de 16 bits y un supermínimo de 16 bits, otros 32 bits. El total es 1.152 dividido en 256, es decir 4,5 bits por peso.
Las letras _S, _M y _L marcan mezclas. Ninguna de las tres es un tipo nuevo. llama.cpp describe el Q4_K_M como el uso de Q6_K para la mitad de los tensores attention.wv y feed_forward.w2, y Q4_K en el resto, según la documentación de Unsloth. Por eso un archivo Q4_K_M promedia algo más de 4,5 bits por peso.
La tabla de Hugging Face también lista TQ1_0 y TQ2_0 para pesos ternarios, y MXFP4, un tipo de punto flotante de 4 bits con microescalado. Una rareza de etiquetado: Hugging Face archiva el Q8_0 entre los tipos heredados, aunque en la práctica el Q8_0 sigue siendo la opción GGUF estándar cuando se busca no perder calidad.
La matriz de importancia
La cuantización GGUF puede usar datos de calibración. La herramienta llama-imatrix de llama.cpp calcula una matriz de importancia a partir de un archivo de texto, y después llama-quantize --imatrix la aprovecha para mejorar la calidad. Para las mezclas de 1 y 2 bits, llama-quantize avisa si no se le entrega una imatrix.
La especificación define el nombre de archivo con el nombre base, la etiqueta de tamaño, el ajuste fino, la versión, la codificación, el tipo y el fragmento. Los fragmentos usan un contador de cinco dígitos, tipo 00003-of-00009. Los prefijos opcionales mmproj- y mtp- marcan proyectores de visión y módulos borrador de predicción de varios tokens.
GGUF es nativo de llama.cpp y su entorno. Hugging Face documenta su uso con llama.cpp, LM Studio, GPT4All y Ollama. En vLLM el soporte existe pero es limitado, el propio proyecto lo califica de experimental y poco optimizado, y hoy requiere el complemento externo vllm-gguf-plugin.
GPTQ, redondeo con información de segundo orden
GPTQ lo escribieron Elias Frantar (IST Austria), Saleh Ashkboos y Torsten Hoefler (ETH Zúrich), y Dan Alistarh (IST Austria y Neural Magic). Apareció en arXiv el 31 de octubre de 2022 y se publicó en ICLR 2023.
Es un método de cuantización de pesos posterior al entrenamiento, de una sola pasada. Usa información aproximada de segundo orden, la Hessiana, para decidir cómo redondear cada peso. El error de redondeo de una columna se compensa ajustando los pesos que todavía no se cuantizan. Necesita un conjunto de calibración chico, pero no reentrenamiento.
- Cuantizó modelos de 175.000 millones de parámetros en cerca de 4 horas de GPU, hasta 3 o 4 bits por peso, según el artículo en arXiv.
- Los autores reportan pérdida de exactitud despreciable en esos anchos de bits.
- La aceleración de punta a punta contra FP16 es de cerca de 3,25 veces en una NVIDIA A100 y 4,5 veces en una A6000, según la ficha del paper en Hugging Face.
Los repositorios GPTQ suelen traer GPTQ en el nombre, o etiquetas como 4bit-128g. El tamaño de grupo (128g) significa una escala cada 128 pesos, y los grupos más chicos mejoran la exactitud a cambio de un poco más de tamaño. El orden por activación (desc_act) cuantiza las columnas por orden de importancia, lo que en general mejora la exactitud.
En 2026 el estado de las herramientas cambió. La biblioteca original AutoGPTQ ya no tiene mantención. GPTQModel declara haber reemplazado por completo a AutoGPTQ y AutoAWQ en Transformers, Optimum y PEFT, y su salida corre en Transformers, vLLM y SGLang. llm-compressor también implementa GPTQ, aunque guarda el resultado en el formato compressed-tensors. Hugging Face estima la calibración GPTQ de un modelo de 8B en unos 20 minutos sobre una A100.
¿Qué hace distinto a AWQ?
AWQ, por cuantización de pesos consciente de las activaciones, viene del grupo de Song Han en el MIT. Apareció en arXiv el 1 de junio de 2023 y ganó el premio al mejor artículo de MLSys 2024.
La idea de fondo es que no todos los pesos importan igual. Proteger alrededor del 1% de los pesos salientes reduce con fuerza el error de cuantización. El giro de AWQ es que encuentra esos canales mirando la magnitud de las activaciones, no la de los pesos.
Tampoco los guarda con más precisión. Los escala hacia arriba mediante una transformación matemáticamente equivalente, y así mantiene un formato uniforme y amable con el hardware. AWQ no usa retropropagación ni reconstrucción, por lo que tiene menos probabilidad de sobreajustarse a su conjunto de calibración.
El motor TinyChat del propio paper corrió más de 3 veces más rápido que la implementación FP16 de Hugging Face, en GPU de escritorio y móviles. Hugging Face estima la calibración AWQ de un modelo de 8B en unos 10 minutos sobre una A100, cerca de la mitad de lo que estima para GPTQ.
AutoAWQ quedó oficialmente descontinuada. Su última configuración probada fue Torch 2.6.0 con Transformers 4.51.3. vLLM adoptó esa funcionalidad dentro de llm-compressor, hoy el flujo recomendado, y MLX-LM también admite AWQ sobre Apple Silicon.
EXL2, cualquier tasa de bits entre 2 y 8
EXL2 es el formato nativo de ExLlamaV2, la biblioteca de inferencia de turboderp para GPU de consumo. Usa el mismo método de optimización que GPTQ y admite cuantización de 2, 3, 4, 5, 6 y 8 bits.
- Tasa promedio libre entre 2 y 8 bits por peso, con niveles que se mezclan entre capas y dentro de una misma capa.
- Mezcla a nivel de columna, así las columnas más importantes de una capa reciben más bits.
- Asignación automática, el conversor cuantiza cada matriz de varias formas, mide el error contra los datos de calibración y elige los ajustes que minimizan el peor caso mientras respeta la tasa objetivo.
Por eso los archivos EXL2 se llaman 4.65bpw y no 4-bit.
El servidor recomendado de forma oficial es TabbyAPI, que expone una API compatible con la de OpenAI. EXL2 renombra algunos tensores, de modo que todo modelo se ve internamente como una variante de Llama, y eso hace difícil reutilizar un EXL2 en otros entornos.
EXL3, el sucesor construido sobre QTIP
EXL3 es el formato sucesor y se apoya en QTIP, de Cornell RelaxML, que usa cuantización codificada por enrejado con procesamiento de incoherencia y se publicó en NeurIPS 2024. EXL3 conserva el libro de códigos procedimental y la codificación por enrejado de QTIP, y cambia cómo se regularizan y empaquetan los tensores.
- Conversión simple, se entrega un modelo de Hugging Face y una tasa de bits objetivo, y las Hessianas se calculan sobre la marcha durante la conversión, según el README del proyecto.
- Costo razonable, la conversión toma minutos en modelos chicos y unas horas para uno de 70B o más en una sola GPU clase RTX 4090. El mismo README le atribuye a AQLM cerca de 720 horas de GPU A100 para un 70B.
- Tasas muy bajas, un Llama-3.1-70B se mantiene coherente a 1,6 bits por peso, y con una capa de salida de 3 bits y una caché de 4.096 tokens entra en menos de 16 GB de VRAM.
- Disposición portable, EXL3 mantiene en buena medida la estructura original de los tensores, al revés que EXL2.
ExLlamaV3 agrega cuantización de la caché KV de 2 a 8 bits, inferencia con paralelismo de tensores y de expertos, decodificación especulativa, soporte multimodal y un complemento para Transformers. Las versiones recientes suman descarga a CPU para modelos MoE grandes. Pide CUDA 12.4 o posterior, y su README todavía lista el soporte de ROCm como tarea pendiente.
bitsandbytes, cuantizar al momento de cargar
bitsandbytes no es algo que se descargue ya cuantizado. Se carga un modelo de 16 bits y se cuantiza sobre la marcha. Su modo de 4 bits viene de QLoRA.
- NF4, un tipo de dato de 4 bits diseñado para pesos con distribución normal.
- Doble cuantización, las propias constantes de cuantización se cuantizan para ahorrar más memoria.
- Resultado, ajuste fino de un modelo de 65B en una sola GPU de 48 GB, igualando el rendimiento del ajuste fino en 16 bits.