
IA
Transformers ya corre los modelos GGUF de llama.cpp
La integración reutiliza los kernels de ggml, parte por los Mac con Apple Silicon y arranca con la arquitectura Qwen3.5.
Hugging Face
6 notas publicadas
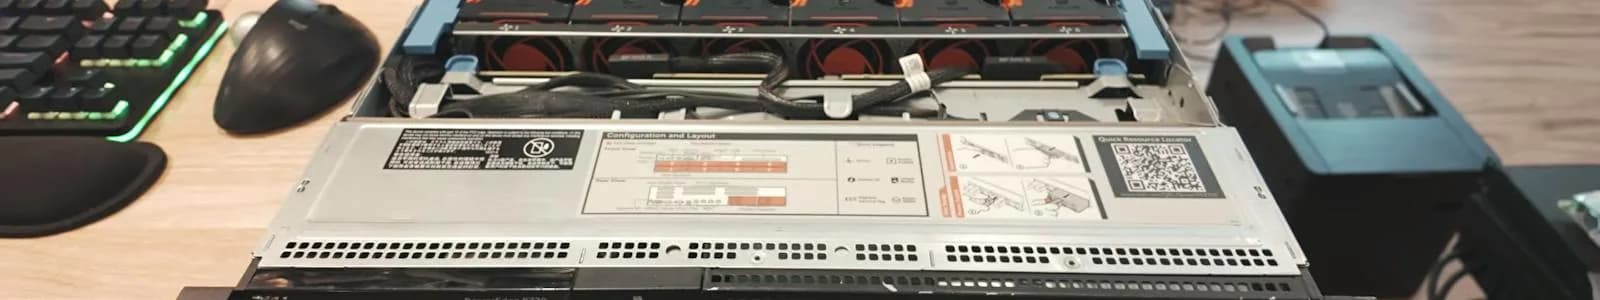
El youtuber MattMo llenó un Dell PowerEdge R720 de 2012 con 384 GB de memoria DDR3 ECC y ejecutó modelos completos en los dos Xeon, sin una sola tarjeta aceleradora.
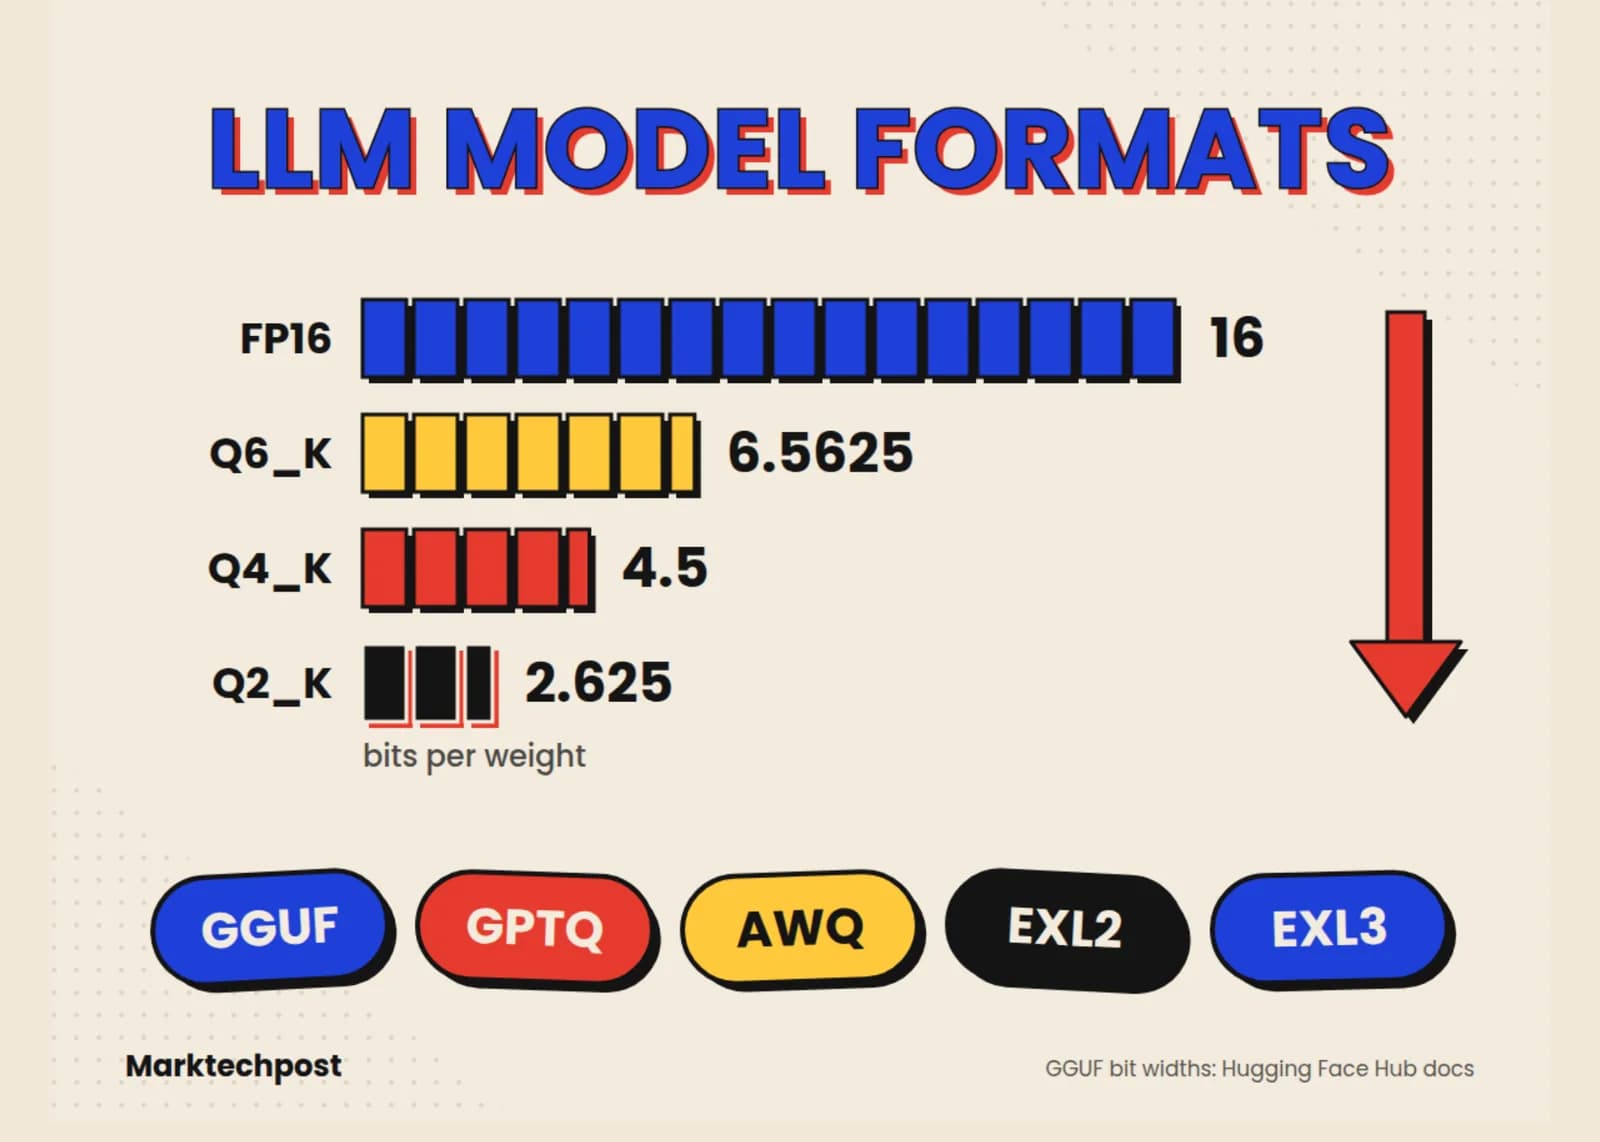
La confusión parte por mezclar dos capas distintas, el contenedor que guarda los tensores en disco y el método que aprieta los pesos a menos bits.
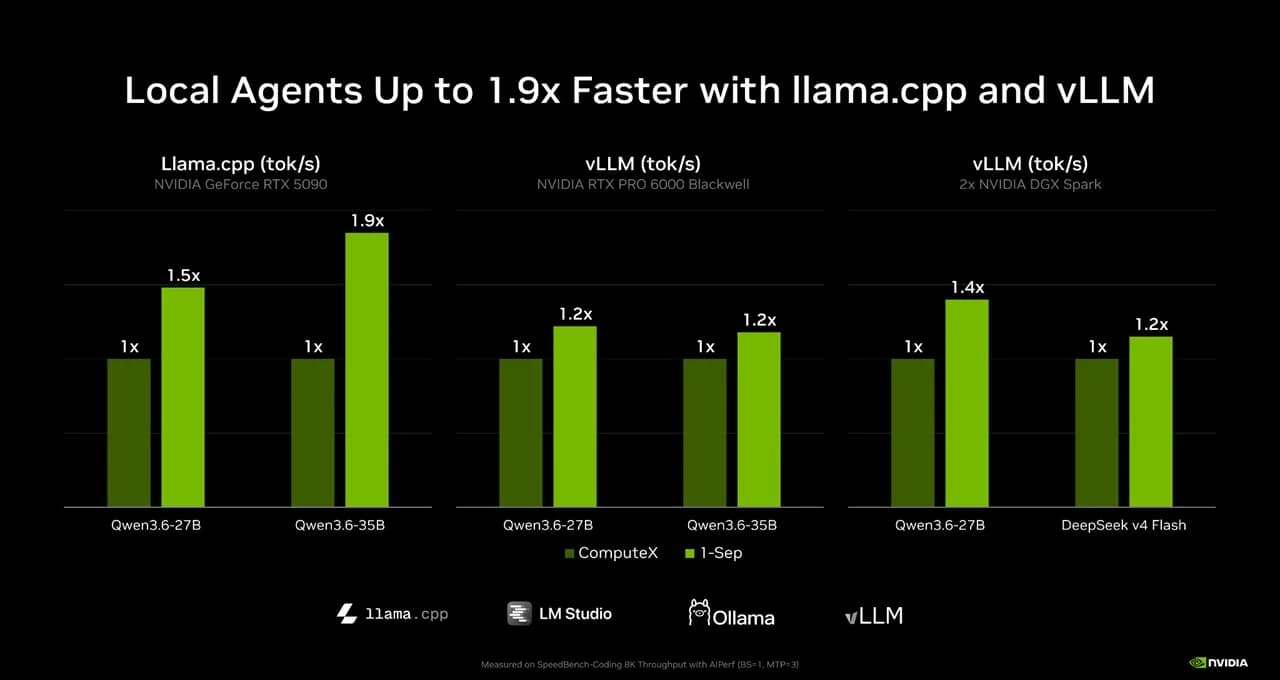
En IFA 2026 la empresa anunció configuración automática de modelos locales en Windows, inferencia hasta 1,9 veces más rápida con llama.cpp y la llegada de los equipos RTX Spark en octubre.
El servidor local de IA respaldado por AMD suma soporte experimental de HRX sobre llama.cpp, con mejoras de 30% a 50% en la fase de prellenado frente a los backends Vulkan y HIP existentes.
COMPUTEX 2026 y Microsoft Build traen sandboxing nativo con Microsoft eXecution Containers, tensor parallelism en llama.cpp y nuevos modelos Hermes y Holo 3.1 para agentes locales sobre PCs RTX.
Otros temas que aparecen junto a #llama cpp en nuestra cobertura editorial.