Hugging Face y OpenRouter se asociaron para que correr modelos de pesos abiertos sea más simple, anunció Hugging Face en su blog el 16 de noviembre. Los lanzamientos grandes de pesos abiertos ya se publican en el Hub de Hugging Face, y OpenRouter sirve esos modelos a escala, repartiendo cada petición entre más de 80 proveedores según mediciones en vivo de cada uno. Con la alianza, cualquier modelo abierto del Hub que algún proveedor sirva se puede llamar con el token de Hugging Face, por la misma API, y con el mejor proveedor elegido en cada petición.
Desde ese día, Inference Providers dejó su enrutador propio y pasó a usar el de OpenRouter. Las peticiones a modelos de lenguaje van ahora por OpenRouter, que elige el proveedor de cada llamada según precio, velocidad y fiabilidad medidos en vivo, y reintenta con otro si el primero falla. El código del usuario no cambia.
Con las herramientas que ya se usan
El enrutador acepta las API Chat Completions y Responses de OpenAI y la API Messages de Anthropic para todos los modelos de chat, sin importar qué proveedor esté detrás. Hugging Face publicó guías de configuración para Claude Code, Codex, OpenCode, Pi y Hermes Agent. Cada una se puede copiar paso a paso o entera, como instrucción para el propio agente.
El mismo token de Hugging Face da acceso a almacenamiento con Storage Buckets, a cómputo con Jobs y a inferencia dedicada con Inference Endpoints. Los planes PRO, Team y Enterprise incluyen créditos mensuales para cómputo e inferencia.
¿Cuánto se usan hoy los modelos abiertos?
En OpenRouter, los modelos de pesos abiertos pasaron de servir el 26,8% de los tokens en octubre de 2025 al 71,7% a fines de septiembre de 2026, con un máximo de 77,5% en julio, según el análisis de OpenRouter de octubre de 2026. En el mismo periodo, el volumen semanal de los modelos abiertos se multiplicó por más de 60, contra casi 10 veces el de los cerrados. Esta semana, el modelo más usado de OpenRouter es uno abierto, DeepSeek V4.1 Flash 1017, con 59,2 billones de tokens según su ranking.
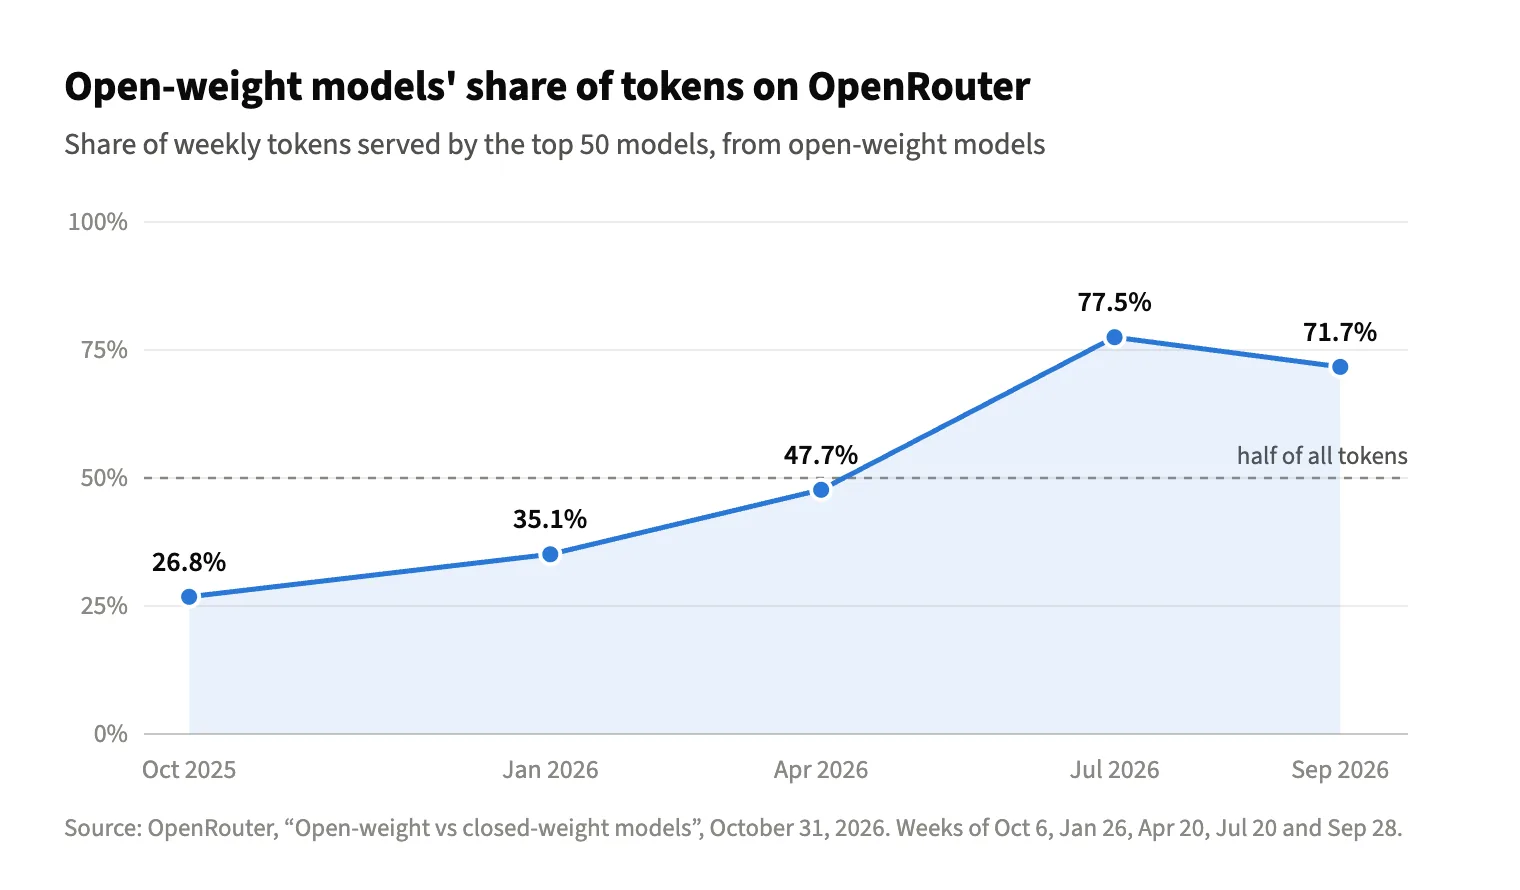
Los modelos abiertos cuestan en promedio cerca de cuatro veces menos. Cobran 0,28 dólares por millón de tokens de entrada y 1,62 dólares por millón de salida, contra 1,27 y 6,36 dólares de los modelos cerrados.
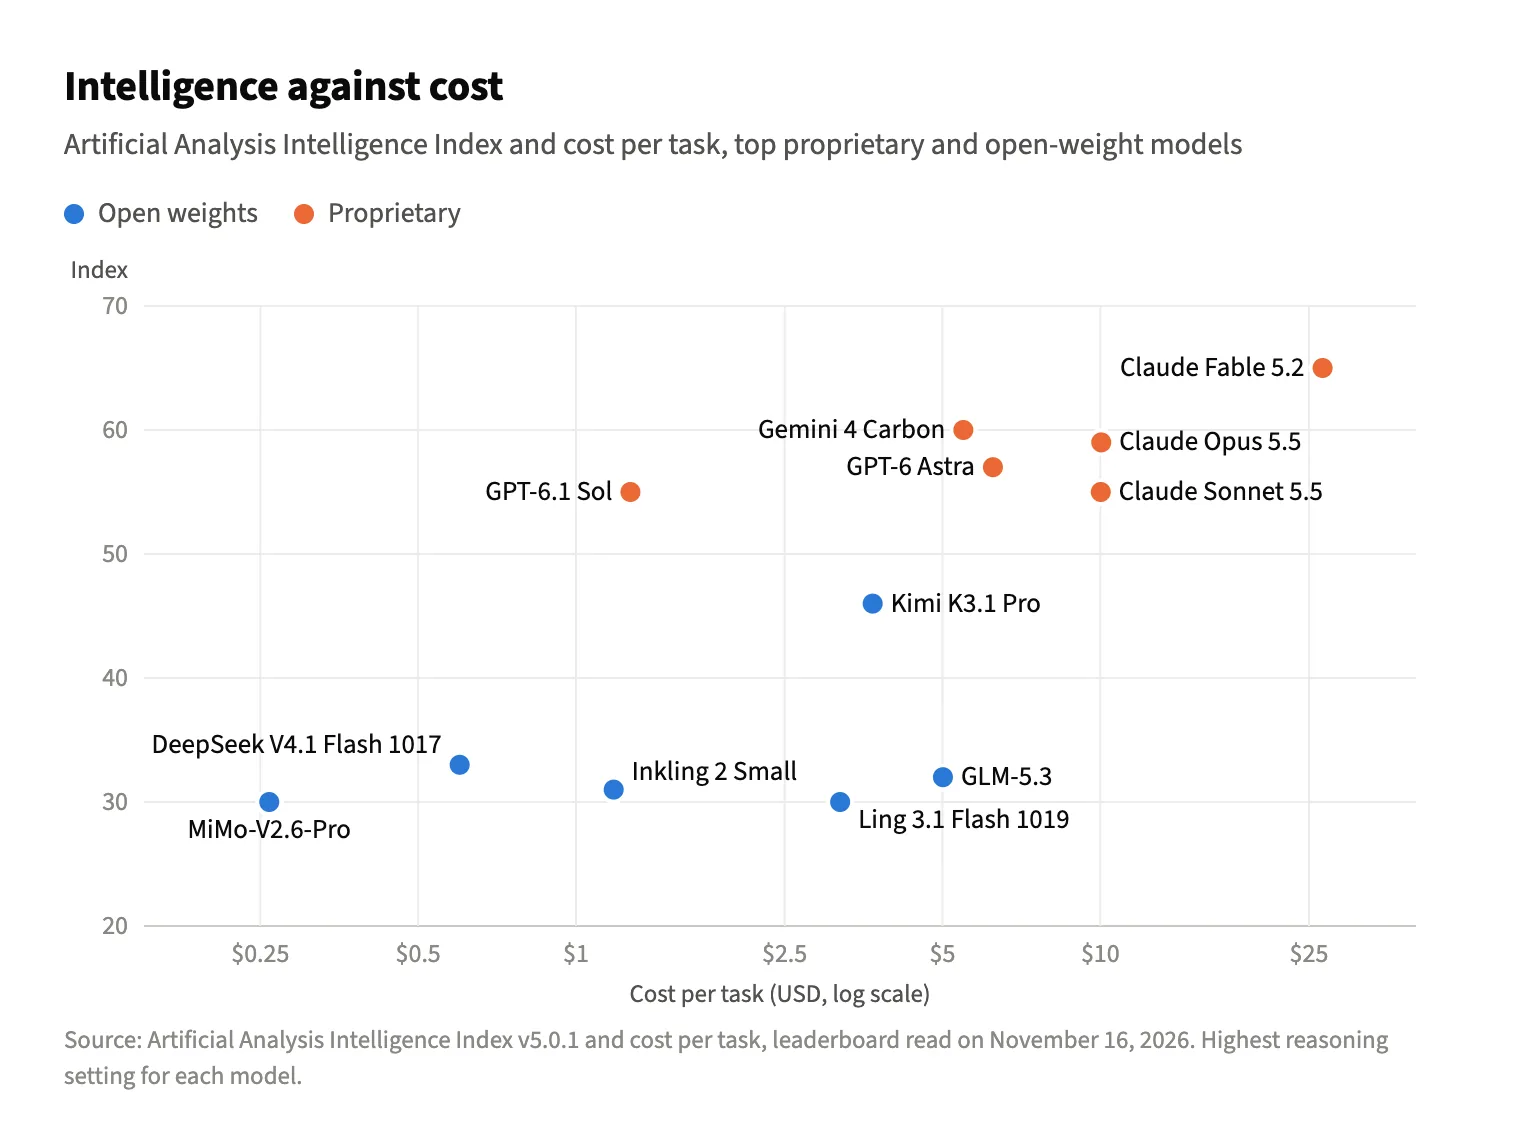
Los mejores modelos abiertos siguen detrás de los mejores propietarios en las pruebas más difíciles. En el Artificial Analysis Intelligence Index, Kimi K3.1 Pro, el mejor modelo abierto, saca 46 puntos contra 65 de Claude Fable 5.2, a cerca de un séptimo del costo por tarea (3,68 dólares contra 26,54). Para muchas cargas de trabajo, ese intercambio conviene, según Hugging Face.
Cómo enruta OpenRouter
OpenRouter sirve más de 800 billones de tokens al mes a más de 10 millones de usuarios, con más de 600 modelos de más de 80 proveedores. Su enrutamiento se basa en mediciones en vivo de cada proveedor sobre todo ese tráfico.
La empresa rehízo hace poco su enrutamiento de proveedores. Antes miraba solo el precio de lista más bajo. Ahora manda cada petición al proveedor con la mejor mezcla de precio, velocidad y fiabilidad.
Cuando un proveedor se pone lento o empieza a fallar, el tráfico se aleja de él hasta que se recupera, y un intento fallido se repite con el siguiente mejor proveedor dentro de la misma llamada. En las mediciones de OpenRouter, el nuevo enrutamiento redujo los errores de capacidad en 46%, mejoró el tiempo hasta el primer token en 16,9% y el rendimiento en 16,3%.
Antes, Inference Providers elegía un proveedor para la petición y devolvía su error si fallaba. Ahora la petición se reintenta en otro. Se puede seguir eligiendo una política o un proveedor con un sufijo en el identificador del modelo:
zai-org/GLM-5.3            # default: best mix of price, speed and reliability
zai-org/GLM-5.3:fastest    # highest throughput
zai-org/GLM-5.3:cheapest   # lowest price
zai-org/GLM-5.3:novita     # only Novita
Sin sufijo se usa la mejor mezcla de precio, velocidad y fiabilidad. Con :fastest gana el mayor rendimiento, con :cheapest el precio más bajo, y con :novita la petición va solo a Novita.
El enrutamiento también respeta la caché. Una conversación se queda en el proveedor que guarda su caché de prompt. Para hacerlo explícito, se envía un UUID estable por conversación en el encabezado X-HF-Session-Id, como explica la guía de caché de prompts.
¿Cambia el precio?
No. Se paga el precio del proveedor en la factura de Hugging Face, y Hugging Face no le suma margen. Los usuarios PRO reciben 2 dólares en créditos cada mes, y las organizaciones Team y Enterprise, 2 dólares por puesto. El detalle está en Pricing and Billing.
Imagen, video y audio siguen igual
La generación de imagen, video y audio funciona exactamente como antes, directo por Inference Providers de Hugging Face y sin pasar por OpenRouter. Se mantienen el token y la API, y el acceso a decenas de miles de LoRA.
Ver a dónde van las peticiones
En la página de cada modelo se puede chatear con él en el widget. Dos pestañas nuevas muestran qué hay detrás. Providers lista cada proveedor al que OpenRouter puede enviar el modelo, con su precio de entrada y salida, su velocidad y su disponibilidad en las últimas 24 horas. Metrics muestra el mejor precio, rendimiento, tiempo hasta el primer token, largo de contexto y disponibilidad entre todos ellos.
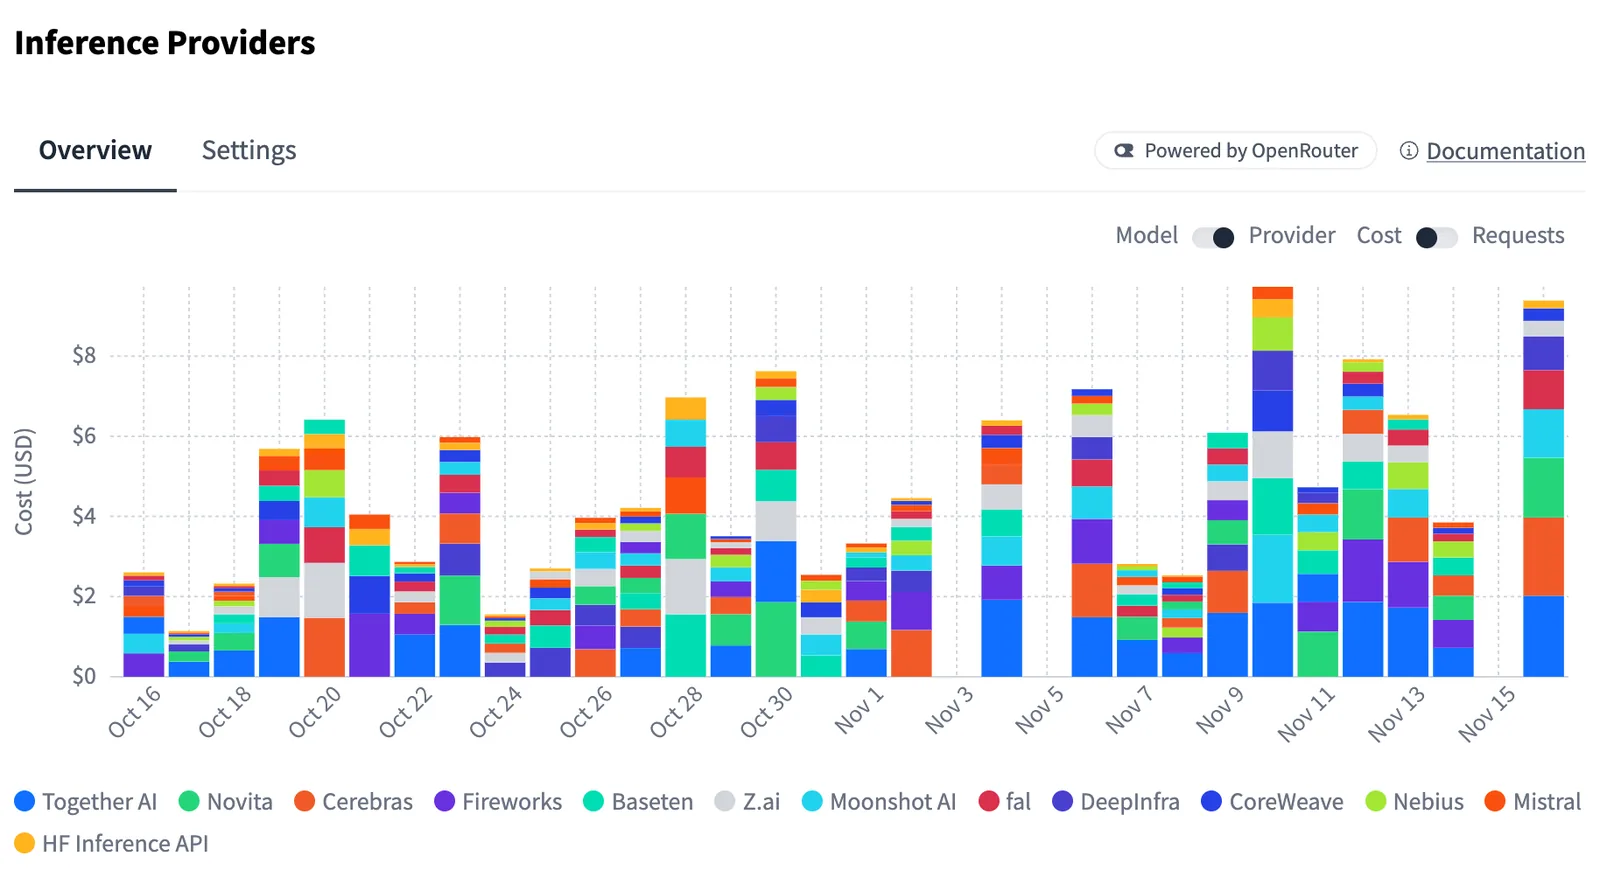
El resumen de uso desglosa el gasto según el proveedor al que fue cada petición.
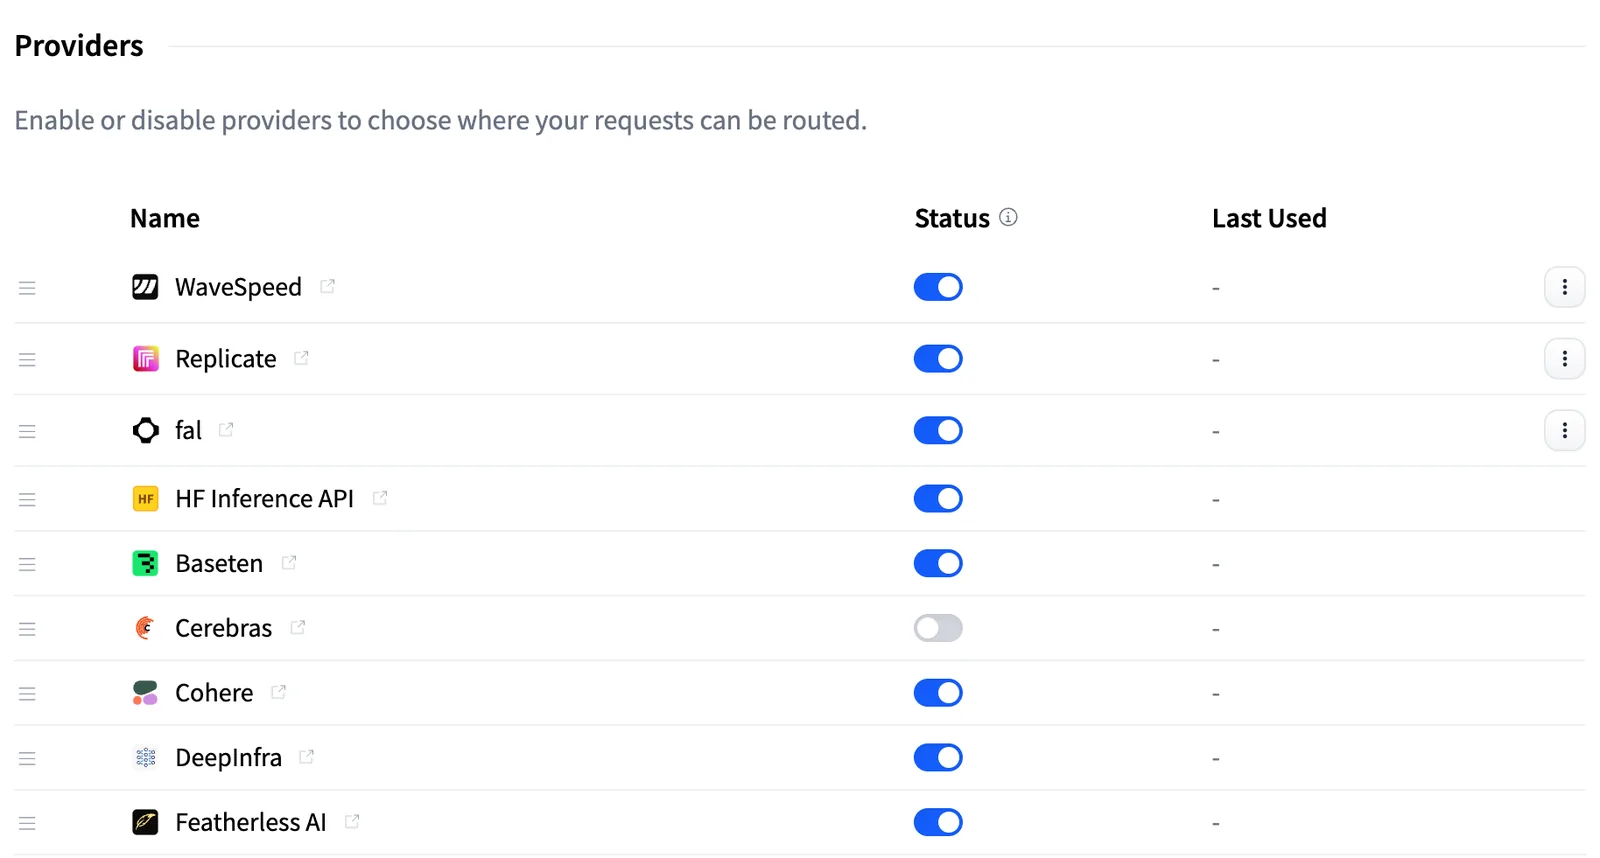
En la configuración se puede apagar cualquier proveedor, y el enrutador nunca le envía peticiones. Las organizaciones tienen los mismos ajustes, que se aplican a toda petición facturada a la organización.
El cambio que rompe algo, las claves propias
Como las peticiones a modelos de lenguaje pasan ahora por OpenRouter y se facturan a la cuenta u organización de Hugging Face, ya no se puede usar una clave de API propia de un proveedor con estos modelos. Sí se puede elegir proveedor con el sufijo modelo:proveedor o apagar proveedores en la configuración, y el código sigue igual. Las claves propias de proveedores de imagen y video siguen funcionando.
Lo que viene
Hugging Face lo presenta como el primer paso de la alianza. Los dos siguientes son conectar la cuenta de OpenRouter con la de Hugging Face y enrutar más tareas por OpenRouter. Para empezar, se puede probar un modelo o leer la documentación de Inference Providers.