Mistral Large 4, apodado Le Chonk, es un modelo multimodal y multilingüe de mezcla de expertos (MoE) de Mistral. Recibe texto e imágenes y genera texto. Tiene cerca de un billón de parámetros en total, 49.000 millones activos, y una ventana de contexto de un millón de tokens, según el blog de Hugging Face que acompañó la publicación de los pesos el 29 de octubre.
El modelo sale en dos variantes oficiales:
También hay versiones GGUF creadas por Unsloth y por el equipo de llama.cpp. Se distribuye bajo la Mistral Ecosystem Open-Weight License, una derivada de MIT que pone límites a quienes lo ofrezcan como servicio.
Hugging Face destaca tres áreas donde rinde mejor, la ciberseguridad, los agentes de programación y la multimodalidad.
¿Qué cambia en Mistral Large 4?
Mistral Large 4 combina un gran conjunto de expertos con atención dispersa y un codificador de visión Pixtral. El modelo de lenguaje elige un grupo pequeño de expertos para cada token, mientras su indexador de atención decide a qué posiciones anteriores del contexto atender. Son dos formas distintas de dispersión, una selecciona redes feed-forward y la otra selecciona posiciones del contexto.
Todos los checkpoints están en la colección de Mistral Large 4.
Ciberseguridad
Mistral Large 4 obtiene 82% en la prueba del Artificial Analysis Cyber Index que le pide a un modelo reproducir una vulnerabilidad real en software de código abierto y luego parcharla. Mistral informa que varios modelos cerrados de frontera sacan cerca de cero en esa misma prueba porque se niegan a intentarla. Para quien defiende un sistema eso pesa, porque arreglar una vulnerabilidad casi siempre exige reproducirla primero. En las pruebas internas de Mistral, el modelo también sirvió para analizar malware, priorizar vulnerabilidades y escribir reglas de detección, tareas para las que no se entrenó de forma explícita.
Mistral lo posiciona sobre todo para trabajo defensivo. La investigación de vulnerabilidades y la respuesta a incidentes suelen parecer ataques en la entrada del modelo, así que los filtros de los modelos cerrados pueden bloquearlas. Un equipo que depende de una API también puede perder el acceso en medio de un incidente. Con pesos abiertos, tanto la política de uso como el despliegue quedan en manos del usuario. Aun así, el modelo rechaza pedidos dañinos. En las preguntas de ciberseguridad de JailbreakBench, StrongREJECT y AgentHarm, su tasa promedio de rechazo es más alta que la de cualquier otro modelo de pesos abiertos.
Para la comunidad, un modelo así abre varios usos. Se puede armar un sistema propio de ciberseguridad sobre el código, los registros de fallas y las muestras de malware de cada equipo. Con TRL, por ejemplo, se pueden ajustar modelos más chicos a partir de trazas de Mistral Large 4 parchando un repositorio. Las tareas de reproducir y luego parchar usan una recompensa verificable, así que calzan con entornos de aprendizaje por refuerzo para entrenar modelos de seguridad más pequeños. Los pesos abiertos también permiten medir directamente cómo rechaza pedidos el modelo, en vez de depender de lo que diga el proveedor.
Hugging Face entrevistó a Pierre Stock sobre las capacidades de ciberseguridad del modelo, y la conversación está en video.
Arquitectura
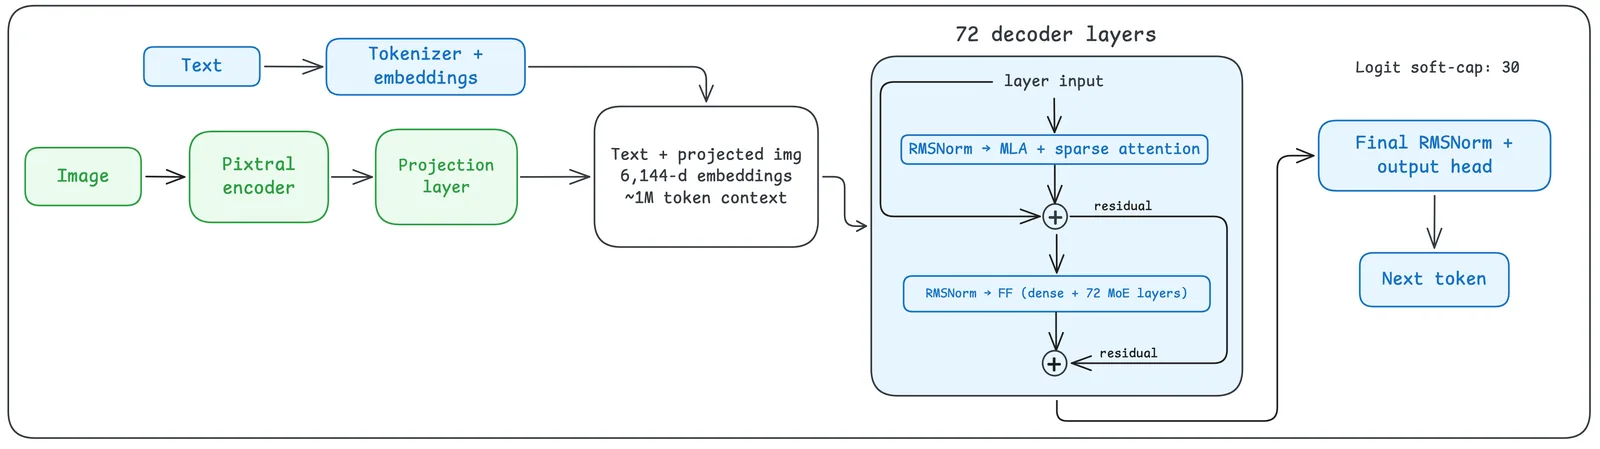
El decodificador de texto tiene 72 capas, una dimensión oculta de 6.144 y 64 cabezas de atención. Sus bloques de atención combinan Multi-head Latent Attention (MLA) con un indexador DeepSeek Sparse Attention (DSA), un camino que también siguen otros modelos como GLM 5.3. MLA guarda una representación comprimida de las claves y valores, y DSA elige hasta 2.048 posiciones de clave por cada consulta.
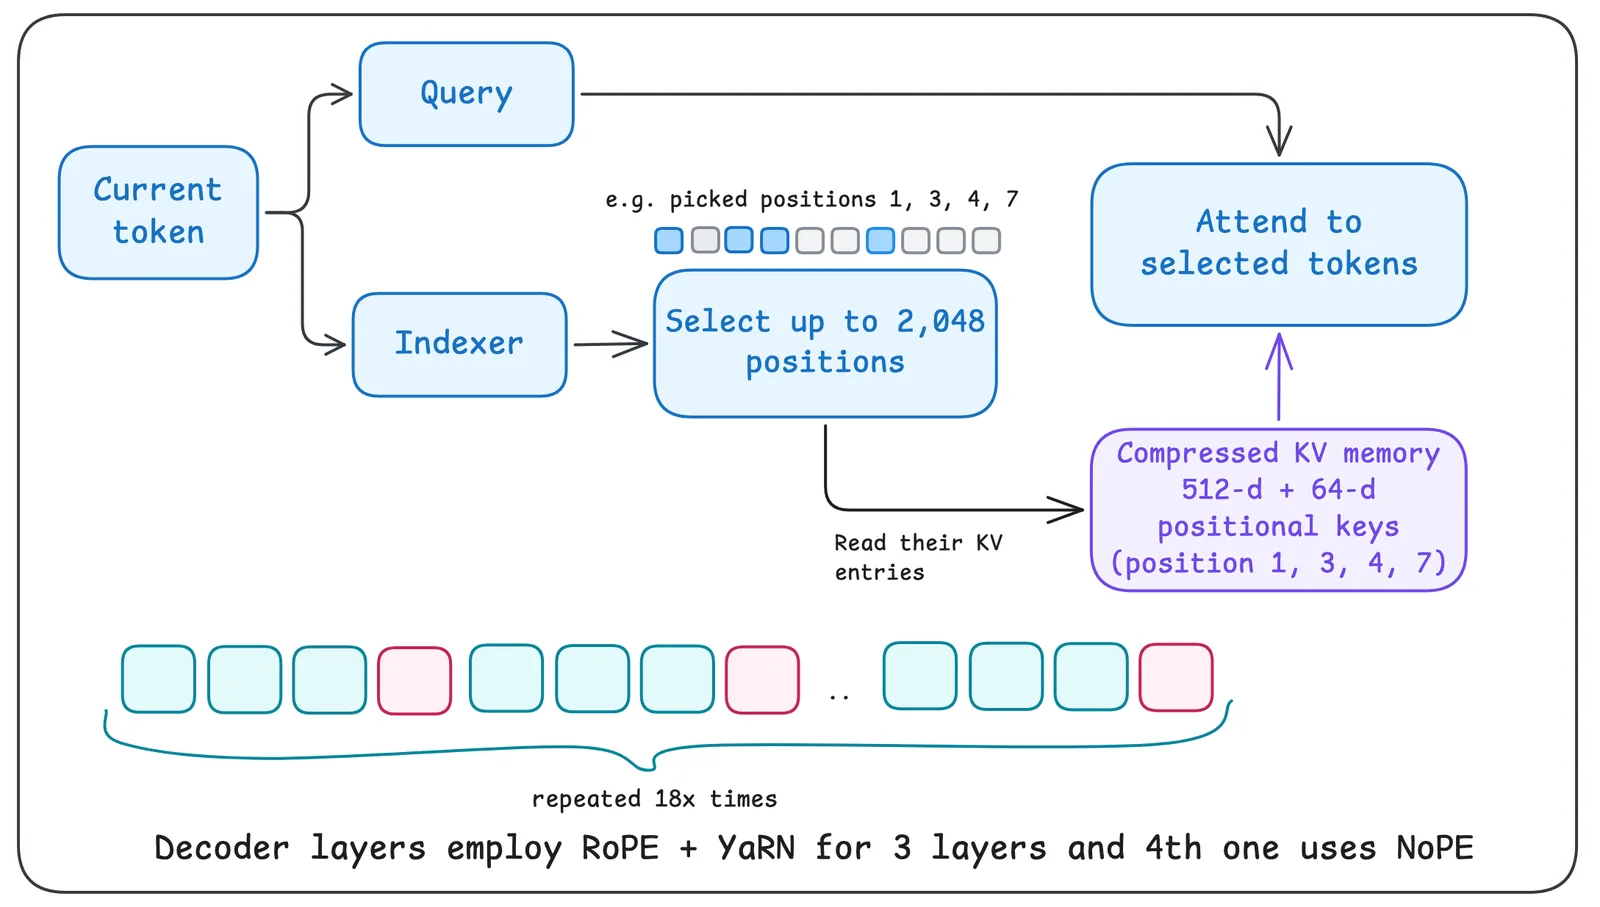
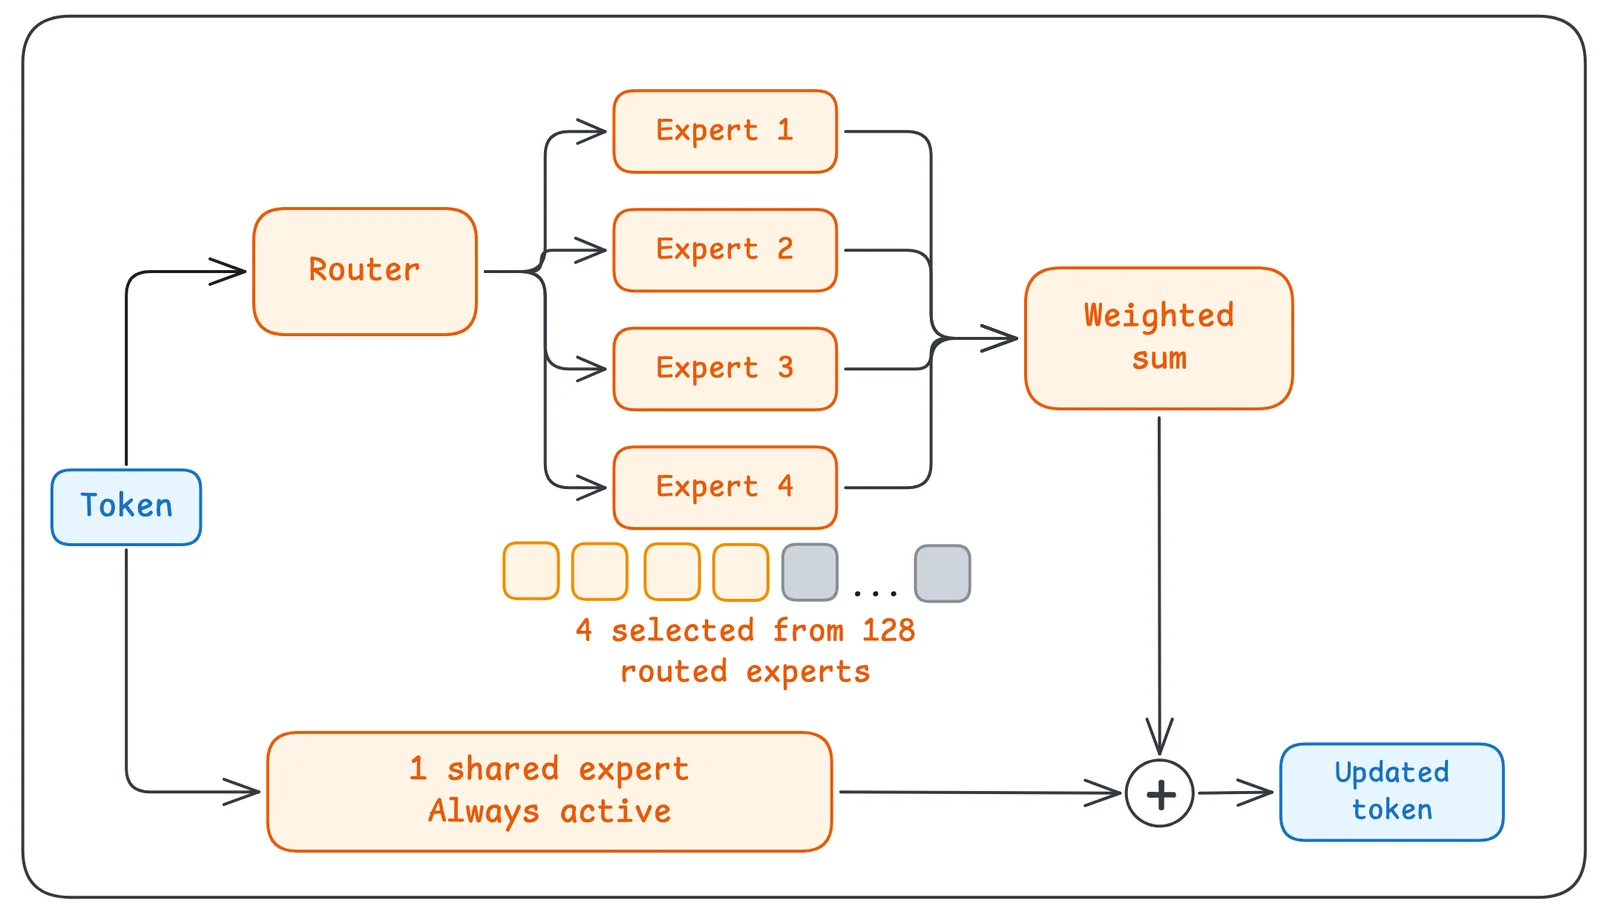
En cada bloque del decodificador hay un patrón 3:1 entre RoPE y NoPE, o sea tres capas usan RoPE y cada cuarta capa usa NoPE. El modelo también comparte el estado de claves y valores entre capas. La primera capa usa una red feed-forward densa. Las otras 71 usan bloques MoE, donde un enrutador softmax elige 4 de los 128 expertos para cada token. Un experto compartido corre siempre junto a los elegidos, lo que da 5 expertos activos por token.
Para RoPE, Mistral usa LeRope, una variante de RoPE escalada con YaRN que aprende un multiplicador por frecuencia.
Codificador de visión
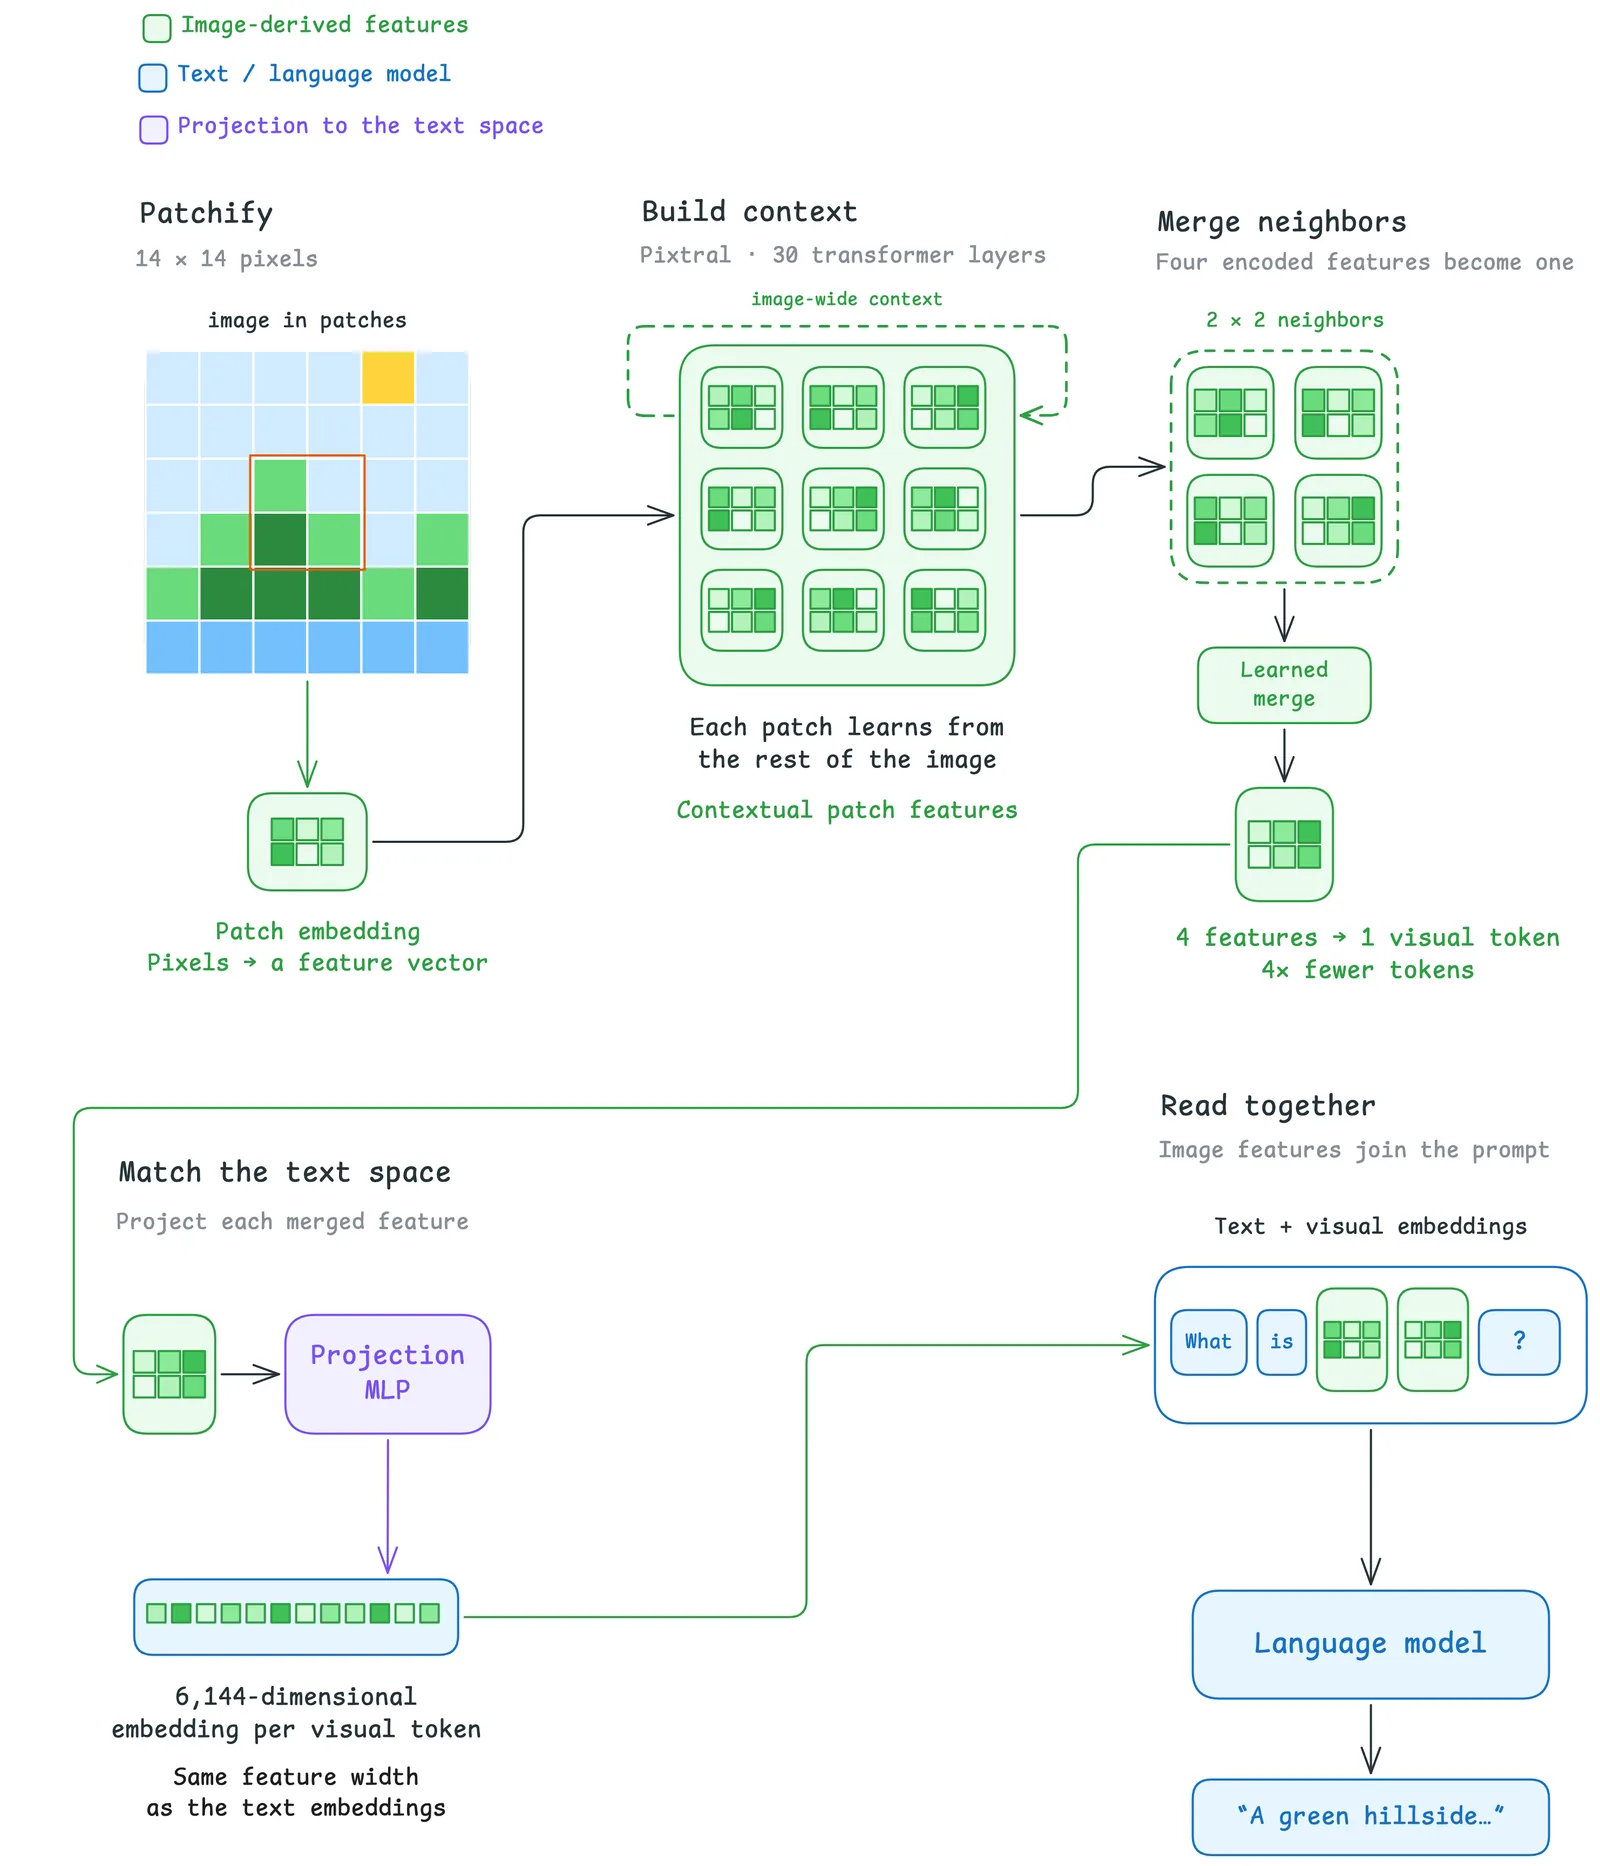
Mistral Large 4 usa un codificador Pixtral de 1.600 millones de parámetros. Pixtral tiene 30 capas, una dimensión oculta de 2.048 y 16 cabezas de atención. Trabaja con parches de 14 × 14 y un proyector que fusiona parches con un tamaño de fusión espacial de 2.
¿Cómo le va en los benchmarks?
Al 29 de octubre de 2026, Mistral Large 4 es el quinto mejor modelo de pesos abiertos en el índice de inteligencia de Artificial Analysis.
En programación logra 61,7% en DeepSWE v1.1, 59,4% en SWE-Atlas-QnA y 28,3% en Terminal-Bench 4. Su puntaje combinado de 49,8% en el Coding Agent Index lo deja por delante de DeepSeek V4 Pro 0813 y de Qwen3.8 Max.
Esa capacidad se extiende al trabajo de oficina, con 59,9% en AutomationBench y 1.393 de Elo en AA-Briefcase, dos pruebas que evalúan flujos de negocio y tareas profesionales de largo aliento.
En ciberseguridad destacan tres resultados:
- Artificial Analysis Cyber Index. Está entre los cinco mejores modelos del mundo en esta evaluación independiente de la capacidad de encontrar y corregir vulnerabilidades.
- Reproducción y parche de vulnerabilidades. Logra 82%, el puntaje más alto informado en esta prueba dentro del índice.
- Cybench. Resuelve el 93% de un conjunto de 40 desafíos sacados de competencias de seguridad.
El modelo también muestra 93,3% de resistencia a ataques en el benchmark B3 de Lakera, que mide la robustez frente a la inyección de instrucciones.
¿Cómo se corre?
Mistral Large 4 llegó con soporte desde el primer día en Transformers, vLLM y llama.cpp. Hay cuantizaciones GGUF del equipo de llama.cpp, y Hugging Face ofrece desplegarlo con Inference Endpoints o usarlo sin servidor a través de Inference Providers.
Transformers
La implementación en Transformers usa AutoModelForMultimodalLM, con AutoProcessor para preparar la conversación y las imágenes. El modelo acepta low, medium y high como nivel de razonamiento. El valor por defecto es high y el razonamiento no se puede apagar, así que pasar reasoning_effort como none igual usa high.
Para correrlo hay que actualizar Transformers.
pip install --upgrade transformersimport os
from transformers import AutoProcessor, AutoModelForMultimodalLM, DistributedConfig
distributed_config = DistributedConfig(
tp_size=int(os.environ["WORLD_SIZE"]),
ep_size=int(os.environ["WORLD_SIZE"]),
)
model_id = "mistralai/Mistral-Large-4-1T-A52B"
processor = AutoProcessor.from_pretrained(model_id)
model = AutoModelForMultimodalLM.from_pretrained(
model_id,
distributed_config=distributed_config,
)
text_messages = [
{
"role": "user",
"content": "Who are you?"
}
]
multimodal_messages = [
{
"role": "user",
"content": [
{
"type": "image",
"image": "https://huggingface.co/datasets/huggingface/cats-image/resolve/main/cats_image.jpeg",
},
{
"type": "text",
"text": "How many cats are in the image?",
},
],
},
]
for messages in [text_messages, multimodal_messages]:
inputs = processor.apply_chat_template(
messages,
add_generation_prompt=True,
tokenize=True,
return_dict=True,
return_tensors="pt",
reasoning_effort="medium",
).to(model.device).to(model.dtype)
input_len = inputs["input_ids"].shape[-1]
outputs = model.generate(**inputs, max_new_tokens=100)
if int(os.environ["RANK"]) == 0:
print(processor.decode(outputs[0][input_len:], skip_special_tokens=False))El script se guarda como script.py y se lanza así.
torchrun --nproc-per-node 8 script.pyvLLM
vLLM soporta el checkpoint NVFP4, que ocupa menos memoria y requiere GPU NVIDIA Blackwell. El modelo trae además un modelo borrador DSpark para acelerar la generación en vLLM. El servidor se levanta así.
vllm serve mistralai/Mistral-Large-4-1T-A52B-NVFP4 \
  --config-format mistral \
  --load-format mistral \
  --tensor-parallel-size 8 \
  --decode-context-parallel-size 8 \
  --enable-expert-parallel \
  --dtype bfloat16 \
  --max-model-len 131072 \
  --max-num-seqs 16 \
  --max-num-batched-tokens 2048 \
  --gpu-memory-utilization 0.85 \
  --enable-prefix-caching \
  --enforce-eager \
  --mm_processor_cache_gb 0.0
Con el servidor arriba, se le puede consultar directamente.
curl -s http://127.0.0.1:8000/v1/chat/completions -H 'Content-Type: application/json' \
  -d '{"messages":[{"role":"user","content":"What is 17*23?"}],"max_tokens":512}'
Llama.cpp
Llama.cpp y Llama App ya soportan Mistral Large 4. Llama App se instala con este comando.
curl -LsSf https://llama.app/install.sh | shDespués se inicia el servidor indicando el sufijo de la cuantización tras el identificador del modelo.
llama serve -hf ggml-org/Mistral-Large-4-1T-A52B-GGUF:Q2_KEste repositorio tiene las cuantizaciones derivadas del checkpoint FP8, y este otro las convertidas desde el repositorio oficial NVFP4.
Con el servidor andando, la interfaz web queda en localhost:9931. Desde ahí se pueden subir imágenes y ajustar el nivel de razonamiento. Las opciones de multimodalidad y llamadas a herramientas están en la referencia de la API.