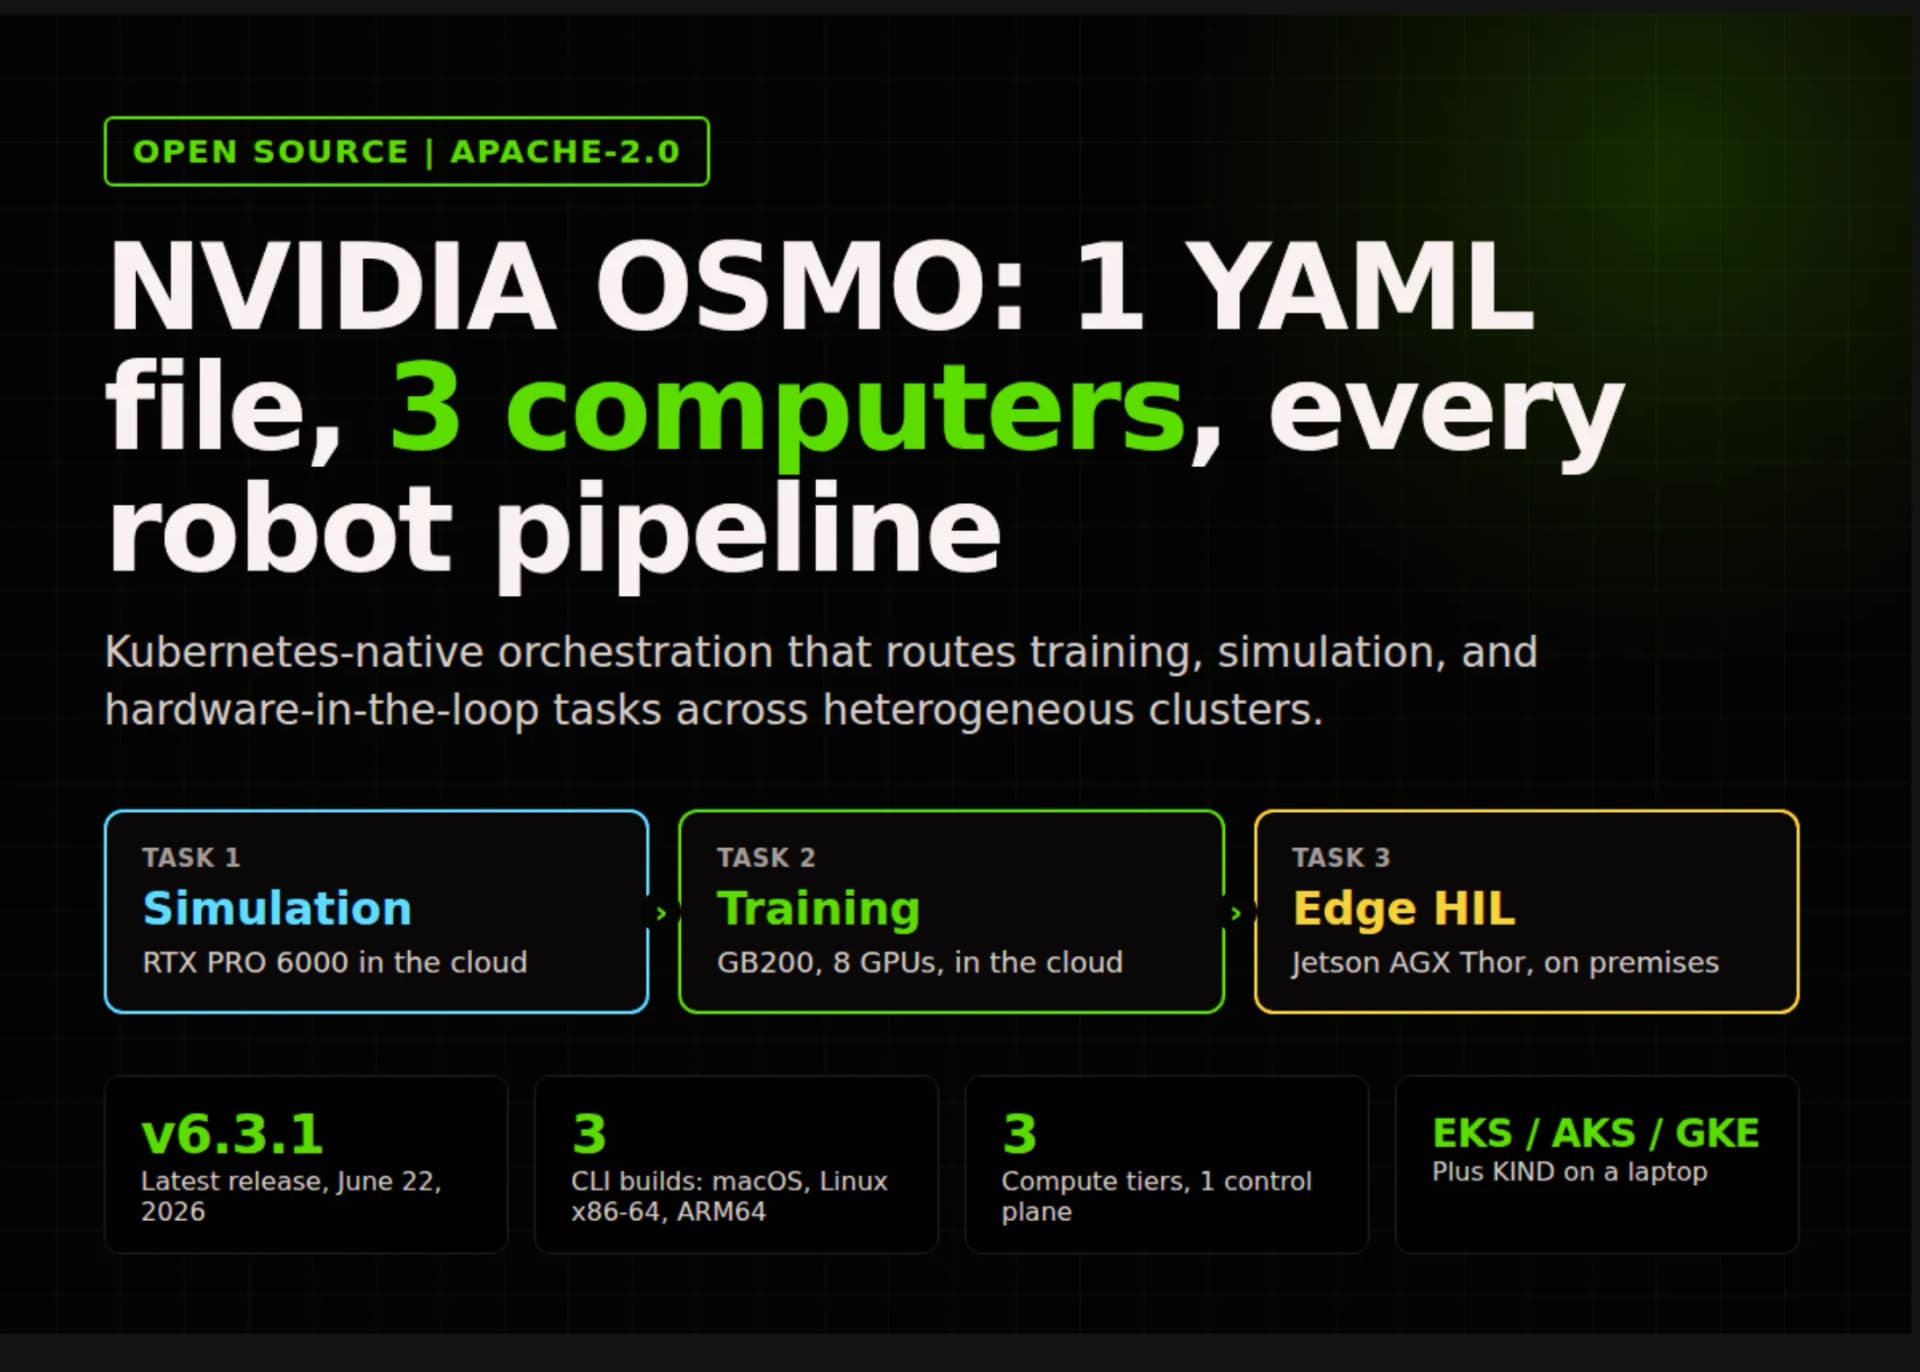
Entrenar una política de control, simularla y validarla dentro del robot real ocurre hoy en tres infraestructuras distintas, cada una con su clúster, su planificador y sus guiones de pegamento. NVIDIA liberó OSMO para manejar las tres desde un solo archivo YAML, sin que el equipo tenga que tocar código de infraestructura.
El proyecto sale con licencia Apache 2.0, publica sus cartas Helm y sus contenedores en NGC y trae un arranque rápido local que levanta todo el plano de control en una estación de trabajo con KIND.
¿Qué es el problema de los tres computadores?
NVIDIA describe la IA física como un problema de tres computadores. El entrenamiento corre en GPU de centro de datos. La simulación, la física y el renderizado de sensores corren en hardware RTX de estación de trabajo. El despliegue y las pruebas con hardware en el lazo corren en equipos de borde como el Jetson AGX Thor, casi siempre dentro de la propia empresa. Cada capa suele traer sus herramientas y es en los traspasos donde se acumulan los guiones hechos a mano.
OSMO trata las tres como respaldos de un mismo plano de control. Cada una es un clúster de Kubernetes registrado desde la línea de comandos. Los flujos de trabajo nunca nombran un clúster, nombran una plataforma y OSMO enruta la tarea al grupo de máquinas que la ofrece.
| Etapa | Hardware | Nombre de plataforma en el YAML |
|---|---|---|
| Entrenamiento | GPU de centro de datos, GB200 o H100 | gb200 |
| Simulación y renderizado de sensores | estación de trabajo RTX | rtx-pro-6000 |
| Despliegue y pruebas con hardware en el lazo | equipo de borde Jetson AGX Thor | jetson-agx-thor |
Cómo se ve un flujo de trabajo
El ejemplo canónico del repositorio son tres tareas encadenadas por sus datos.
simulationcorre un contenedor de Isaac Sim sobrertx-pro-6000train-policycorre un contenedor de PyTorch sobregb200con 8 GPU, y toma como entrada la salida de la tarea de simulaciónevaluate-thorcorre una aplicación ROS sobrejetson-agx-thor, consume la política entrenada y escribe los resultados en un conjunto de datos con nombre
Las dependencias salen de inputs, la persistencia de outputs y la ubicación de platform. La guía de usuario cubre además los grupos de tareas en serie y en paralelo, el uso de plantillas Jinja para parametrizar, las políticas de reintento y las prioridades HIGH, NORMAL y LOW, con desalojo y préstamo de GPU entre grupos.
¿Qué trae cada versión?
Portabilidad. El mismo YAML corre en un notebook con Docker o KIND, y también en EKS, AKS, GKE, en un clúster propio o en uno sin conexión a internet. La versión 6.3.0 agregó un deploy-k8s.sh multiproveedor que instala OSMO sobre Azure AKS, AWS EKS, microk8s o cualquier clúster existente, con el almacenamiento conectado a MinIO, Azure Blob, AWS S3 o un S3 propio.
Desarrollo interactivo. Se pueden abrir sesiones de VS Code, Jupyter o SSH sobre un nodo remoto con GPU, entrar con exec a una tarea en ejecución, redirigir puertos y mover archivos con rsync en las dos direcciones. La 6.3.0 sumó osmo workflow rsync download con barra de progreso en vivo.
Planificación. OSMO usa por defecto el planificador KAI de NVIDIA. La versión 6.2.8 agregó colocación consciente de la topología NVLink para tareas de varias GPU. La 6.3.0 hizo que exec_timeout y queue_timeout fueran por grupo, así una simulación atascada ya no mata a los grupos de entrenamiento hermanos.
Datos. El proyecto describe conjuntos de datos direccionables por contenido, con deduplicación que según sus propias cifras recorta el almacenamiento entre 10 y 100 veces.
Seguridad e identidad. Desde la 6.2.8 viene con un complemento de autorización RBAC, integración con proxy OAuth2 con inicio de sesión por código de dispositivo y mapeo de usuarios desde el proveedor de identidad. La 6.3.0 agregó terminación TLS en la puerta de enlace Envoy e identidad de carga de trabajo en la nube (Azure Workload Identity, AWS IRSA y Pod Identity), de modo que los servicios ya no montan las llaves de almacenamiento como secretos de Kubernetes. La 6.3.1 restringió el rol osmo-user por defecto al grupo por defecto.
Integración con agentes. El repositorio incluye un AGENTS.md, un directorio de habilidades y una guía de despliegue MCP. En GTC 2026 NVIDIA señaló que OSMO se integra con Claude Code, OpenAI Codex y Cursor para que los agentes de programación puedan enviar, monitorear y depurar los flujos.
Lo que conviene saber antes de migrar
La línea de comandos osmo dataset y la API /datasets quedaron obsoletas en la 6.3.0 y están marcadas para eliminarse en la 6.4. El reemplazo son las salidas de conjuntos de datos gestionadas por el propio flujo de trabajo.
La versión más reciente es la 6.3.1, de junio de 2026. El orquestador viene rodado sobre GR00T, Isaac Lab, Isaac Sim e Isaac ROS, y existen integraciones con Azure y Nebius. El código, las versiones, el recetario y la página del producto están publicados.
¿Qué gana un laboratorio en Chile?
El arranque rápido local es el punto de entrada barato. Levanta el plano de control completo en una sola estación de trabajo con KIND, sin clúster y sin nube, según la guía de despliegue del proyecto. Eso importa acá, donde el acceso a GPU de centro de datos se arrienda por hora y cada hora cuenta. Y el mismo archivo YAML que se prueba en ese notebook es el que después corre sobre EKS, AKS o un clúster propio sin conexión, así que lo aprendido en la maqueta no se bota al cambiar de escala.