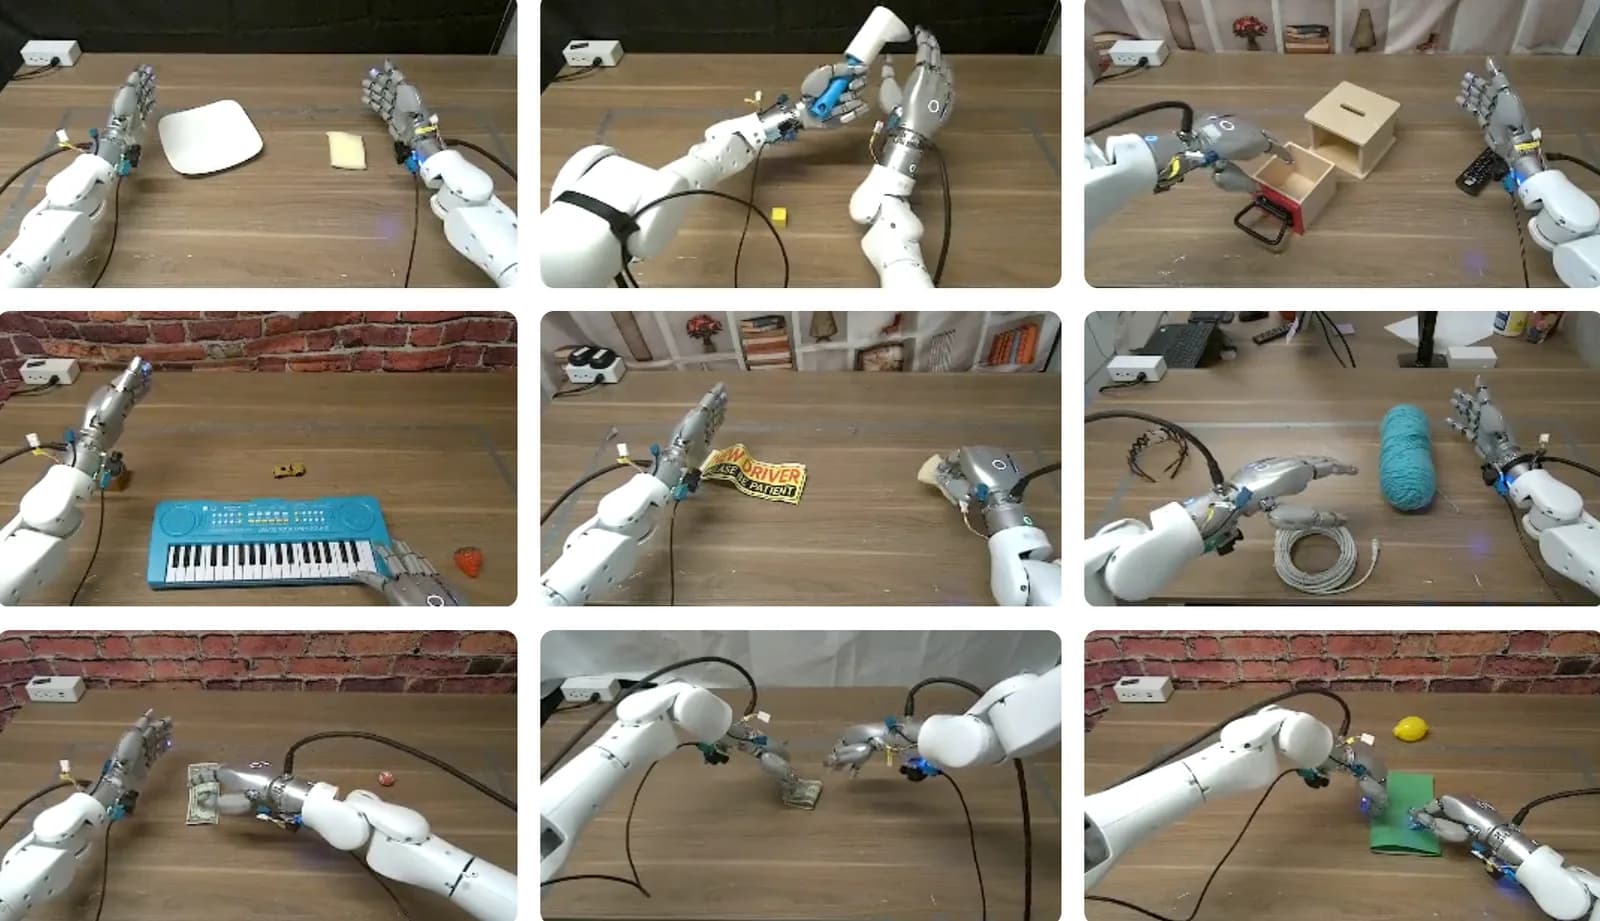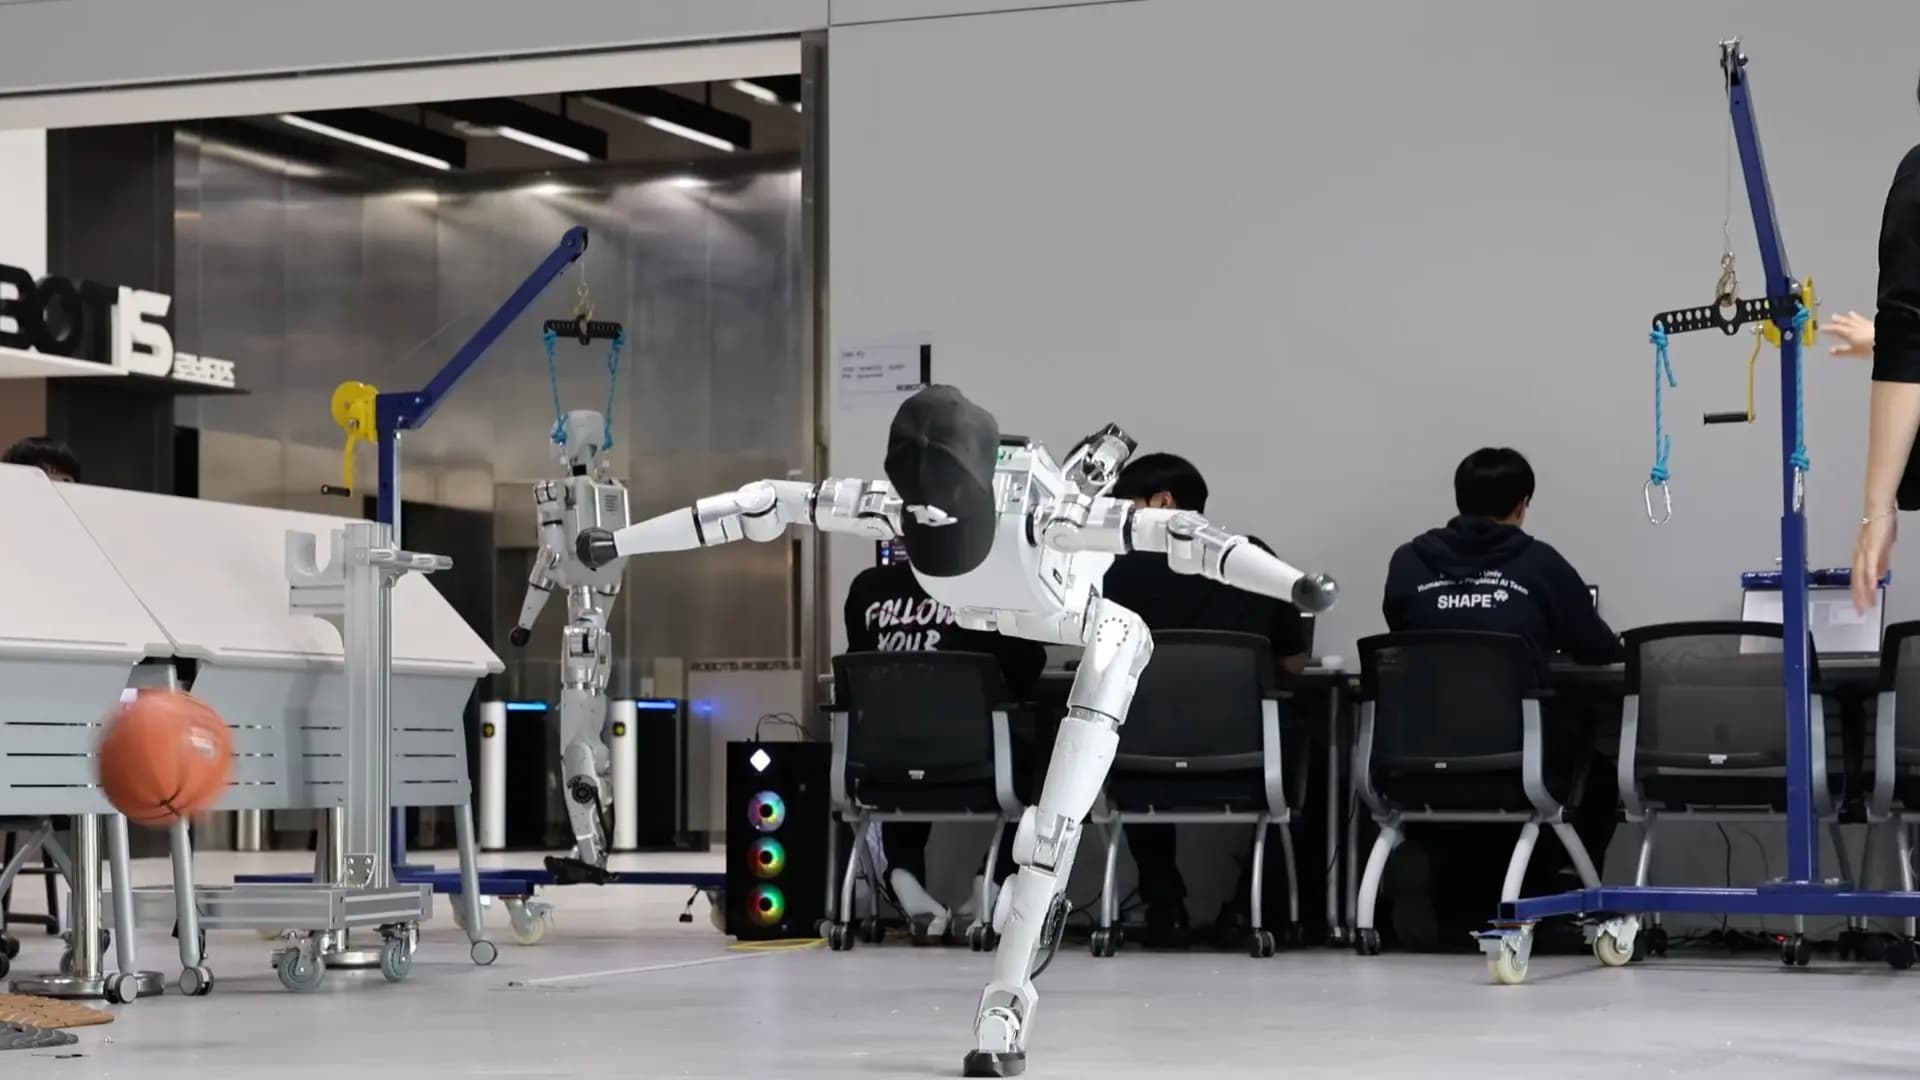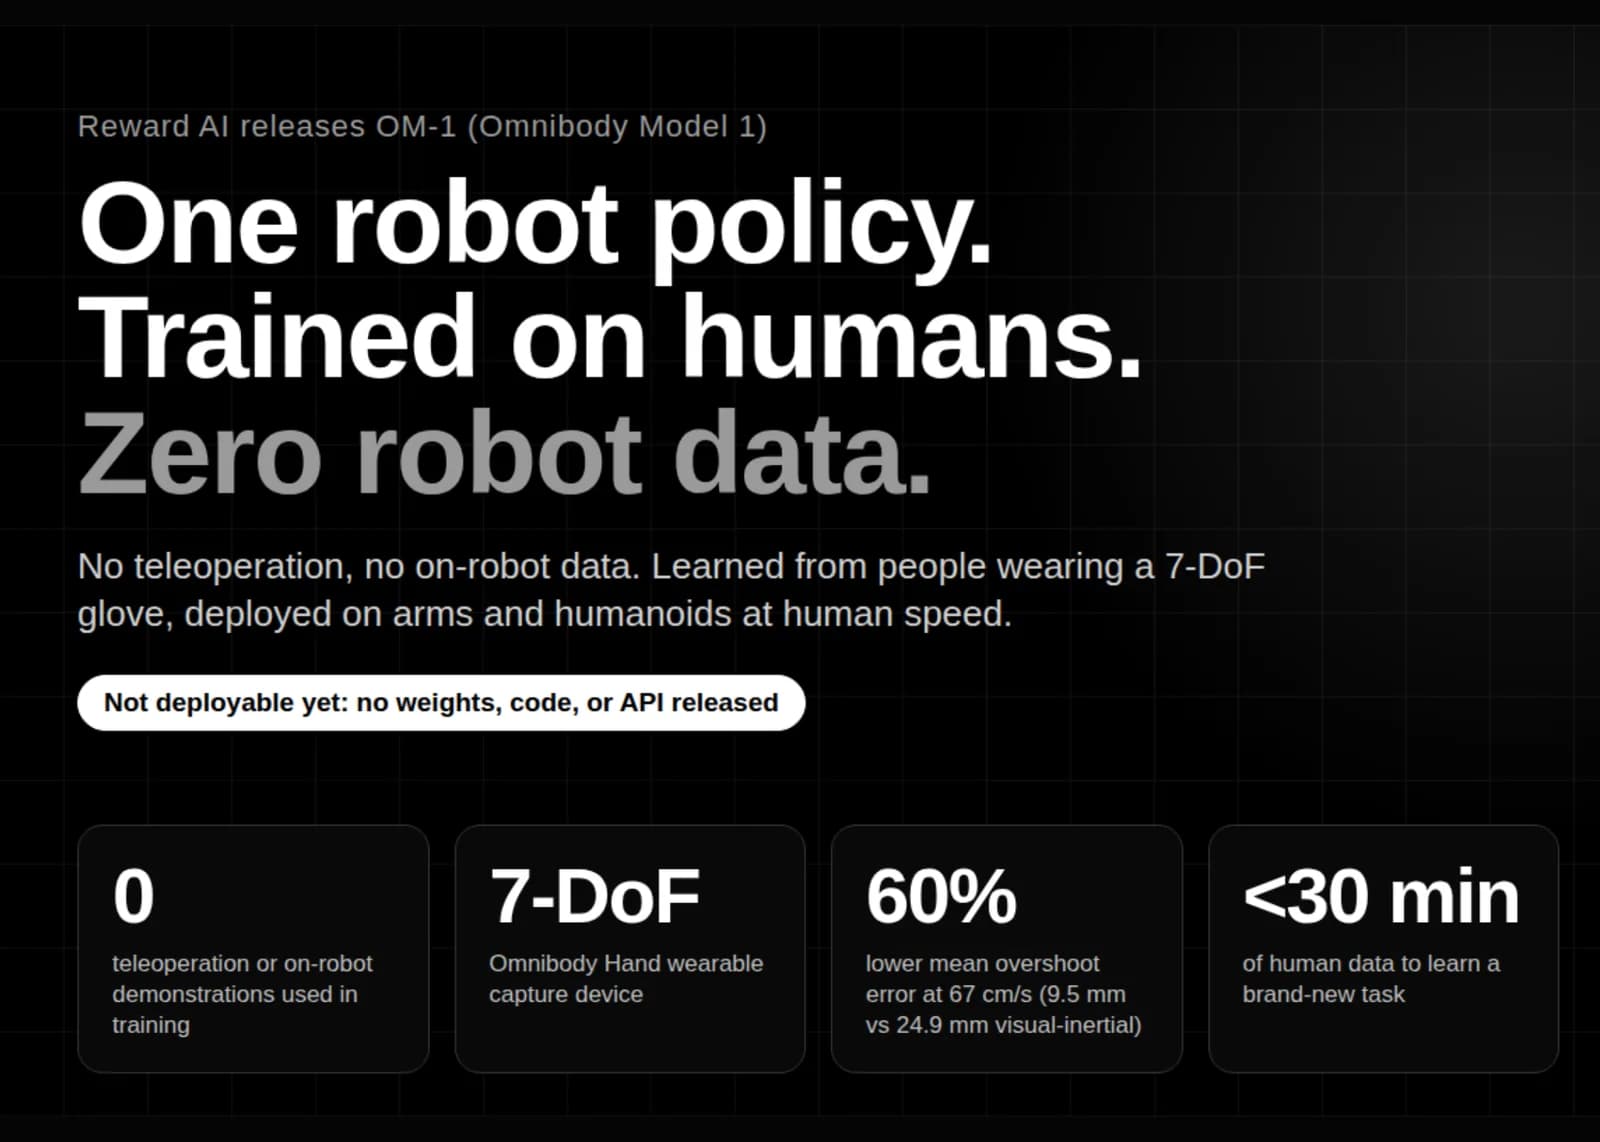
Reward AI, una startup de robótica cuyo equipo firmó antes DexCap, HumanPlus y ALOHA, liberó OM-1, abreviatura de Omnibody Model 1. Es una política de manipulación de propósito general que aprende de personas que llevan puesto un guante sensorizado y después corre en brazos industriales y humanoides a velocidad humana. Lo que la distingue es lo que no entra en el entrenamiento, porque no hay datos de teleoperación ni datos tomados desde el robot. El principio que sigue el sistema es "un modelo, una interfaz de datos, cualquier cuerpo".
¿Se puede usar? No. OM-1 es la política interna de Reward AI. No se publicaron pesos, código, dataset ni API, así que ningún desarrollador puede correrla todavía en su propio hardware.
¿Por qué descartar el dato del robot?
La mayoría de las políticas fundacionales de robótica se entrenan con datos teleoperados o recogidos por el propio robot, lo que amarra el conjunto de datos a un solo cuerpo. Reward AI sostiene que la manipulación a nivel humano no va a salir de acumular más de esos datos ni de más cómputo, y cita el "More Is Different" de Anderson. En su lugar, captura, aprendizaje y control se diseñan como una sola cadena, de manera que las demostraciones grabadas hoy puedan entrenar cuerpos robóticos que todavía no existen.
Omnibody Hand, un guante de 7 grados de libertad
La base del sistema es Omnibody Hand, un dispositivo vestible que extiende el trabajo previo del equipo en DexCap sobre captura de movimiento portátil. En vez de copiar la mano humana articulación por articulación, es un diseño de siete grados de libertad armado alrededor de las funciones que importan, es decir elegir puntos de contacto, reorientar objetos dentro de la mano y pasar de un agarre de precisión a uno de fuerza. Captura la pinza entre pulgar e índice, la flexión de ambos dedos y el movimiento acoplado del medio, el anular y el meñique en las articulaciones metacarpofalángicas.
La ergonomía se trata como un problema de calidad del dato. Un dispositivo que se resbala o que restringe a quien lo usa produce un agarre compensado, o sea un dato malo. Un mecanismo de flexión distal absorbe las diferencias de largo entre dedos, así que no hay que ajustarlo usuario por usuario.
Capturar el contacto a velocidad humana
One Data Interface convierte el movimiento de quien lleva el guante en datos de entrenamiento, sin montaje previo y sin supervisor. El objetivo de diseño es el clasificado en cinta transportadora, donde una persona ubica, agarra y lanza un objeto en una fracción de segundo. Para cubrir la interacción completa, el guante combina sensado táctil de alta frecuencia, sensado de proximidad para la fase previa al contacto y cámaras de obturador global montadas en la mano, que sostienen el contexto durante movimientos rápidos.
¿Cuánto mejora el seguimiento de la mano?
Acá está el primer resultado cuantitativo que reporta Reward AI. El seguimiento visual inercial es la opción habitual, pero su precisión en los cambios bruscos de dirección queda limitada por la tasa de actualización visual. Reward AI lo refuerza con sensado electromagnético más compensación de perturbaciones.
Movieron ambos sistemas entre dos topes mecánicos a ocho velocidades, de 3 a 67 cm/s, promediando diez corridas en cada una.
| Seguimiento | Error medio de sobrepaso a baja velocidad | A 67 cm/s |
|---|---|---|
| Electromagnético | cerca de 0,4 mm | 9,5 mm |
| Visual inercial | cerca de 2,1 mm | 24,9 mm |
Eso es una reducción de 60% en la velocidad más alta, con una dispersión más angosta entre corridas. La fuerza se registra a lo largo de la misma trayectoria, así que las demostraciones cargan el esfuerzo además del recorrido.
Una política, una sola etapa de entrenamiento
OM-1 aprende a generar acciones del robot directamente desde el movimiento humano, en vez de enrutar el comportamiento a través de un robot intermedio. Como cada demostración llega en el mismo formato, no hay separación entre preentrenamiento y postentrenamiento. La primera demostración que se grabó y la más reciente entrenan una sola política en una sola etapa.
Las entradas son los flujos multimodales del guante, o sea imágenes, señales táctiles, proximidad entre dedos y trayectorias de pose de la mano. Cada modalidad se procesa a la frecuencia nativa de su sensor en vez de bajarla a una frecuencia común, así que las señales táctiles y de movimiento de alta frecuencia sobreviven junto a la visión, que va más lenta. Las salidas llevan dirección de movimiento, velocidad, fuerza y el instante de eventos como el inicio del agarre. Reward AI dice haber construido una arquitectura nueva para inferencia eficiente, aunque no entrega detalles de arquitectura ni cantidad de parámetros.
¿Cómo se adapta a cualquier cuerpo?
Debajo de la política hay una capa de control de alta frecuencia, entrenada con aprendizaje por refuerzo en simulación para manejar dinámicas que dependen de velocidad y aceleración, perturbaciones externas y retardos del sistema. Un controlador clásico al que una carga inesperada saca de su referencia no se recupera. Esta capa mantiene la referencia y se reacomoda, y eso es lo que permite que un robot abra una puerta de refrigerador completamente cerrada o levante cajas de peso desconocido.
La capa de control corre en su propio reloj y sigue funcionando mientras la política calcula las acciones siguientes, así que la latencia de inferencia nunca frena el movimiento. Como dos predicciones sucesivas pueden no empalmar de manera suave, optimiza en línea la transición entre ambas. El mismo espacio de acción cubre manipulación y navegación para robots móviles.
Resultados
Reward AI reporta que OM-1 toma una tarea nueva, incluidas dinámicas difíciles y horizontes largos, a partir de menos de 30 minutos de datos humanos, y lo atribuye a la cadena completa antes que a la política sola. Su página institucional afirma que todos los clips publicados corren a velocidad real y que el modelo abarca brazos, humanoides con piernas y manipuladores móviles con ruedas. No hay tasas de éxito, ni comparaciones contra bases públicas, ni paper, así que estas afirmaciones se sostienen en demostraciones y no en benchmarks.