Un estudio de investigadores de Nvidia describe SoL-Pi, un sistema que optimiza de forma automática el arnés de los agentes de programación, la capa de control que se ubica entre el modelo y su entorno. Según los autores, el consumo de tokens baja casi a la mitad y el rendimiento se mantiene más o menos igual. The Decoder publicó los detalles el 26 de septiembre de 2026.
Mientras más tiempo trabaja un agente de IA sin supervisión, más caro sale. Las predicciones sueltas se convierten en cadenas largas de razonamiento, llamadas a herramientas y ciclos de retroalimentación, y el gasto en tokens se dispara en el camino.
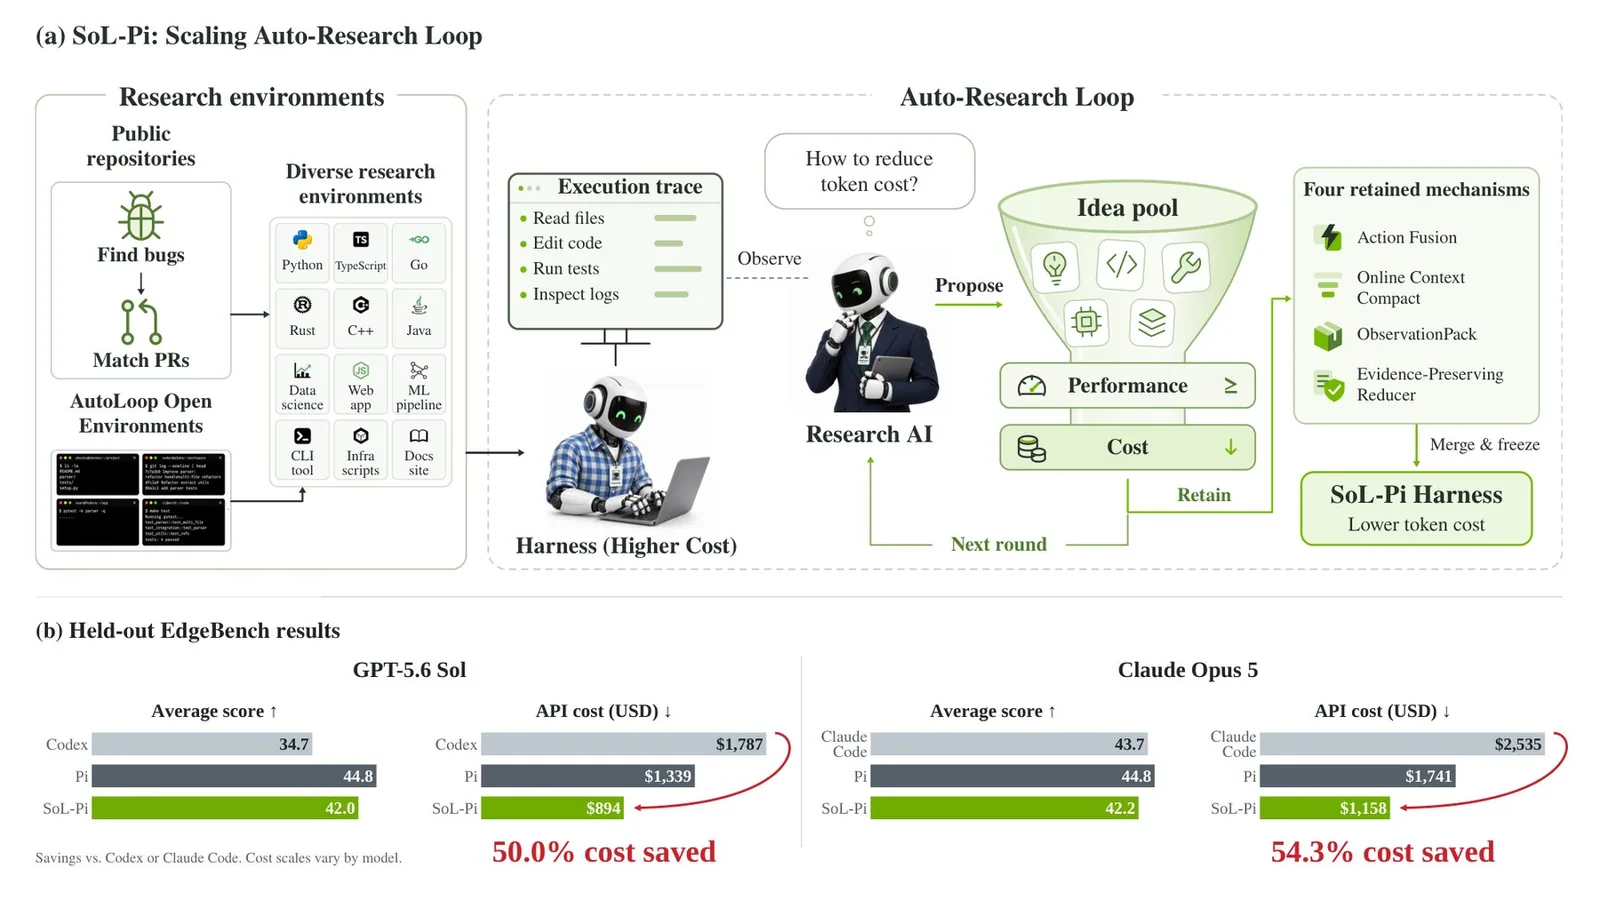
El trabajo de Nvidia ataca ese costo en el arnés y deja el modelo intacto. Esa capa es la que usan sistemas como Codex, Claude Code u OpenClaw, y decide cómo ve el agente los estados, cómo ejecuta acciones y cómo procesa la retroalimentación. Un agente investigador analiza las trazas de otro agente, propone cambios al arnés y conserva solo los que mantienen el rendimiento mientras bajan el costo. En EdgeBench, SoL-Pi ahorra 50% frente a Codex y 54,3% frente a Claude Code.
La mayoría de los métodos de eficiencia hasta ahora apuntaban a abaratar cada token, con kernels de atención más rápidos, mejor infraestructura de servicio, compresión de modelos como la cuantización o el cambio a modelos más baratos.
¿Cómo busca SoL-Pi un arnés más liviano?
Optimizar el arnés es difícil en la práctica porque el uso de herramientas, el manejo del contexto, la verificación y la lógica para abortar están muy acoplados. Un cambio que ahorra tokens en un lugar puede provocar errores en otro o simplemente mover el costo a una fase posterior. Lo habitual es que una persona revise trazas de ejecución largas y traduzca a código los patrones de falla que se repiten.
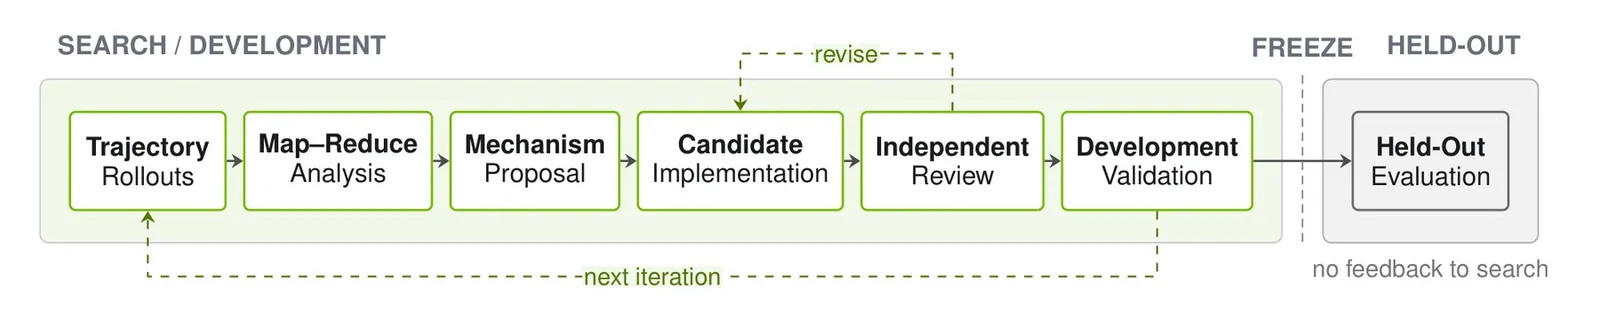
SoL-Pi automatiza ese trabajo. Un agente investigador observa las trazas de otro agente, propone modificaciones y las prueba en entornos preparados. Unos chequeos de capacidad y de eficiencia deciden qué candidatos sobreviven. Según los autores, el enfoque se inspira en la automejora recursiva.
El sistema exploró 152 direcciones sobre 535 entornos ejecutables, de los cuales 495 son tareas derivadas de pares de issue y pull request de GitHub y 40 son casos de prueba sintéticos. En total generó más de 3.000 corridas y más de 60.000 interacciones entre agente y entorno. Los investigadores dicen que esa escala muestra lo amplia que fue la búsqueda, pero que buscar más no garantiza mejores resultados.
Ahí hay un riesgo. Trabajos anteriores mostraron que los arneses optimizados de forma automática tienden a sobreajustarse a sus tareas de entrenamiento y aportan poco frente a tareas desconocidas.
SoL-Pi lo enfrenta separando por completo la retroalimentación de la búsqueda y la evaluación. Los investigadores usaron EdgeBench como benchmark de prueba y lo aislaron del proceso de búsqueda. De sus 51 tareas públicas, 11 sirvieron para validar una sola vez a los candidatos terminados. Las otras 40 quedaron reservadas para la evaluación final, y esos resultados nunca volvieron a la búsqueda. La evaluación reservada ocurre recién cuando el arnés ya está congelado.
Los cuatro mecanismos que salieron de la búsqueda
La búsqueda dejó cuatro mecanismos.
- Action Fusion une dos pasos consecutivos en uno, por ejemplo una edición de código seguida de una corrida de pruebas, y así elimina una llamada completa al modelo de lenguaje.
- Online Context Compact corre después de cada paso de planificación y recorta el contexto acumulado cuando puede hacerlo sin perder información importante.
- ObservationPack archiva las salidas largas de las herramientas y, en los pasos siguientes, deja un resumen corto en vez de reenviar el texto completo cada vez.
- Evidence-Preserving Reducer manda los registros largos de errores y de pruebas a un modelo más barato que los condensa en los hallazgos principales. Un paso de verificación automática recupera las pistas importantes que se hayan escapado.
¿Cuánto ahorra y cuánto rinde?
En las 51 tareas públicas de EdgeBench, SoL-Pi rinde más o menos igual que el arnés Pi original, según los investigadores. Cuánto baja el consumo depende de la configuración.
| Configuración | Tokens frente a Pi | Puntaje frente a Pi |
|---|---|---|
| Variante de eficiencia (los cuatro mecanismos) | 49% menos | 93,7% del puntaje de Pi |
| Variante de rendimiento (el mejor mecanismo solo) | menos tokens | 5,3% sobre Pi |
Entre las dos variantes, el uso de tokens baja entre 44,7% y 49%. La variante de eficiencia costó 894 dólares en vez de los 1.339 dólares de Pi, con un puntaje algo menor.
En dinero, los autores estiman un ahorro de 8,75 a 13,50 dólares por hora frente a los arneses nativos de Codex y Claude Code, y de 4,36 a 5,71 dólares por hora frente a Pi, calculado con los precios actuales de las API.
Los investigadores construyeron el sistema usando solo GPT-5.6 Sol y después lo aplicaron sin cambios a Opus 5. Con ese modelo conservó 94,3% del rendimiento de Pi con ahorros parecidos. Los mecanismos se activaron menos veces y con menos intensidad bajo Opus 5, algo que los autores atribuyen a que el arnés se optimizó solo con trayectorias de GPT-5.6 Sol.
Fuera de EdgeBench el resultado es mixto
En otros benchmarks el panorama cambia. En 63 tareas de CPU de Terminal-Bench 4, SoL-Pi resolvió solo 15, mientras Codex y Pi resolvieron 18 cada uno. Aun así, el costo total quedó cerca de un cuarto por debajo del de Pi.
En las tareas de Lean 4 verificadas formalmente de la Olimpiada Internacional de Matemática 2026 (IMO 2026), el sistema resolvió tres de seis problemas con el menor costo por problema resuelto. En un experimento de optimización de kernels, un enjambre de 20 trabajadores SoL-Pi obtuvo el mejor resultado y bajó el costo en 26,8% frente a un enjambre comparable de trabajadores Pi.
Las ganancias de eficiencia tienen un precio, porque un contexto más corto puede reducir la reutilización de la caché de prompts. Aun así, el costo total de una de las corridas de prueba bajó de 1.339 a 894 dólares.
Hacia adelante, los autores proponen preentrenar el arnés sobre muchas tareas, tal como se preentrenan los modelos, y usar un arnés ya liviano para abaratar la búsqueda de su sucesor. Ellos mismos llaman a esa mejora recursiva de la eficiencia una visión y no un hallazgo del estudio actual.
El arnés pesa en la cuenta
Cuánto influye el arnés en el costo de un agente quedó a la vista en agosto, en una prueba de la empresa de herramientas Composio. Corrió Deepseek V4 Flash sobre cuatro frameworks de agentes, entre ellos Claude Code y Oh My Pi, basado en Pi. El costo por tarea resuelta varió casi al triple con el mismo modelo haciendo el trabajo.
La presión sobre precios y optimización sigue subiendo porque los agentes consumen cada vez más tokens. Según Peter Walker, analista de OpenRouter, el uso de tokens en tareas agénticas creció 14 veces desde febrero de 2026, y casi 70% de eso viene de prompts en caché.
La compresión de contexto como la que usa SoL-Pi puede tener efectos secundarios. Un estudio encontró que la compresión conserva en promedio solo 17% de las instrucciones del usuario. Los agentes en paralelo también suben el costo. Eric Provencher, desarrollador de Codex, advirtió hace poco que más de dos subagentes casi siempre queman tokens sin mejorar la calidad, porque pasan la mayor parte del tiempo revisando el trabajo del otro.