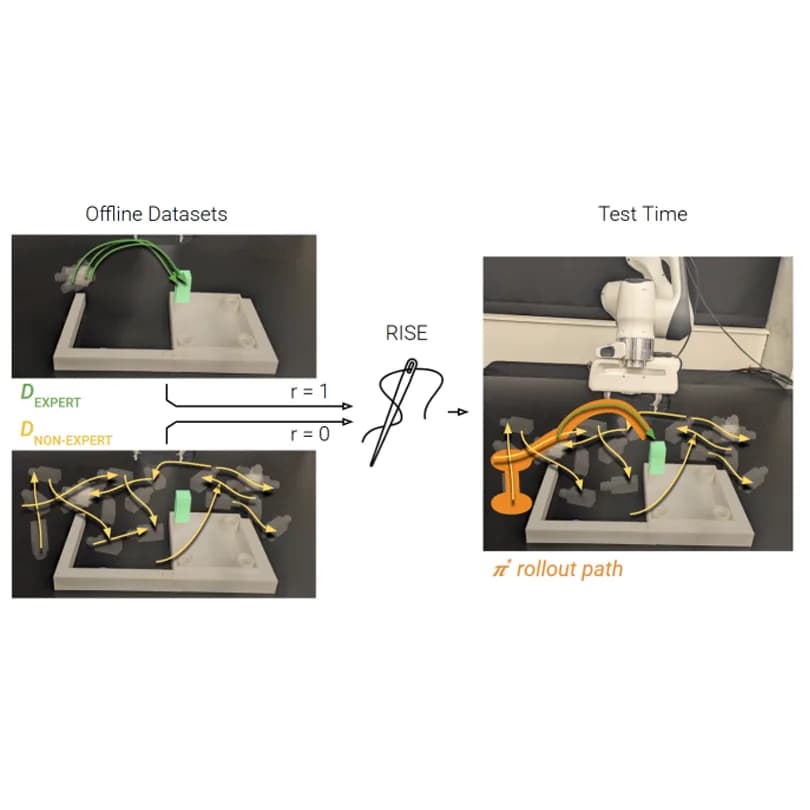
El aprendizaje por imitación ya demostró que sirve para enseñarle a un robot tareas complejas a partir de demostraciones humanas expertas. Su límite conocido es la dependencia de esos datos, que tienen que ser de alta calidad y específicos de la tarea, lo que restringe la capacidad de adaptarse a la variedad de configuraciones de objetos y de escenarios que aparecen en el mundo real. El Toyota Research Institute publicó un trabajo que propone rodear ese límite sin salir a grabar más demostraciones perfectas.
Del otro lado están los datos no expertos, que es casi todo lo demás que queda guardado en un laboratorio. Datos de juego libre, demostraciones subóptimas, tareas completadas a medias y ejecuciones de políticas que no eran buenas. Ese material cubre mucho más terreno y cuesta menos de recolectar, pero los enfoques convencionales de aprendizaje por imitación no logran aprovecharlo.
¿Por qué no bastaba el refuerzo fuera de línea?
La propuesta del instituto es que, con las decisiones de diseño correctas, el aprendizaje por refuerzo fuera de línea funciona como herramienta para exprimir esos datos y mejorar el desempeño de las políticas de imitación.
El equipo advierte que los enfoques estándar de refuerzo fuera de línea resultan poco efectivos justamente ahí, cuando la cobertura de datos es escasa, que es la situación habitual en el mundo real. Lo que muestran es que modificaciones algorítmicas simples permiten usar ese material, sin agregar supuestos de peso.
Qué cambia en las tareas de manipulación
La clave técnica está en ampliar el soporte de la distribución de la política. Con eso, los algoritmos de imitación reforzados con aprendizaje fuera de línea resuelven las tareas de manera robusta y muestran un comportamiento de recuperación y de generalización bastante mejor.
En tareas de manipulación, esas modificaciones amplían el rango de condiciones iniciales en las que la política aprendida logra completar el trabajo cuando se incorporan datos no expertos. Los métodos además aprovechan todo lo recolectado, incluidas las demostraciones parciales y las subóptimas, para reforzar el desempeño dirigido a la tarea.