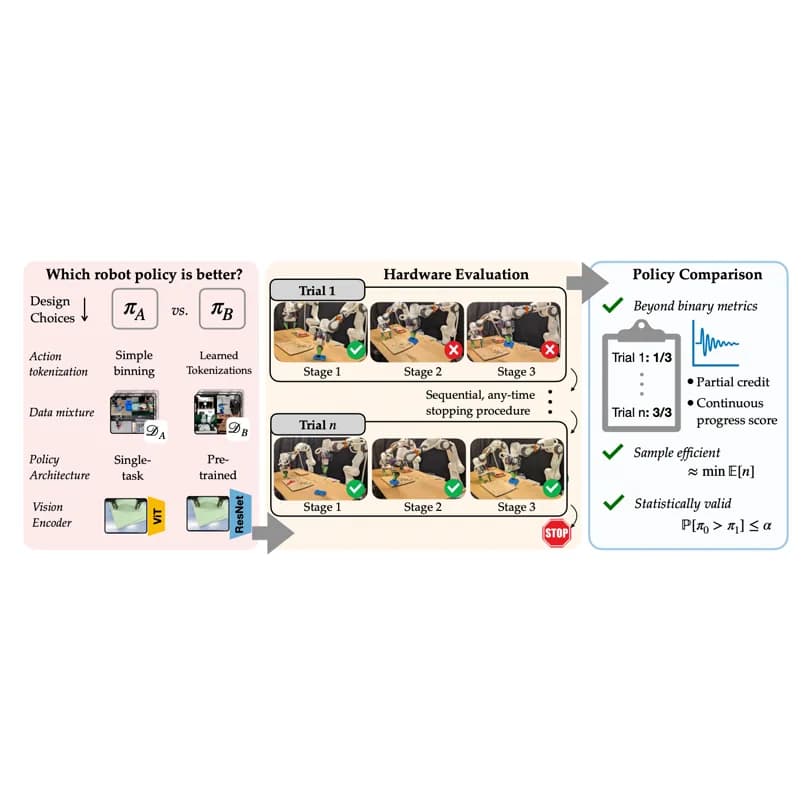
Las políticas generalistas de manipulación robótica son cada vez más capaces, y su evaluación sigue limitada a un número pequeño de repeticiones con el robot físico. Esa restricción de recursos en las pruebas del mundo real es la que empuja el trabajo que presentó el Toyota Research Institute, y que apunta a dos cosas a la vez. Medidas de desempeño que digan más, y procedimientos de evaluación confiables y eficientes para valorar de qué es capaz un modelo y comparar el avance del campo.
El trabajo presenta un marco de comparación de políticas de robots que es eficiente en muestras, estadísticamente riguroso y aplicable a un conjunto amplio de métricas de evaluación de las que se usan en la práctica.
¿Cómo se corta el experimento antes de tiempo?
El procedimiento de prueba se apoya en la inferencia segura y válida en cualquier momento, conocida por su sigla en inglés SAVI. Es secuencial, así que el evaluador puede detenerse apenas acumuló evidencia estadística suficiente para llegar a una decisión con un nivel de confianza fijado de antemano.
La diferencia con lo anterior está en el alcance. Los trabajos previos se desarrollaron para el éxito binario, es decir, la tarea salió o no salió. Este enfoque unificado cubre un rango ancho de métricas informativas, desde el avance discreto de la tarea con crédito parcial hasta medidas continuas de recompensa por episodio o de suavidad de la trayectoria, y abarca problemas de comparación tanto paramétricos como no paramétricos.
¿Cuánto trabajo de evaluación se ahorra?
Los autores validaron el método sobre datos de evaluación simulados y del mundo real. Frente a los métodos estándar por lotes, la carga de evaluación baja hasta un 70%. Frente a los procedimientos secuenciales de última generación diseñados para resultados binarios, la reducción llega hasta un 50%. En ninguno de los dos casos se pierde rigor estadístico.
Hay un resultado empírico que conviene separar del ahorro. Las políticas que compiten entre sí se pueden distinguir más rápido cuando se mide el avance de la tarea con grano fino que cuando se usa la métrica binaria de éxito. O sea, la elección de la medida no es un detalle de presentación. Cambia cuántas corridas con el robot hacen falta para saber cuál de dos políticas es mejor.