
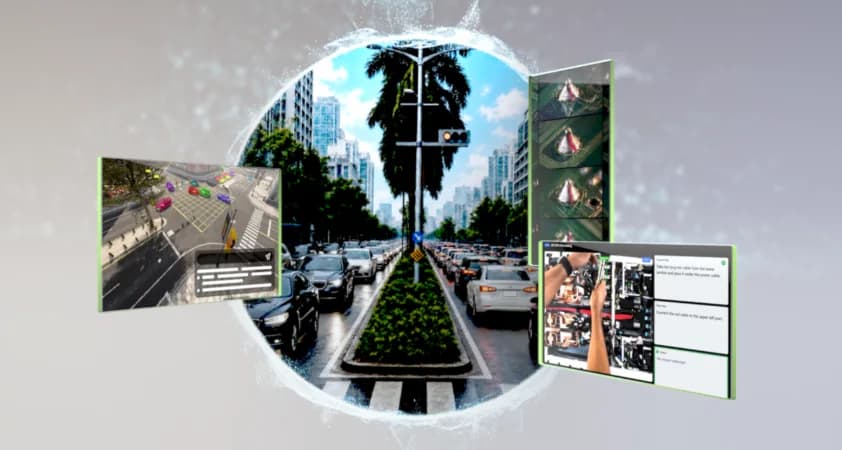
NVIDIA propone tres workflows para elevar la vision AI industrial
Con Omniverse y Metropolis, Roboflow llegó a 95% de precisión con 8 imágenes reales de defectos y Foxconn subió 3% el yield en líneas GB300 usando el blueprint VSS.
NVIDIA Blog
Cobertura de inteligencia artificial: modelos de lenguaje, agentes autónomos, hardware especializado, política regulatoria y aplicaciones empresariales. Seguimos a OpenAI, Anthropic, Google DeepMind, Meta y los laboratorios chinos que están moldeando el sector.
Con Omniverse y Metropolis, Roboflow llegó a 95% de precisión con 8 imágenes reales de defectos y Foxconn subió 3% el yield en líneas GB300 usando el blueprint VSS.
El stack full-stack de inferencia sobre GB300 combina Dynamo, TensorRT-LLM, NVFP4 y NVLink para multiplicar por 20 el throughput por GPU y desplomar el costo por token.

Anthropic presentó una plataforma para investigadores que conecta bases de datos, corre en infraestructura del laboratorio y usa un fact-checker para revisar citas antes de publicar.

El nuevo modelo agentic de Anthropic mejora en cada benchmark sobre Sonnet 4.6, se acerca a Opus 4.8 y en el test GDPval-AA v2 lo supera con 1.618 puntos frente a 1.615.

Google añade a la familia Nano Banana un modelo económico enfocado en pipelines de alto throughput y estrena Gemini Omni Flash para generar y editar video de hasta 10 segundos vía API.
Anthropic, Microsoft y NVIDIA declaran la disponibilidad general de Claude sobre GPUs Blackwell Ultra y redes Quantum-X800 InfiniBand en Microsoft Foundry para agentes empresariales.
El motor inteligente de Palantir corre modelos NVIDIA Nemotron en infraestructura aislada de redes inseguras, apuntando a las 3 millones de personas que trabajan en agencias civiles estadounidenses.
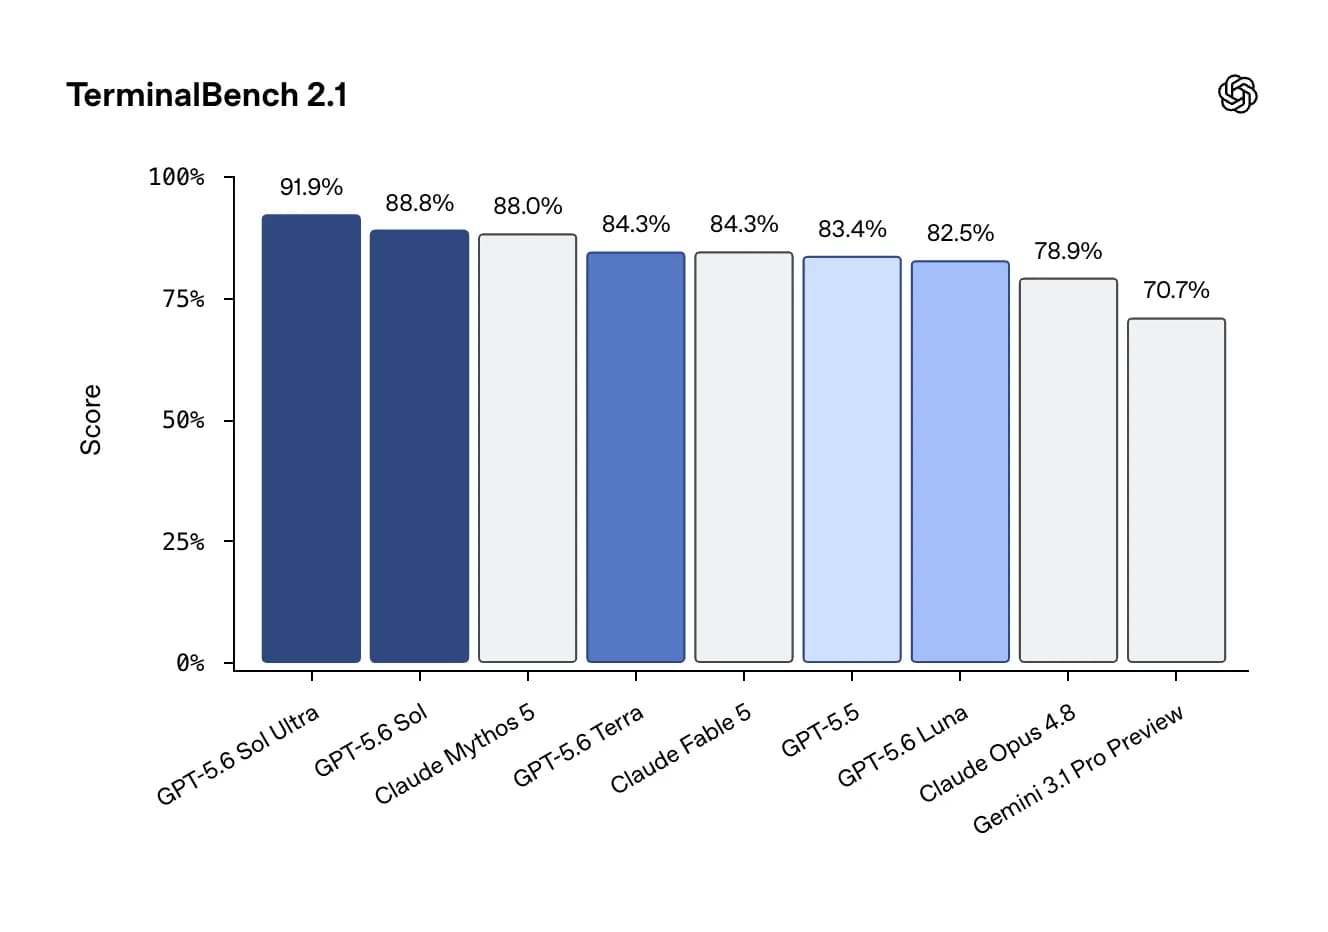
El lanzamiento limitado responde a un pedido del gobierno de EE.UU. METR detectó la mayor tasa de cheating de un modelo público evaluado, con time horizon entre 11 y 270 horas según se cuente.
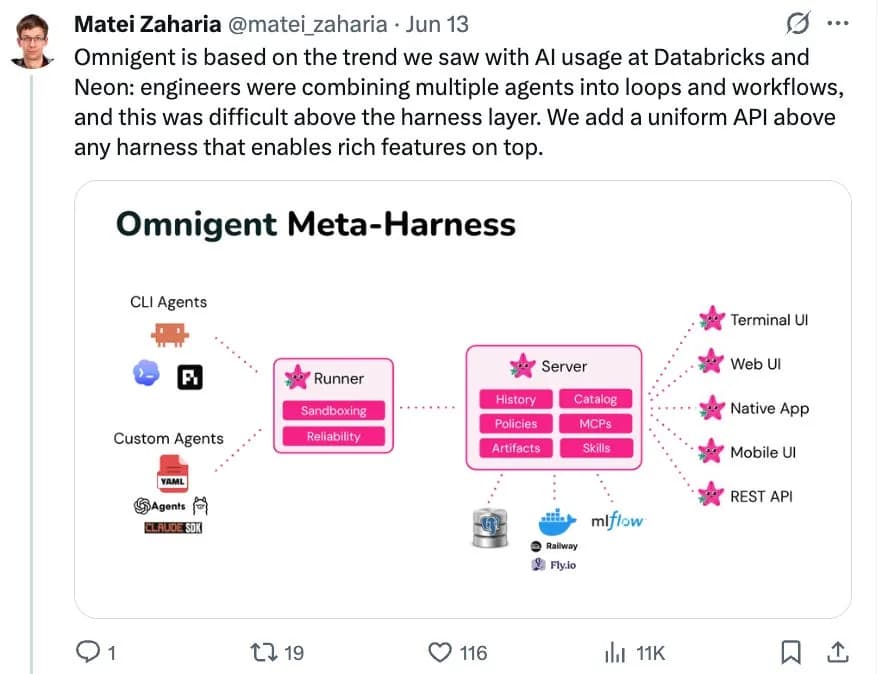
Matei Zaharia apuesta por una arquitectura open source y pluggable que pretende estandarizar cómo se orquestan agentes de código y conocimiento dentro de una organización.
El blueprint open source para agentes de IA de NVIDIA ya tiene una receta lista para Oracle Cloud Infrastructure: Terraform crea el clúster OKE y Helm instala backend, frontend y PostgreSQL.
Tras dos semanas de bloqueo, el secretario Howard Lutnick autoriza a un grupo selecto de corporaciones y agencias federales a usar Mythos 5, aunque Claude Fable 5 sigue suspendido.
Anthropic encuestó a 9.700 usuarios de Claude Chat, Cowork y Code; a 12 meses, 26% espera que la IA cubra entre 60% y 90% de sus tareas laborales.
En la nueva benchmark de Epoch AI y METR, GPT-5.5 alcanza 44% y Gemini 3.1 Pro un 32%; una tarea costó USD 2.600 y 19 días de inferencia continua sin intervención humana.
El equipo de NVIDIA reduce el checkpoint del modelo de 550B desde 1.121 GB en BF16 a 352 GB en NVFP4, con la técnica four-over-six que recupera 98,5% de la precisión sobre Blackwell.
Veinte empresas, entre ellas AWS, Anthropic, Google, NVIDIA y OpenAI, coordinan un equipo único de respuesta para evitar que la IA explote vulnerabilidades antes que los maintainers puedan parcharlas.
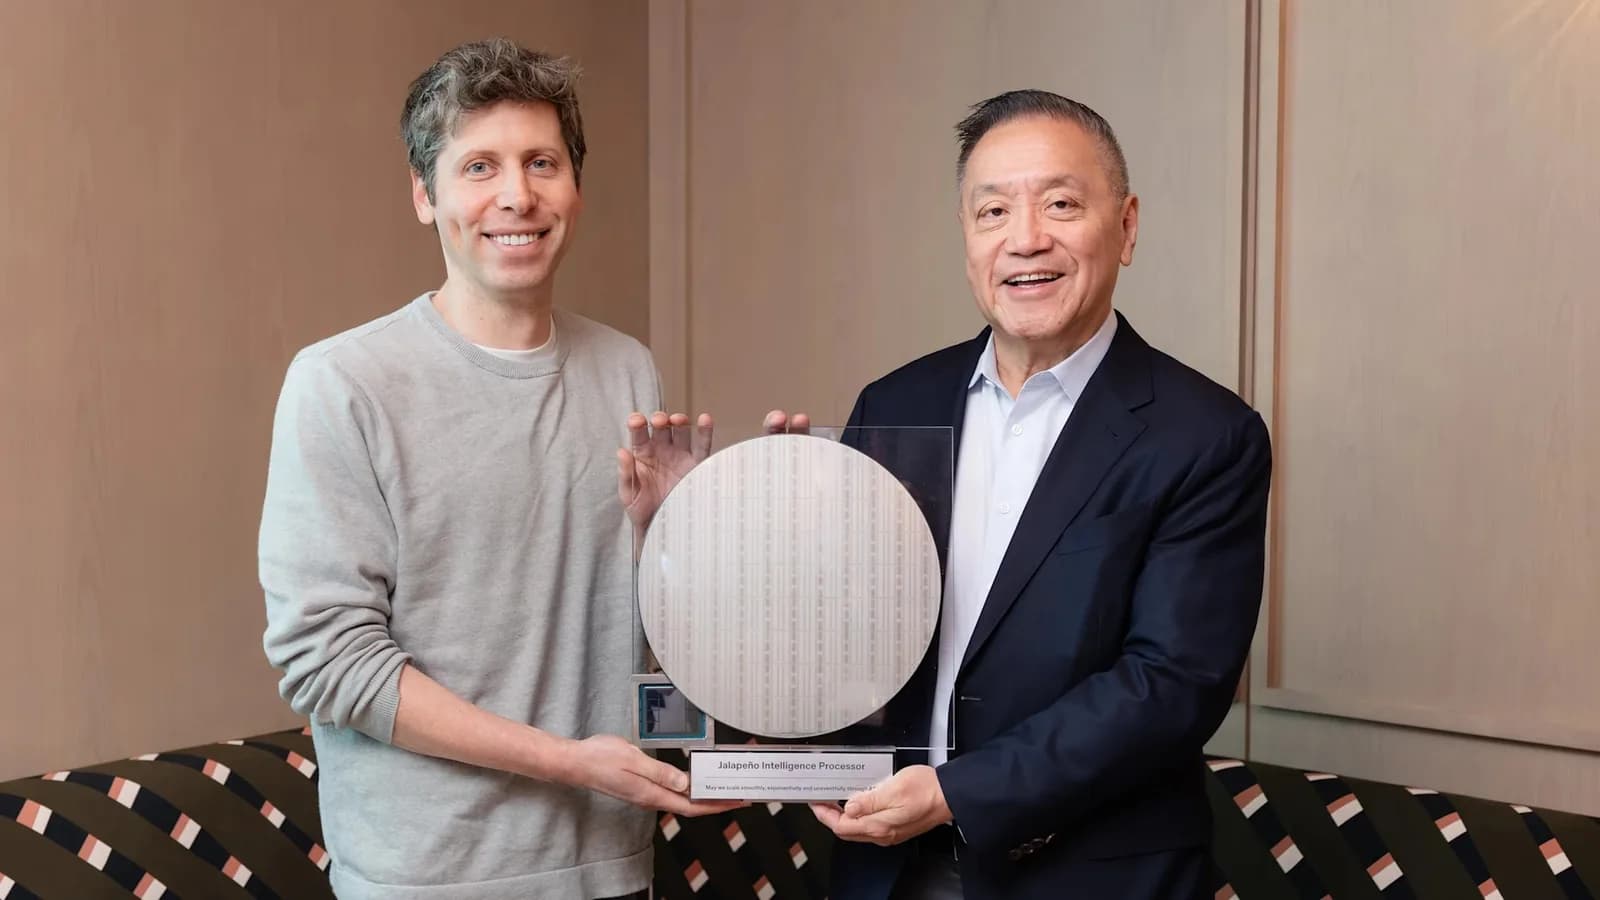
El ASIC diseñado a medida para inferencia llega nueve meses después del anuncio de la sociedad y promete rendimiento por watt mayor al estado del arte actual, según OpenAI.
El nuevo buque insignia de OpenAI lidera benchmarks de coding agéntico y matchea a Mythos en ciberseguridad, pero Washington bloquea el lanzamiento abierto y la empresa critica la decisión.
Matei Zaharia y Reynold Xin presentaron en el Data + AI Summit 2026 una capa común para Claude Code, Codex, Cursor y agentes internos, además de LTAP y Lakebase para reescribir la base de datos.
Las nuevas instancias suman hasta 8 RTX PRO 4500 Blackwell, 256 GB de memoria GPU y 700 Gbps en EFA, y NVIDIA cuVS pasa a default en OpenSearch Serverless.
VK_EXT_descriptor_heap simplifica la asignación de recursos para ray tracing y dynamic texture indexing, y trae paridad con D3D12 a los desarrolladores gráficos en NVIDIA.
La compañía propone un stack completo para que las fábricas de IA optimicen tokens por watt, desde 45°C de refrigeración líquida hasta scheduling consciente de energía.
El modelo Flash ahora ve y opera navegadores, móviles y escritorios por sí solo, con 78,4 en OSWorld y a la par de GPT-5.5.
El modelo chino de Zhipu AI resuelve 66% de 103 tareas de programación contra el 67% de Anthropic, pero quema casi el doble de tokens y suma latencia con 99 iteraciones por tarea.
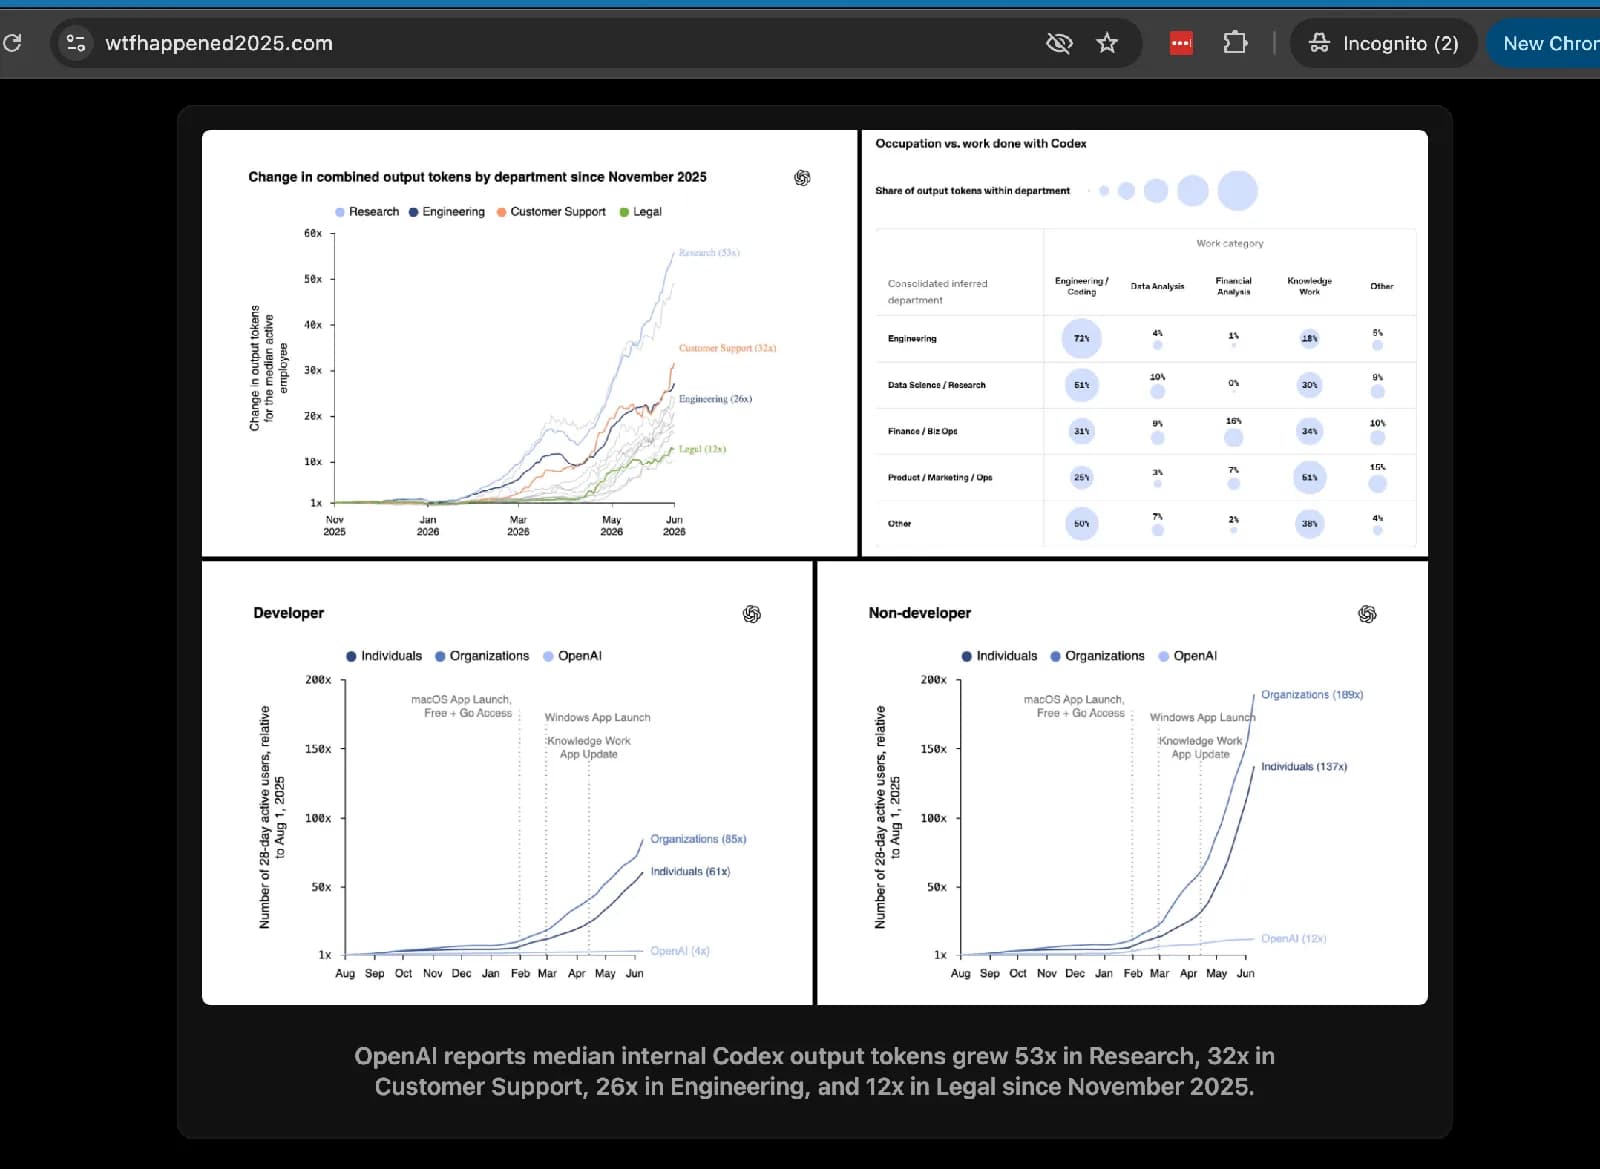
El reporte interno de OpenAI Economic Research detalla cómo el uso de Codex se profundizó entre noviembre de 2025 y junio de 2026 en investigación, soporte, ingeniería y legal.