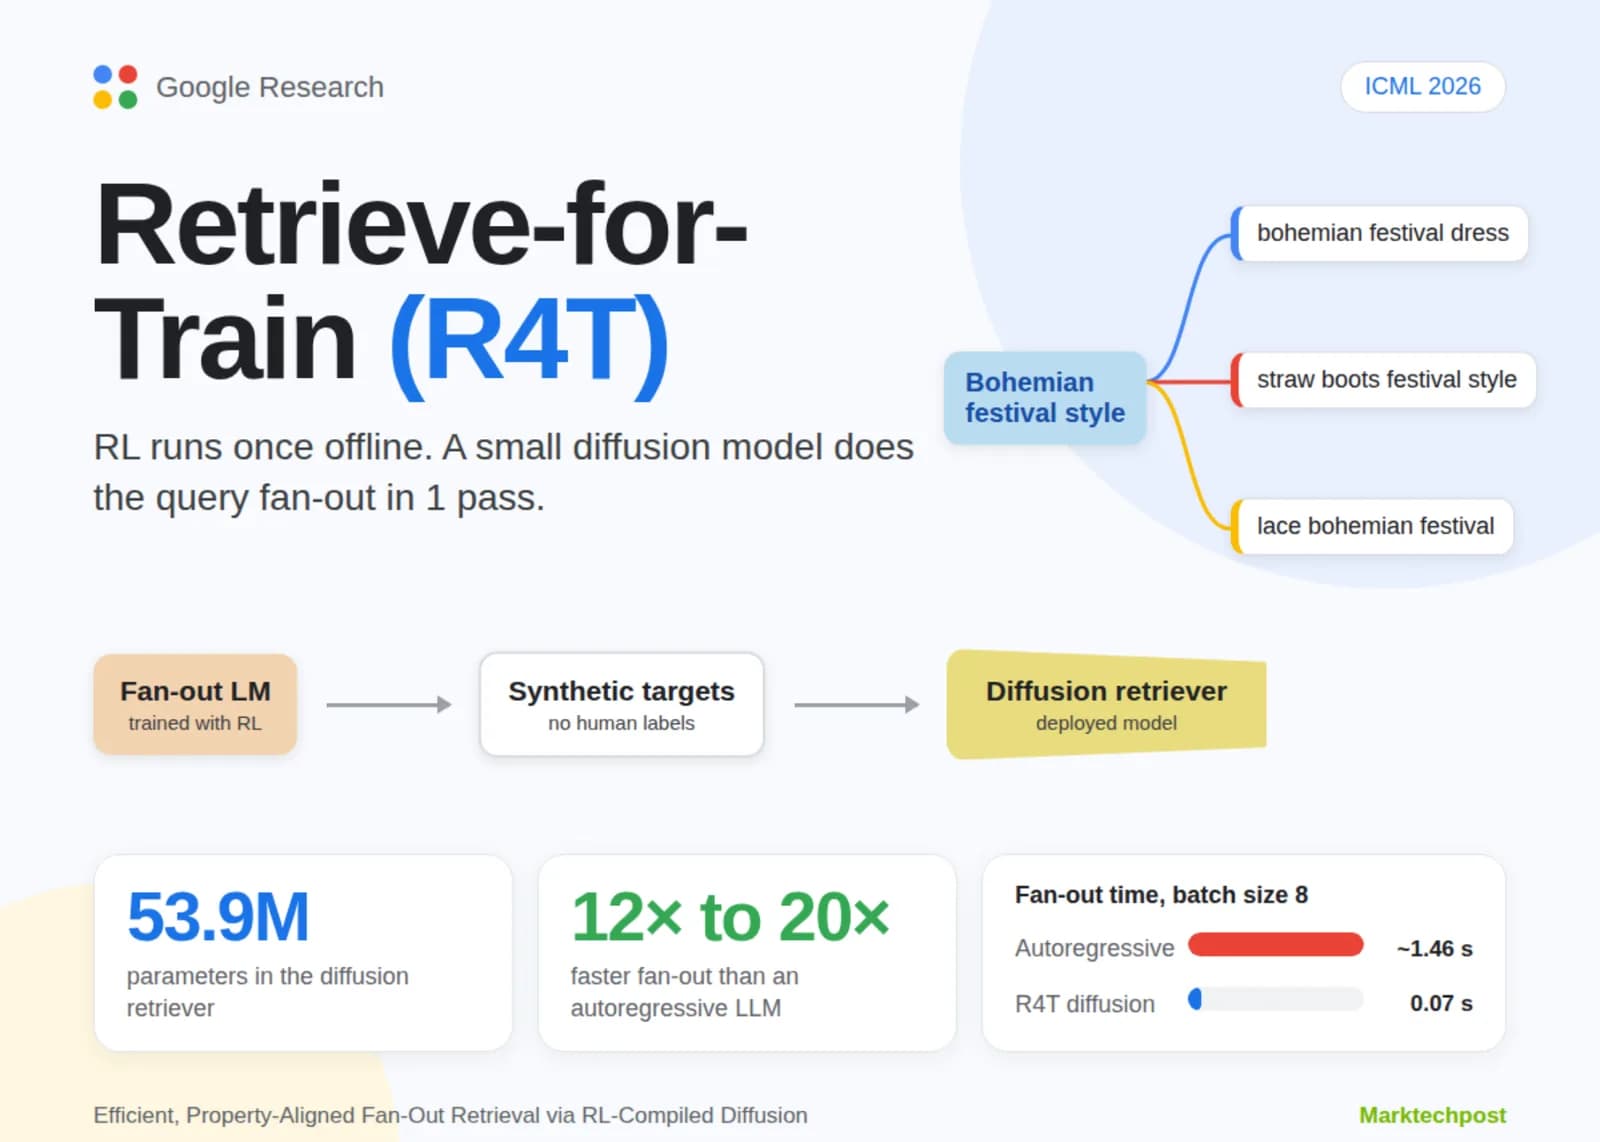
Los sistemas de búsqueda y recomendación necesitan cada vez más devolver un conjunto de resultados en lugar de una sola mejor coincidencia. Una consulta como "equipo de camping" debería traer una carpa, un saco de dormir, una cocinilla y una linterna frontal, y no diez carpas casi idénticas.
Google Research presentó Retrieve-for-Train, abreviado R4T, para ese problema. El marco usa aprendizaje por refuerzo una sola vez, fuera de línea, para aprender un buen abanico de consultas. Después destila ese comportamiento en un modelo de difusión pequeño que produce todas las direcciones de recuperación en una pasada. MarkTechPost cubrió el trabajo el 16 de septiembre de 2026.
¿Por qué falla el abanico estándar?
El abanico de consultas parte un pedido amplio en varias subconsultas. El equipo de investigación identifica dos problemas cuando un modelo de lenguaje genérico hace eso en tiempo de inferencia.
El primero es el colapso parafrástico. Para "estilo festival bohemio", Qwen3-4B sin entrenamiento previo escribió "moda festival bohemio" y "ropa bohemia de festival". Esos casi sinónimos recuperan una lista homogénea.
El segundo es la latencia. La generación autorregresiva sumada a llamadas repetidas de recuperación es lenta. El muestreo Best-of-N mejora la calidad y multiplica el costo de inferencia.
Las tres etapas de R4T
- Entrenamiento del modelo de abanico. Un modelo de lenguaje de abanico, llamado FOLM, genera k subconsultas. Un recuperador denso congelado las ejecuta. Una recompensa a nivel de conjunto puntúa todo el conjunto recuperado y no cada elemento por separado.
- Síntesis de supervisión. El FOLM ya entrenado muestrea 128 abanicos por consulta a temperatura 0,9. Esos pares de consulta y conjunto objetivo se vuelven datos de entrenamiento sin ninguna etiqueta humana. Para tareas abiertas, los objetivos son incrustaciones del contenido recuperado. Para tareas composicionales, son incrustaciones de las subconsultas.
- Entrenamiento del recuperador difusivo. Un transformador de difusión de 53,9 millones de parámetros aprende a mapear la incrustación de una consulta a un conjunto completo de incrustaciones objetivo. Usa una formulación de varianza explosiva dentro del marco EDM. En inferencia genera todas las incrustaciones en una sola pasada no autorregresiva, y una búsqueda por vecino más cercano mapea después cada incrustación a elementos de la base de datos.
Cómo se diseñó la recompensa
Para la recuperación abstracta abierta, conocida como OAR, la recompensa combina tres términos ponderados. La fundamentación, con peso 0,6, penaliza la distancia entre la incrustación de cada subconsulta y el elemento más cercano de la base. La diversidad, con peso 0,2, se mide con el Vendi Score sobre elementos representativos recuperados. La alineación, también con peso 0,2, es la similitud coseno media entre cada subconsulta y la consulta original.
Para la recuperación composicional con supervisión débil, o WSCR, la recompensa es la fracción de elementos del conjunto de referencia que el abanico logra recuperar.
El estudio de ablación explica por qué los tres términos de OAR importan. Con la fundamentación sola, Gemma3-4B convergió a cadenas del tipo "line ending line ending line ending". Agregar la alineación aceleró el colapso todavía más, porque la política repetía paráfrasis de la consulta. Recién al sumar la diversidad se cerraron los dos atajos.
El entrenamiento usa GRPO con regularización PPO suave, que agrega penalizaciones KL hacia adelante y hacia atrás. Entre los ajustes están un tamaño de grupo de 8, una tasa de aprendizaje de 1×10⁻⁷ y un lote global de 512.
Resultados
Los experimentos usaron el conjunto de atuendos de moda Polyvore con un codificador matryoshka basado en CLIP a 128 dimensiones. También usaron un conjunto propietario de listas de reproducción curadas por expertos, con incrustaciones MuLan. Todos los métodos de abanico produjeron k igual a 10 subconsultas, y Best-of-N usó N igual a 5.
La calidad OAR la puntuó un modelo juez sobre escalas Likert de 5 puntos. En Polyvore, Gemma3-4B con R4T-FOLM promedió 49,1 contra 40,9 de Best-of-N y 38,5 sin entrenamiento previo. La diversidad subió de 56,0 en el caso base a 76,8, y R4T-Difusión retuvo buena parte con 74,3. En el conjunto de música, Gemma3-4B con R4T-FOLM promedió 58,1 contra 49,2 de Best-of-N. La fundamentación no se reporta para R4T-Difusión, porque ese modelo no produce subconsultas en texto.
Los resultados WSCR en Polyvore muestran un equilibrio entre cobertura y diversidad. R4T-FOLM sobre Qwen alcanzó 20,9 de Recall@5K y 64,6 de Hit@5K, contra 15,7 y 52,1 de Gemini-2.5-Flash. Su Vendi Score, en cambio, bajó a 27,5. Los autores vinculan esa caída a la menor entropía de salida bajo una optimización por refuerzo fuerte. R4T-Difusión sobre Qwen mantuvo un Vendi Score más alto, de 34,7, con 16,5 de Recall@5K.
¿Cuánto más rápido es?
Con un lote de 8, el abanico autorregresivo tardó cerca de 1,46 segundos y el modelo de difusión 0,07 segundos. Con un lote de 1.024, el autorregresivo llegó a casi 50 segundos, contra 4,21 segundos de la difusión. Los autores reportan una aceleración consistente de 12 a 20 veces. El paper y los detalles técnicos están publicados.