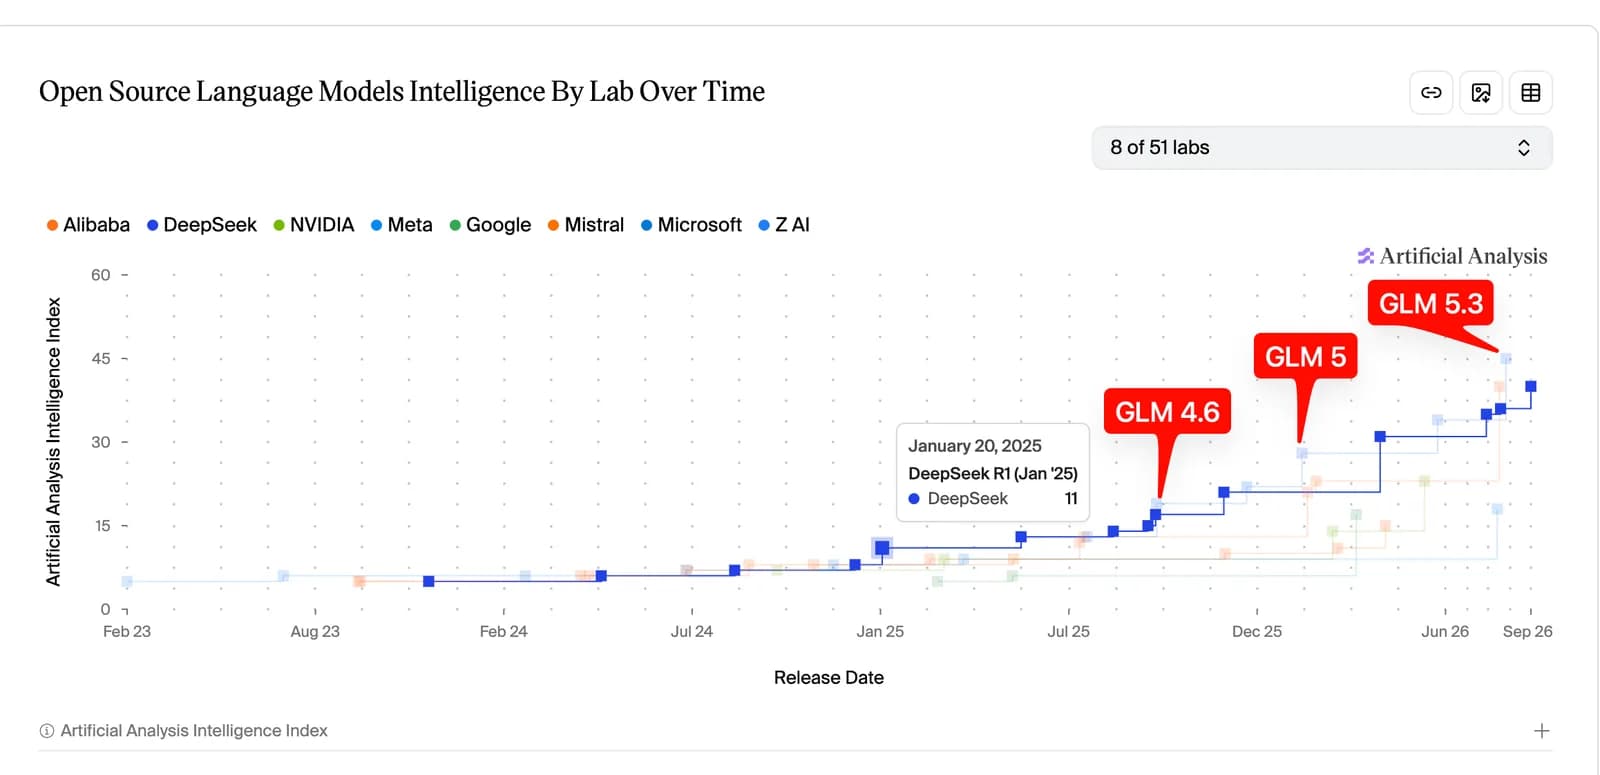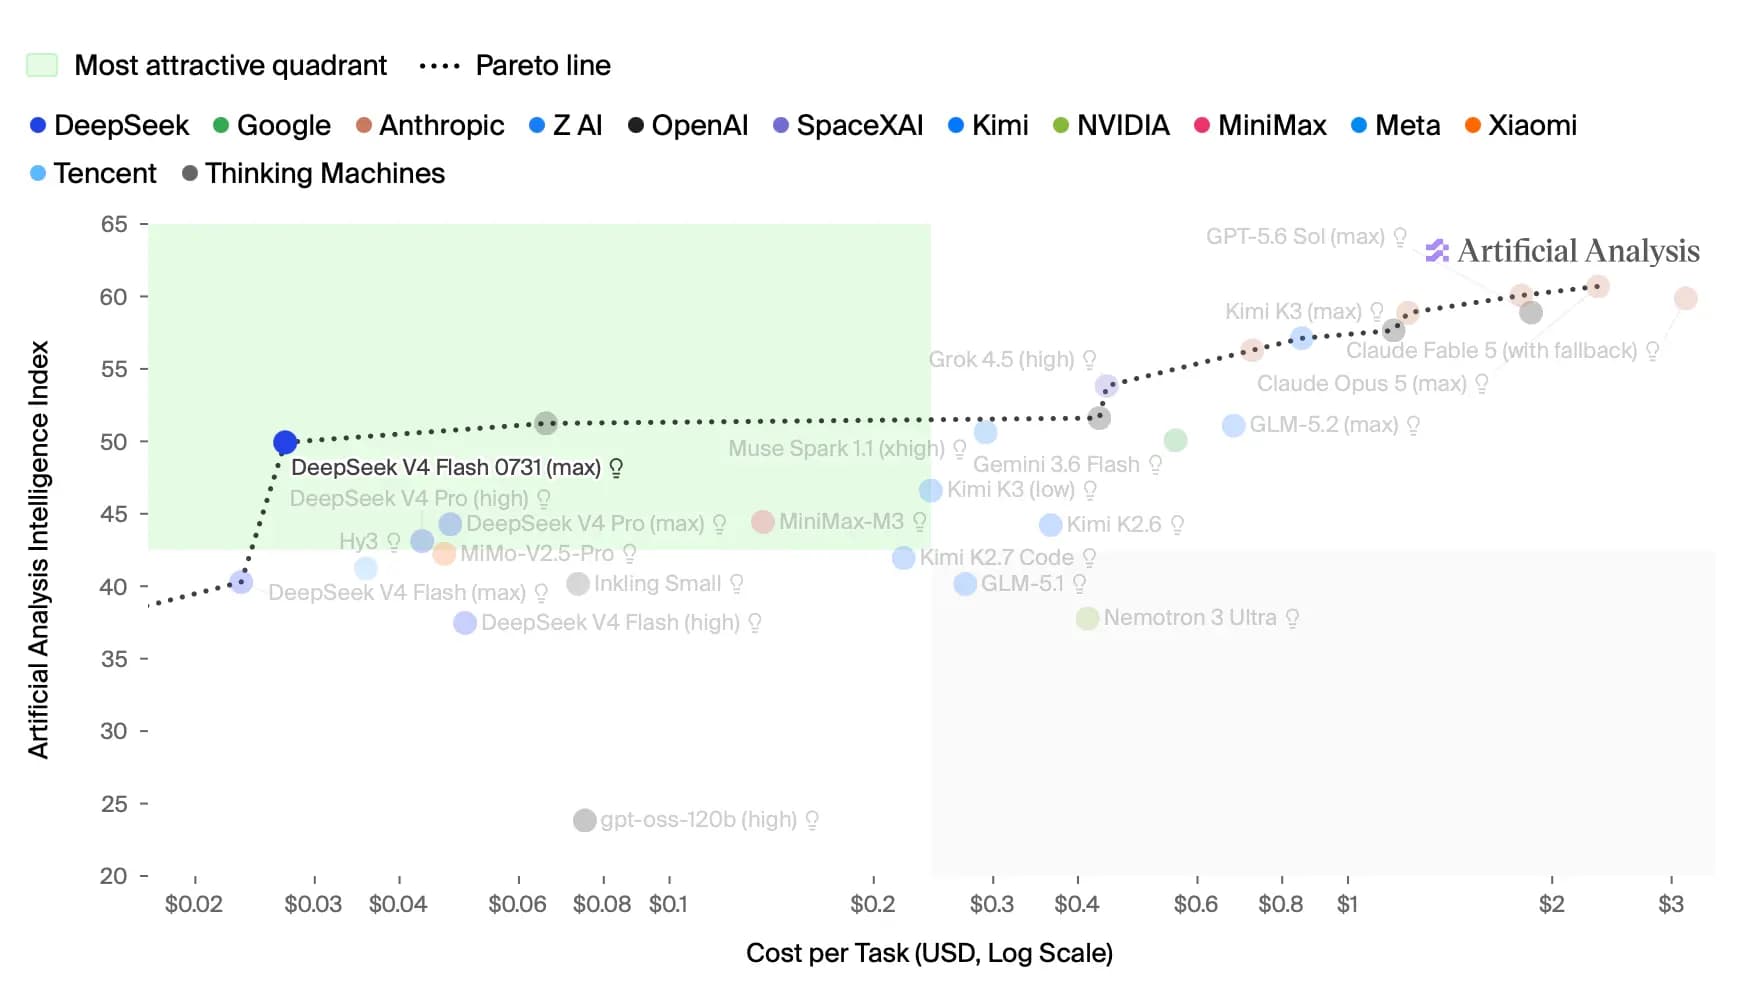
DeepSeek publicó el jueves la actualización de su modelo optimizado para costo y latencia, V4.1 Flash, con 763.000 millones de parámetros. Es más de 2,5 veces el tamaño del modelo que reemplaza y supera incluso a los V3 y R1 que pusieron a la empresa china en el mapa a comienzos de 2025. Los pesos están publicados en Hugging Face.
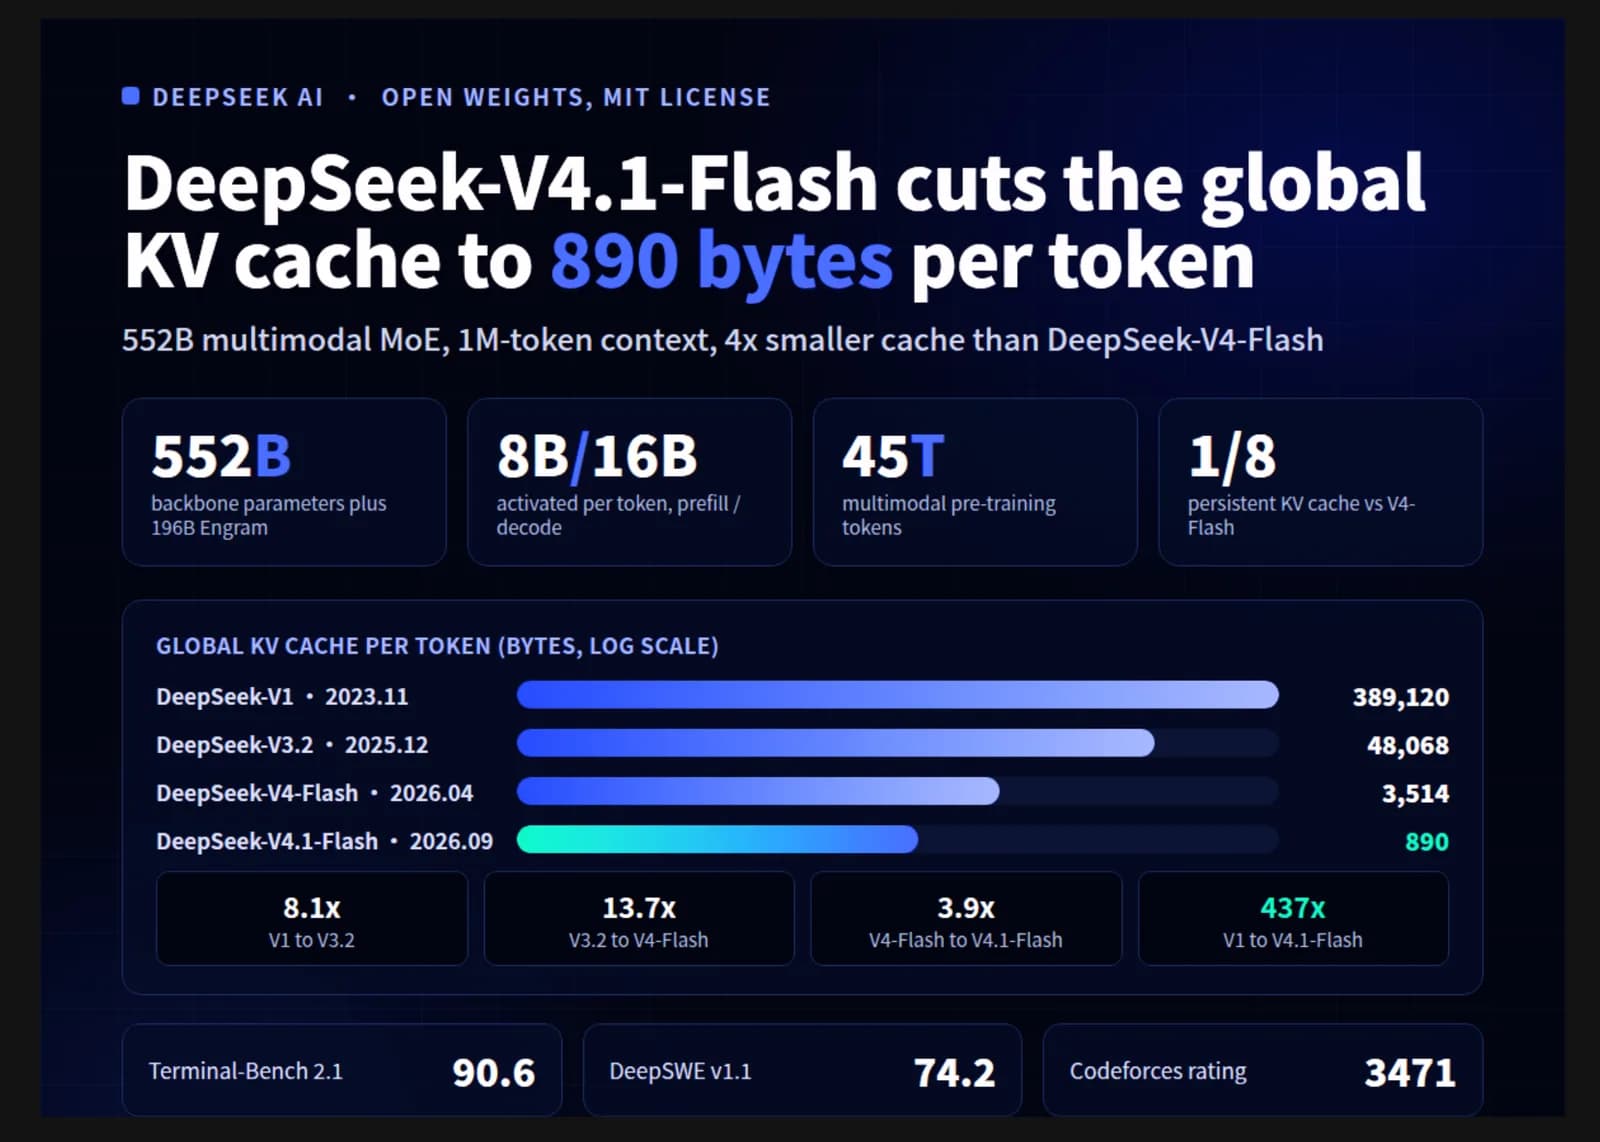
El consumo de memoria no creció en la misma proporción. Los desarrolladores rehicieron la forma en que el modelo maneja los cachés de clave-valor (KV), que guardan el estado entre sesiones y se comen la memoria en aplicaciones de mucho tráfico como los chatbots. Con los cambios en los mecanismos de atención y con un codificador-decodificador causal (CED) nuevo, el caché KV bajó a entre 13% y 25% de lo que pedía DeepSeek V4 Flash. La misma memoria atiende de cuatro a ocho veces más usuarios.
¿Qué son los parámetros N-gram?
De los 763.000 millones de parámetros, 196.000 millones son parámetros N-gram y forman lo que los desarrolladores llaman un módulo de memoria condicional. Un N-gram es un grupo de tokens seguidos. Dos tokens son un bigrama, tres son un trigrama, y así.
Esos pesos funcionan como una tabla de consulta gigante. En vez de calcular qué combinación de tokens tiene la probabilidad más alta de responder, el modelo levanta información relevante con una búsqueda barata sobre hashes. La tabla devuelve vectores, que entran a la inferencia. DeepSeek detalló la técnica en un paper de enero y la desarrolla en el reporte técnico del modelo.
La idea viene de la tecnología Per-Layer Embedding (PLE) que el equipo de Gemma desarrolló en Google para que modelos chicos corrieran en teléfonos. DeepSeek cambió los embeddings de PLE por N-grams.
¿Cuánta memoria de GPU pide el modelo?
Acá está el efecto práctico. Un modelo de 763.000 millones de parámetros necesitaría un mínimo de 763 GB de memoria de GPU para sostener los pesos en FP8. Como las tablas N-gram no se leen enteras en cada token, sino apenas unas decenas de consultas, se pueden descargar a la RAM del sistema o a un arreglo de almacenamiento rápido. Con esa descarga el mínimo baja a alrededor de 567 GB.
Son mínimos. En producción las cifras suben, porque hay que sumar los cachés de clave-valor, que escalan con el largo del contexto y con la cantidad de usuarios simultáneos. Durante la inferencia los pesos N-gram acompañan a los 8.000 millones de parámetros activos con que el modelo procesa cada prompt, y no aumentan esa cuenta de activos.
¿Quién más está usando la técnica?
Alibaba presentó a fines de agosto un modelo experimental, Qwen 3.8-Flash-Next, con 180.000 millones de parámetros y una bolsa de 51.000 millones en pesos N-gram. Su implementación usa técnicas del mismo paper que DeepSeek publicó en enero. Según Alibaba, esa arquitectura será la base de la próxima generación Qwen 4.
| Modelo | Parámetros totales | Parámetros N-gram | Proporción |
|---|---|---|---|
| DeepSeek V4.1 Flash | 763.000 millones | 196.000 millones | 25,7% |
| Qwen 3.8-Flash-Next | 180.000 millones | 51.000 millones | 28,3% |
Google también sigue en esa línea con PLE, descargando a almacenamiento local los pesos menos sensibles al ancho de banda, aunque hasta ahora solo en modelos chicos, al menos entre los que se conocen.