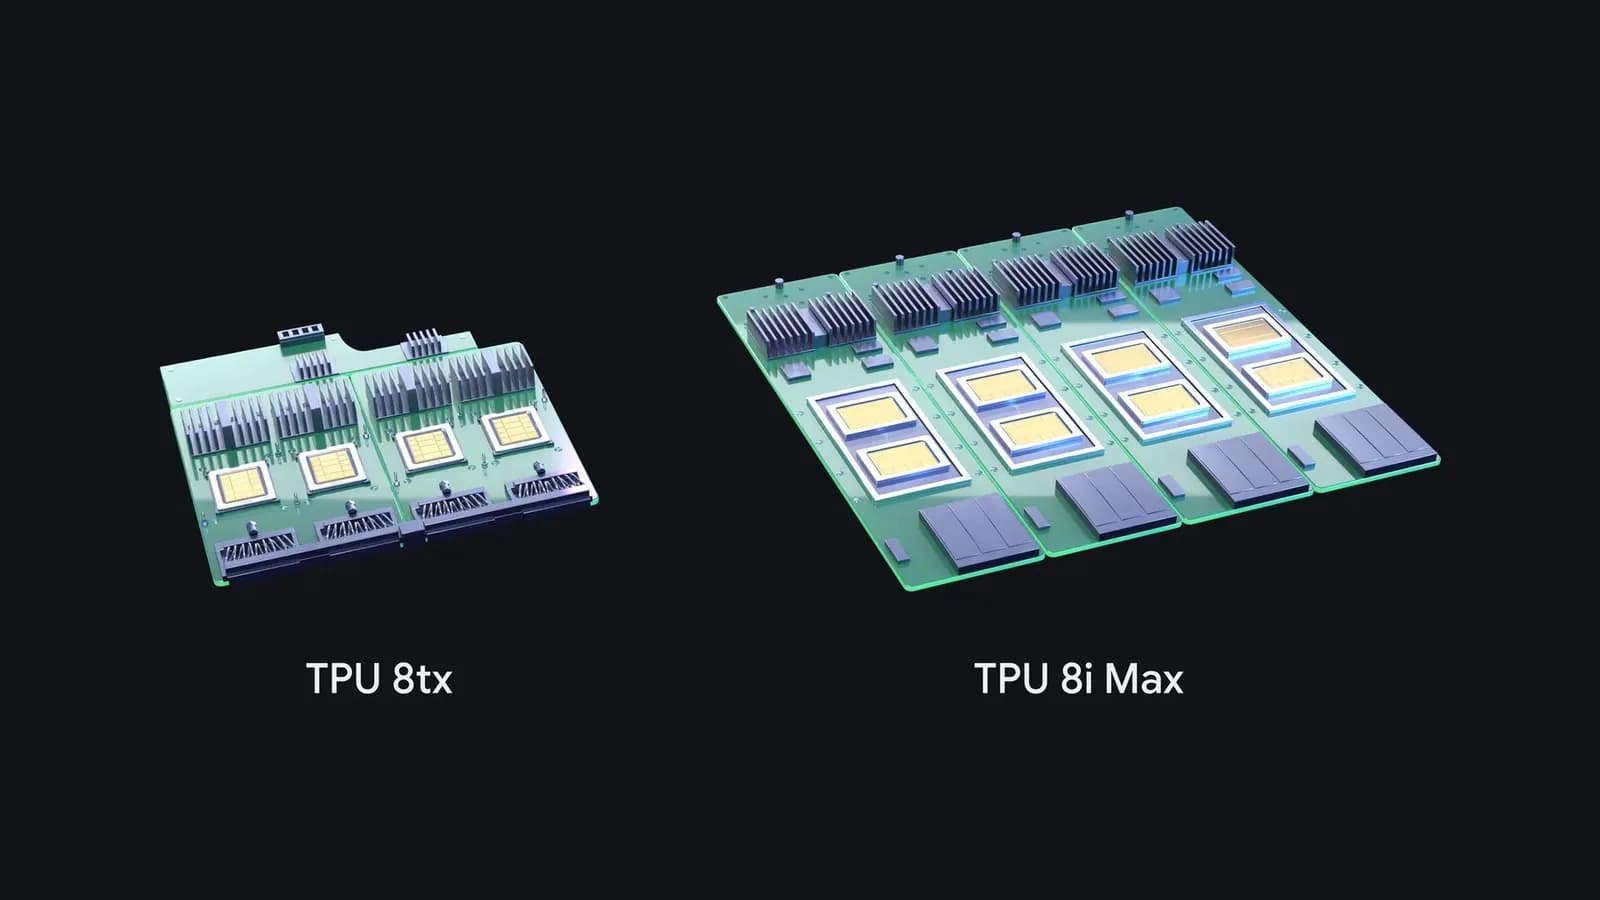
La familia de TPU de octava generación de Google creció otra vez. En abril, la empresa había anunciado el TPU 8t para entrenar modelos de IA y el TPU 8i para inferencia de uso general. Ahora presentó el TPU 8tx, construido sobre el mismo silicio del 8t, para inferencia confidencial y aislada por hardware dirigida a empresas reguladas y gobiernos, y el TPU 8i Max, que combina dos chips 8i en un solo encapsulado para trabajo de agentes con contexto largo, informó Tom's Hardware el 12 de noviembre.
El TPU 8tx reemplaza los hosts Axion, basados en Arm, del 8t y el 8i por una CPU AMD EPYC de quinta generación y adopta la red Boardfly. El 8i Max duplica el cómputo, la SRAM y el ancho de banda de HBM del 8i original.
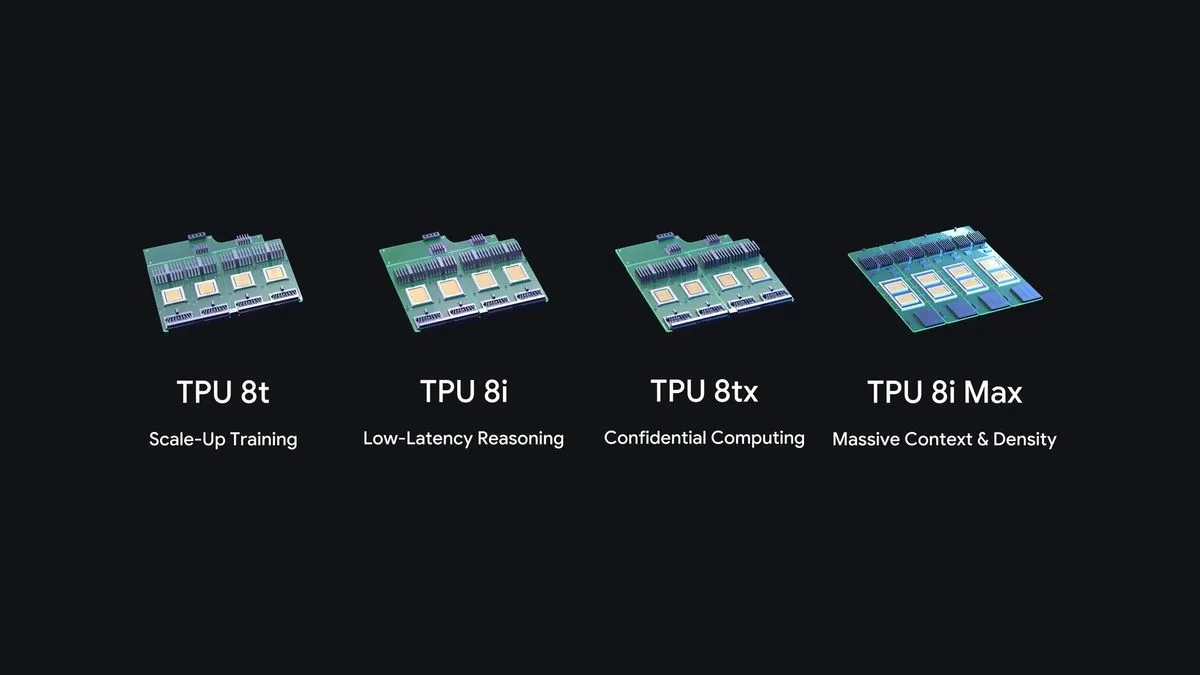
La división original tenía lógica. El 8t apunta al entrenamiento a gran escala y el 8i, a la inferencia y el razonamiento de baja latencia. Los TPU se volvieron un negocio que crece rápido. Google dice tener cerca de 100 clientes, entre ellos Meta, que se pasó hace poco a sus TPU. Según la empresa, el enfoque modular le permite entregar sistemas especializados "en cuestión de meses y no de años".
Los cuatro sistemas de la octava generación
| TPU 8t | TPU 8i | TPU 8tx | TPU 8i Max | |
|---|---|---|---|---|
| Uso | Preentrenamiento a gran escala | Muestreo, servicio y razonamiento | Inferencia segura y confidencial; entrenamiento a pequeña escala | Trabajo de agentes con contexto largo |
| Silicio | TPU 8t | TPU 8i | El mismo del TPU 8t | Dos chips TPU 8i en un encapsulado |
| CPU host | Arm Axion | Arm Axion | AMD EPYC de 5.ª generación | No informada |
| Red | Toro 3D | Boardfly | Boardfly | No informada |
| PFLOPS FP4 máximos | 12,6 | 10,1 | No informados | Cerca de 20,2 (calculado por Tom's Hardware) |
| Ancho de banda HBM (GB/s) | 6.528 | 8.601 | No informado | Cerca de 17.202 (calculado por Tom's Hardware) |
| Capacidad HBM (GB) | 216 | 288 | No informada | No informada |
| SRAM interna (MB) | 128 | 384 | No informada | 768 (calculado por Tom's Hardware) |
| Disponibilidad | Próximamente | Próximamente | Próximamente | Próximamente |
¿Qué cambia con el TPU 8i Max?
A primera vista el 8i Max no trae nada nuevo, porque son dos TPU 8i juntos en un encapsulado. El resultado es el doble de cómputo teórico, y lo más importante es que mete el doble de silicio en el "espacio de rack existente". Google dice que entrega más cómputo por metro cuadrado y por watt.
Al duplicar la SRAM y el ancho de banda de HBM, el 8i Max quedaría en unos 20,2 PFLOPS FP4, 768 MB de SRAM y cerca de 17,2 TB/s de HBM, según el cálculo de Tom's Hardware. La GPU Rubin R200 de Nvidia está especificada en 50 PFLOPS FP4 para inferencia y 22 TB/s de HBM4 por socket, y la MI455X de AMD en 40 PFLOPS FP4. La distancia en cómputo se está acortando.
Duplicar el ancho de banda de memoria es también una forma de esquivar, por ahora, el paso a HBM4. Google habla de un "muro de memoria", el cuello de botella del ancho de banda, que se vuelve un problema real "cuando decenas de agentes de IA trabajan juntos sobre una base de código entera". Las ventanas de contexto más grandes, con modelos que apuntan a 1 millón de tokens, implican cachés KV más grandes, guardadas en parte en SRAM. Cada token nuevo tiene que leer esa caché desde memoria, y ahí ayuda el ancho de banda extra de HBM. Es un camino distinto al LPX de Nvidia, que usa un segundo tipo de chip para la decodificación y una capa de almacenamiento para el contexto, en vez de más ancho de banda en un encapsulado.
El software para agentes
Google ofrece además software para que los agentes saquen provecho del hardware. TPU Sync es una "capa de estado del modelo para clústeres de TPU", de código abierto, que saca las cachés KV de la HBM del chip y las "escalona automáticamente fuera del chip en milisegundos" hacia la DRAM del host y, de forma experimental, hacia almacenamiento compartido. Google dice que esto reduce la latencia de transferencia de la caché KV en "más de 90%", con mejoras en el tiempo hasta el primer token que varían según la carga. La empresa anunció también Agent Compute Engine, un servicio de Google Cloud que pausa las sesiones de agentes inactivas y guarda su memoria de trabajo aparte hasta que se necesite.
Google atribuye a su stack vLLM-TorchTPU "marcas de precio y rendimiento de primer nivel" en InferenceX y AgentX, que prueban trabajo realista de programación con agentes y de contexto largo. Las únicas cifras de terceros publicadas hasta ahora son de la generación anterior, el TPU Ironwood. En las pruebas InferenceX de SemiAnalysis de septiembre, con Qwen3.5 397B en FP8, Ironwood entregó 50,4% más tokens por dólar que la B200 de Nvidia y 96,0% más que la B300, a 20 tokens por segundo por usuario. Ironwood no tiene FP4 nativo, aunque los resultados de noviembre muestran su FP8 por sobre el GB300 NVL72 de Nvidia en FP4 con el mismo modelo, con 1,67 veces el rendimiento por dólar. Todavía no hay resultados de la octava generación para compararla.
¿Para quién es el TPU 8tx?
A diferencia del 8i Max, el TPU 8tx, "construido sobre el mismo silicio del TPU 8t", está "optimizado para inferencia segura y confidencial" y para entrenamiento a pequeña escala. La seguridad está en el hardware, con aislamiento que impide espiar datos sensibles, incluidos los pesos del modelo. Normalmente los datos tienen que quedar descifrados en memoria mientras se procesan, y ese es el paso que cubre este aislamiento.
El chip apunta a empresas reguladas y gobiernos, sobre todo los que usan modelos de frontera o propietarios. Esos operadores pueden querer "ajustar modelos con sus datos privados, destilar modelos grandes en otros más chicos y entrenar a sus agentes" sin mover datos sensibles entre clústeres. En abril, el Pentágono y Google habrían conversado sobre el uso de TPU en entornos clasificados, aunque el 8tx no se nombró en particular.
Private AI Compute, la "plataforma de TPU reforzada" de Google, con protecciones "comparables a un TEE típico" según su informe técnico de septiembre, ya hace servicio confidencial sobre TPU. El 8tx parece ser esa capacidad convertida en producto para clientes. Entre las alternativas están el NVL72 de Nvidia, con un dominio de seguridad que abarca 72 GPU Rubin, 36 CPU Vera y las interconexiones, y TDX de Intel, que agrega E/S confiable para cubrir los datos que viajan a los aceleradores.
AMD EPYC en vez de Arm
Los hosts del 8tx usan placas con AMD EPYC de quinta generación, en vez de los Axion del 8t, que habían reemplazado a x86 en abril. En el 8i hay un Axion por cada dos TPU, contra un Xeon por cada cuatro en Ironwood. Google no explica el cambio, pero su lista de configuraciones de Confidential VM incluye series de AMD e Intel y ninguna basada en Arm. Private AI Compute usa "un entorno de ejecución confiable por hardware basado en AMD" para sus cargas de CPU, lo que sugiere que Google trajo algo que ya corre en su stack confidencial.
El 8tx adopta además la red Boardfly del 8i en vez del toro del 8t. Google dice que entrega "hasta 2 veces menos latencia que el TPU 8t" casi sin perder rendimiento, aunque no queda claro con qué medida. El toro sirve para entrenar, porque los chips intercambian datos sobre todo con sus vecinos y de forma predecible. La inferencia de grandes modelos de mezcla de expertos y de razonamiento, en cambio, manda mensajes más chicos entre chips lejanos, y cada salto suma retardo. Con Boardfly son como máximo siete saltos, contra 16 en un sistema de 1.024 chips.
Lo que Google no informó
Falta una tabla de especificaciones completa, la capacidad de HBM, el tamaño de los pods, la fecha de disponibilidad, el precio y los clientes de ambos sistemas. Para el 8tx tampoco hay detalles de atestación, o sea de cómo el cliente verifica la confidencialidad. El 8tx y el 8i Max aparecen, junto al 8i y el 8t, como "próximamente" en la página de Cloud TPU de Google.
Google presentó dos sistemas nuevos casi siete meses después del par de abril, más rápido que en generaciones anteriores. Le faltan benchmarks y una fecha en que el hardware llegue a manos de los clientes.