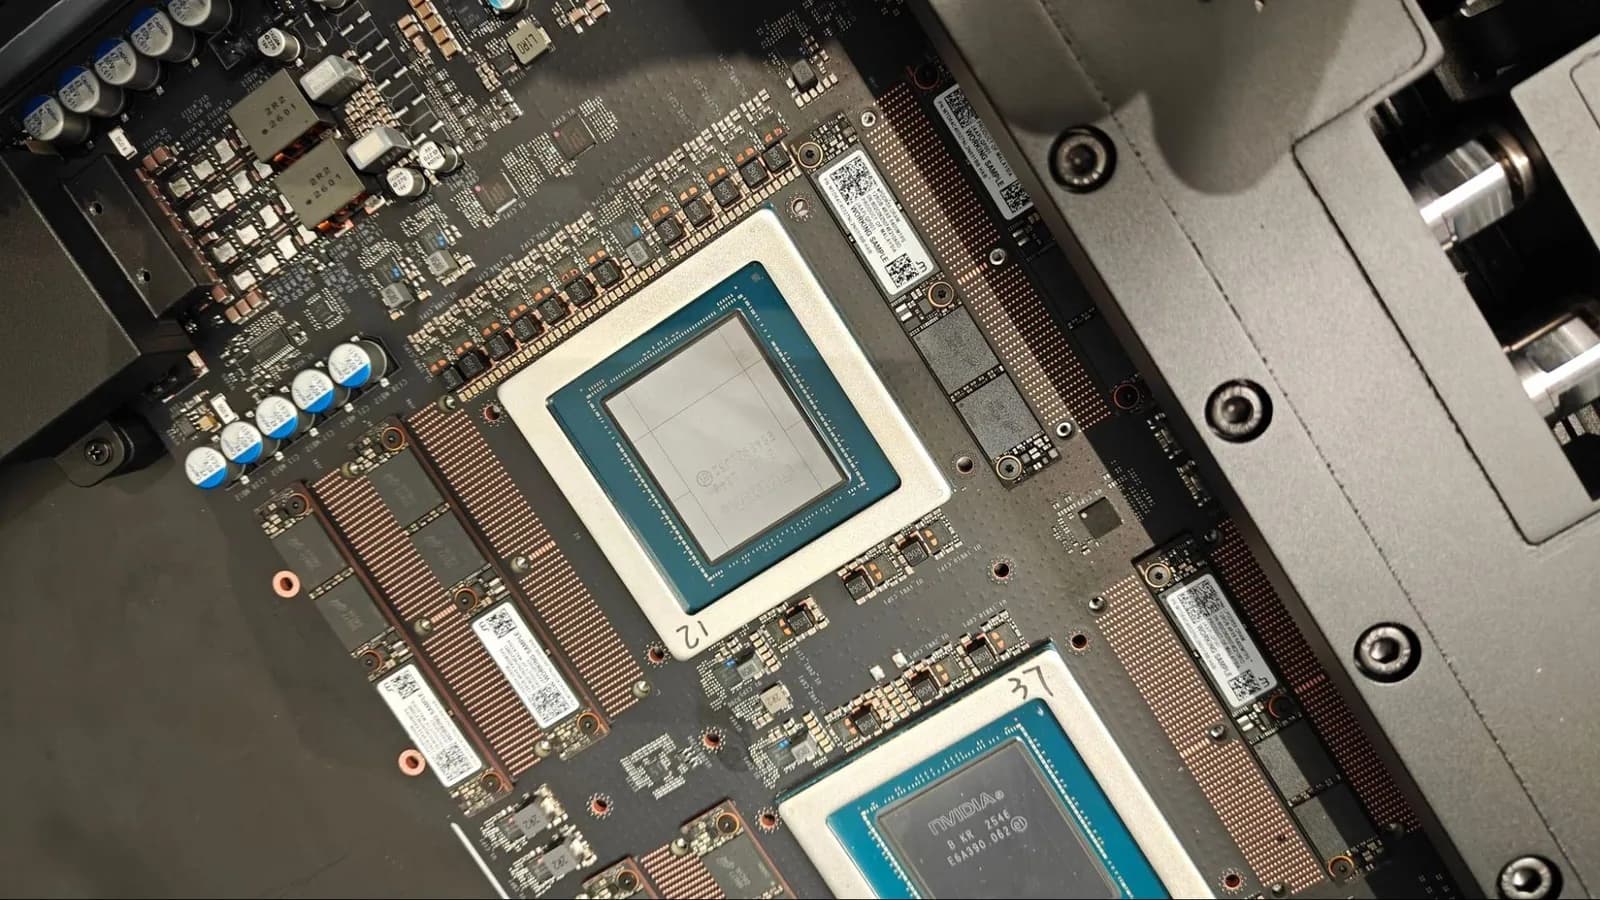
Nvidia admitió en el congreso Supercomputing 2026 (SC26), que se celebra esta semana en Chicago, que el software actual no siempre exprime su CPU Vera sin adaptarse a su arquitectura. La empresa mostró que una optimización específica sube el rendimiento de Vera en cerca de 39% en ciertas cargas de cálculo intensivo, informó Tom's Hardware.
Vera funciona como procesador de centro de datos por sí solo y también como anfitrión de los servidores Vera Rubin NVL72. Trae bastantes más recursos de ejecución por núcleo que su antecesor, Grace. Aun así, Nvidia no la posiciona para cargas de uso general.
¿Qué cambia entre Grace y Vera?
Grace usa núcleos Neoverse V2 que Arm vende a cualquier fabricante. Vera usa los núcleos Olympus, un diseño propio de Nvidia pensado para maximizar el rendimiento de cada núcleo sin perder throughput total.
Para eso Olympus lleva un frontal ancho con un decodificador de 10 instrucciones por ciclo, un predictor de saltos neuronal y un motor de ejecución fuera de orden profundo. Suma seis unidades de ejecución vectorial, cuatro tuberías de carga y dos de almacenamiento, todo respaldado por cachés privadas grandes y mecanismos de precarga avanzados.
Nvidia eligió poner 88 núcleos de alto rendimiento con su tecnología propia de multihilo espacial (176 hilos en total) en vez de meter la mayor cantidad de núcleos posible por zócalo. El rendimiento máximo por hilo era uno de los objetivos centrales del diseño.
"El diseño de una CPU es en realidad un juego de compromisos", dijo Hannah Coutand, quien dirige el marketing de la CPU Vera en Nvidia, en una entrevista con Tom's Hardware Premium. "Podrías maximizar para tener muchos núcleos, pero literalmente cuando maximizas el chip para muchos núcleos, no tienes espacio para maximizar el IPC, las instrucciones por ciclo de reloj".
Una CPU que no es para servidores web
Nvidia vende Vera sobre todo como CPU para IA agéntica y otras cargas de IA. Sin embargo, la microarquitectura Olympus nació pensada para aplicaciones de procesamiento de datos. Según Coutand, los atributos que la definen (alto rendimiento por núcleo, gran ancho de banda de memoria y baja latencia de acceso) resultaron ser justo lo que piden los agentes de IA.
"Somos muy claros en nuestra estrategia con Vera y en nuestro posicionamiento con Vera, en que no es una CPU de uso general", dijo Coutand. "Si quieres un servidor web para tu centro de datos en la nube, probablemente hay otras opciones más adecuadas para eso que Vera".
Coutand explicó que Vera está hecha para cargas que necesitan alta velocidad por núcleo, gran ancho de banda de memoria y baja latencia. "Tiene una gran fungibilidad para muchas cargas de trabajo, siempre que esas cargas valoren las cosas en las que Vera es buena", agregó.
La prueba de multiplicación de matrices
Para medir la capacidad de cálculo de Olympus frente a Neoverse V2, los investigadores de Nvidia usaron una carga de multiplicación general de matrices en doble precisión (DGEMM). Partieron de un kernel en ensamblador de OpenBLAS, una biblioteca de álgebra lineal de código abierto. OpenBLAS trae un kernel ajustado a los núcleos Neoverse V2 de Grace, pero ninguno diseñado para Olympus.
El banco de pruebas fue miniKernelGEMM, con un problema de 128 × 128 que cabe en la caché L1 de ambos procesadores.
| CPU y kernel | Instrucciones por ciclo | Operaciones FP64 por ciclo | Uso del pico FP64 |
|---|---|---|---|
| Grace con kernel Neoverse V2 | 4,51 | 13,03 | 81,4% |
| Vera con kernel Neoverse V2 | 5,43 | 15,69 | 66,5% |
| Vera con kernel para Olympus | 7,53 | 21,75 | 90,6% |
Con el mismo código, Vera rindió cerca de 20% más que Grace. Con el kernel optimizado para Olympus, la ventaja por núcleo y por ciclo de reloj subió a casi 67% en esta carga puntual.
La diferencia de fondo está en el hardware vectorial. Neoverse V2 tiene cuatro tuberías SIMD de 128 bits que suman 16 operaciones FP64 por ciclo. Olympus tiene seis, con hasta 24 operaciones FP64 por ciclo, un 50% más.
El kernel escrito para Neoverse V2 usa el 81,4% del pico FP64 de Grace, pero solo cerca del 66,5% de la capacidad de Vera. Los investigadores cambiaron la organización de los bloques de la matriz, la asignación de registros y el orden de las instrucciones para ajustarlos a Olympus, y así llegaron a usar el 90,6% de su pico FP64, según el tutorial que Nvidia publicó en SC26.
Lo que exige al software
El software escrito y optimizado para los procesadores Arm de centro de datos actuales igual corre mejor en Olympus sin cambios. Pero los resultados de Nvidia en SC26 muestran que al menos algunas aplicaciones van a necesitar ajustes para aprovechar todos sus recursos de ejecución. La prueba se limita a la multiplicación de matrices, y Nvidia no mostró cuánto se gana con optimizaciones para Olympus en otras cargas.
Nvidia ya no hace CPU solo como acompañantes de sus GPU de centro de datos y ahora apunta al mercado de procesadores de servidor por sí solos. Para eso tendrá que lograr que el software crítico aproveche las particularidades de su arquitectura, como Intel y AMD hacen hace décadas. La empresa tiene experiencia en desarrollar ecosistemas de socios con plataformas como CUDA, y Tom's Hardware apunta que esa experiencia le sirve para empujar optimizaciones para Vera.