¿Qué pasa cuando se le pide a un robot que juegue con algo transparente, que se mueve todo el tiempo y que una cámara de profundidad apenas logra ver?
Qi Liu y Ethan Yeang, miembros de Chaihuo Makerspace, exploraron esa pregunta, contó el blog de Seeed Studio el 30 de septiembre. En vez de montar otra tarea fija de tomar y dejar objetos, construyeron un robot móvil que percibe una burbuja de gel transparente en movimiento, se reposiciona y usa un brazo robótico con una paleta roja para golpearla.
El montaje junta una NVIDIA Jetson AGX Thor, una cámara Intel RealSense D455, los modelos LingBot-Depth y LingBot VLA V2, la base móvil LeKiwi y el brazo SO-ARM. Visto desde afuera, el resultado se entiende al tiro. La burbuja se mueve, el robot la sigue y el brazo responde.
Detrás de esa interacción hay un flujo completo de IA física, con percepción RGB-D, procesamiento de profundidad, decisiones de acción con un modelo VLA (visión, lenguaje y acción), cómputo de IA en el borde, manipulación móvil y control en lazo cerrado.
¿Por qué una burbuja transparente le cuesta tanto a un robot?
Para una persona, seguir una burbuja en el aire no requiere esfuerzo. Los ojos rastrean su movimiento, el cerebro estima hacia dónde va y el cuerpo se ajusta sin pensar en cada paso.
Un robot tiene que separar esa misma interacción en problemas técnicos distintos.
El primero es la percepción. Los objetos transparentes y reflectantes complican a muchos sistemas de medición de profundidad, porque la luz que usan para calcular la distancia puede atravesar la superficie, refractarse o volver de forma irregular. En vez de una medición limpia, el sistema puede ver zonas vacías, valores con ruido o información espacial inestable.
Eso ya es un problema con un objeto transparente quieto. Una burbuja de gel flotando lo empeora, porque su posición cambia todo el tiempo.
Para cuando el robot calcula dónde está la burbuja, una corriente de aire puede haberla movido. El robot no puede detectar el blanco una vez, calcular una posición, ejecutar un movimiento y detenerse.
Tiene que seguir mirando. La tarea real se parece más a un ciclo continuo de observar, actualizar, actuar y volver a observar.
Cómo funciona, de la imagen RGB-D al movimiento
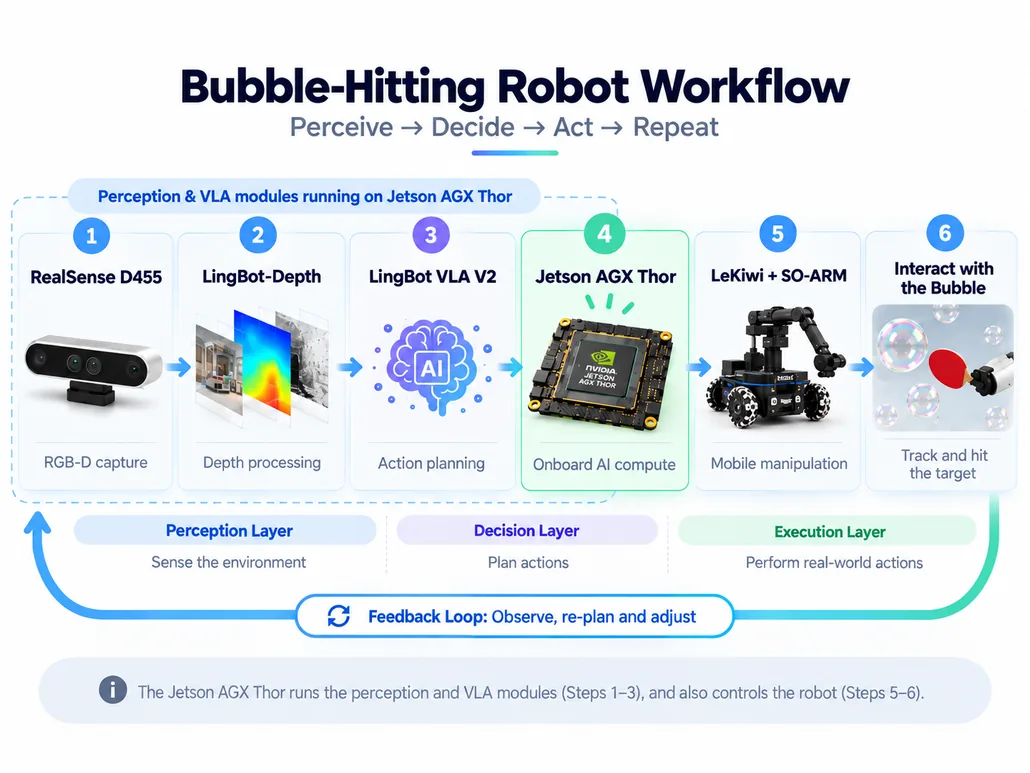
La forma más simple de entender el sistema es como un ciclo continuo de percepción, decisión y acción.
El proceso parte en la Intel RealSense D455, que captura información RGB-D de la escena. El flujo RGB le dice al sistema lo que ve la cámara y el flujo de profundidad entrega la información espacial del entorno.
Con un blanco transparente como la burbuja, los datos de profundidad en bruto no bastan por sí solos. Por eso el sistema usa LingBot-Depth para procesar la profundidad y entregar una representación espacial más útil al resto de la cadena.
La información procesada de la escena llega después a LingBot VLA V2, que conecta la comprensión visual con las decisiones de acción. En vez de repetir una trayectoria del brazo definida de antemano, el robot usa el estado actual de la escena para decidir si tiene que moverse, ajustar su posición o ejecutar un movimiento del brazo.
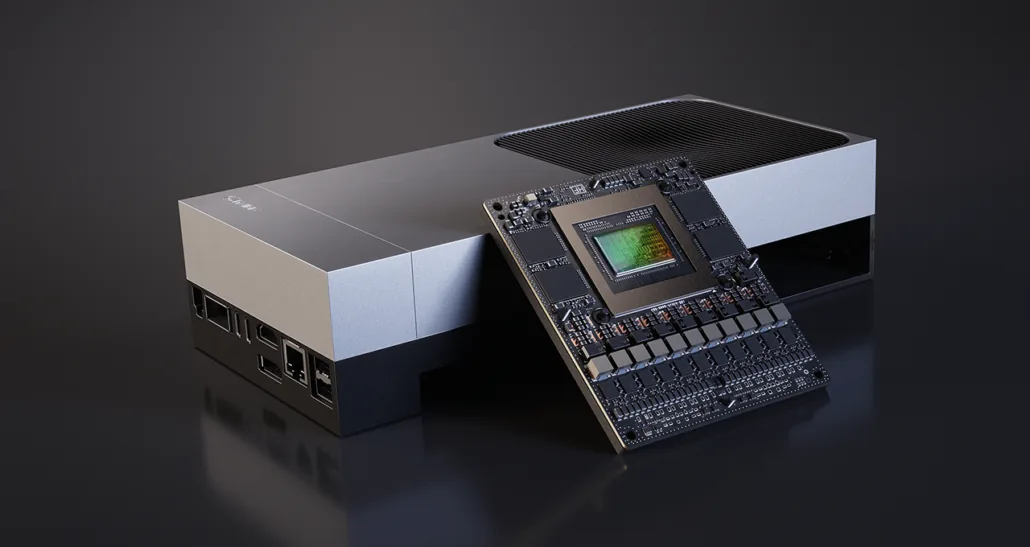
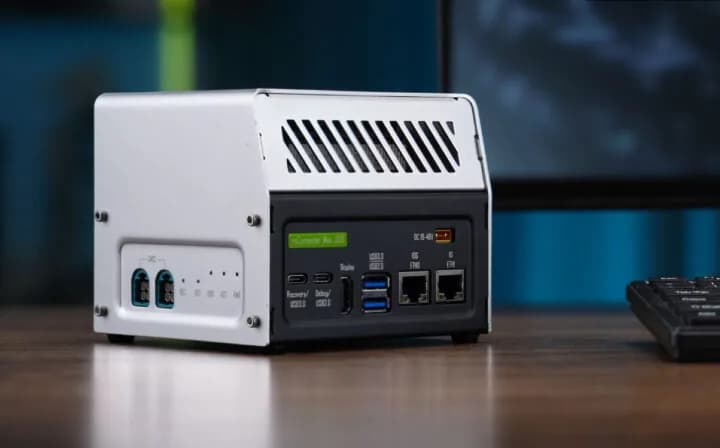
Las cargas de percepción y de los modelos corren en el kit de desarrollo NVIDIA Jetson AGX Thor, que es el núcleo de cómputo de IA a bordo del robot.
Una vez decidida la acción, entra la parte física. LeKiwi le da movilidad al robot para que se reposicione cuando la burbuja queda fuera del alcance del brazo, y el SO-ARM101 hace la manipulación fina para acercar la paleta al blanco.
En forma simplificada, la pila queda así.
- RealSense D455 captura datos RGB-D del entorno.
- LingBot-Depth procesa la profundidad para la percepción espacial.
- LingBot VLA V2 usa el estado actual de la escena para generar decisiones de acción.
- Jetson AGX Thor corre la percepción, la inferencia de los modelos y las cargas de IA del robot.
- LeKiwi mueve al robot a una mejor posición de trabajo.
- SO-ARM101 ejecuta la interacción física final.
Lo que importa del proyecto es que esas seis piezas funcionan como un solo sistema que se actualiza todo el tiempo.
El papel de la Jetson AGX Thor
En una tarea robótica dinámica, la latencia pasa rápido a ser parte del problema.
La cámara produce información nueva sin parar. El procesamiento de profundidad tiene que actualizar lo que el robot entiende de la escena. El modelo VLA tiene que decidir qué viene después, y esa acción tiene que llegar a la base móvil o al brazo.
Mientras tanto, la burbuja sigue moviéndose.
Si pasa demasiado tiempo entre la percepción y la ejecución, el robot puede actuar sobre una posición del blanco que ya quedó vieja.
Por eso la Jetson AGX Thor ocupa un lugar central en el montaje. En vez de tratar la inferencia de IA como una tarea aparte en una estación de trabajo, el sistema lleva la percepción, la inferencia de los modelos y el cómputo del robot al propio robot. Eso acorta la distancia entre ver un cambio en el mundo físico y responder a él.
Para quien explora la IA física, el cambio es de enfoque. La Jetson no corre solo un modelo de imágenes. Su cómputo está dentro de un lazo de realimentación donde la salida de la IA determina la siguiente acción física.
Lo difícil no es mover la paleta
Hacer que un brazo robótico mueva una paleta una vez es relativamente fácil. Se define una trayectoria de las articulaciones, se ejecuta y se repite el mismo movimiento.
Ese robot no tendría idea de si la burbuja está realmente ahí.
El problema interesante empieza cuando se mueven tanto el blanco como el robot.
Supongamos que la D455 ve la burbuja un poco fuera del rango cómodo de trabajo del brazo. El sistema decide que el robot primero tiene que reposicionarse con LeKiwi.
Apenas se mueve la base, la situación cambia. El punto de vista de la cámara es otro, la relación entre el brazo y la burbuja es otra y la posición estimada del blanco puede haber dejado de ser exacta.
Así que el robot tiene que volver a mirar.
Entran datos RGB-D nuevos a la cadena de percepción. LingBot-Depth actualiza la información espacial y LingBot VLA V2 evalúa el estado nuevo. Si el robot quedó mejor ubicado, el SO-ARM ejecuta la siguiente acción. Si la burbuja se vuelve a mover, el ciclo sigue.
La secuencia detectar, moverse, golpear describe mal la demostración. La que corresponde es sensar, entender, decidir, moverse, actuar y volver a sensar. Ese lazo de realimentación es lo que convierte un conjunto de componentes en un robot que responde a un entorno que cambia.
Manipulación móvil, la base se mueve antes que el brazo
Un brazo robótico fijo tiene un límite simple. Su espacio de trabajo termina donde termina su alcance, y si el blanco sale de ahí el brazo poco puede hacer.
LeKiwi cambia el problema porque le da movilidad al robot. En vez de esperar a que cada blanco entre al espacio de trabajo del brazo, el robot primero mueve todo su cuerpo a una mejor posición y después hace la manipulación fina.
En este sistema, LeKiwi y el SO-ARM resuelven movimientos de dos escalas. LeKiwi responde la pregunta grande, hacia dónde tiene que ir el robot. El SO-ARM responde la pregunta local, cómo tiene que interactuar el brazo con el blanco una vez que el robot llegó.
Esa combinación es la base de la manipulación móvil, una línea de trabajo para robots que tienen que operar más allá de una estación fija.
La movilidad también complica el control. Cuando la base se mueve, hay que recalcular las coordenadas de la cámara, las del brazo y la posición del blanco. El sistema depende de percibir una y otra vez, y un plan de movimiento calculado una sola vez queda viejo apenas el robot avanza. El proyecto usa el LeKiwi Full Kit para la base.
El SO-ARM convierte la decisión en movimiento
La percepción y la planificación de acciones solo sirven en robótica cuando la decisión se puede ejecutar de forma confiable en el mundo físico. Ese es el trabajo del SO-ARM101.
En la demostración, el brazo es la capa final de ejecución. El sistema de visión estima lo que pasa, LingBot VLA V2 decide qué tiene que hacer el robot y la Jetson AGX Thor corre el cómputo necesario, pero la interacción física solo ocurre cuando el brazo convierte esa decisión en movimiento.
La paleta roja montada en el brazo hace visible esa relación. La parte de IA de la pila trabaja con representaciones, observaciones y salidas de acción. El brazo tiene que traducir esas salidas en movimiento de articulaciones, con motores, tiempos y restricciones mecánicas reales.
La distancia entre un modelo que decide una acción y un robot que la completa es una de las partes más difíciles de la IA física. Para quien trabaja con aprendizaje de robots, teleoperación, aprendizaje por imitación o modelos VLA, el SO-ARM101 es una plataforma de código abierto para probar esas ideas en hardware real.
¿Qué muestra una demostración tan chica?
La IA física se discute casi siempre a través de robots humanoides, sistemas de automatización industrial, vehículos autónomos o grandes pruebas de investigación. Un proyecto chico permite ver las ideas de fondo con más claridad.
Este robot igual tiene que hacer todo lo básico.
- Observar un entorno físico que cambia.
- Sacar información espacial útil de datos de sensores imperfectos.
- Decidir qué hacer según el estado actual.
- Mover su cuerpo o su brazo.
- Observar el resultado.
- Actualizar la siguiente acción.
Eso ya es un ciclo completo de percepción y acción. La burbuja sirve justamente porque no se comporta como un objeto de prueba ideal. Es transparente, sus datos de profundidad pueden fallar y su trayectoria cambia con el aire que la rodea. El mundo no se detiene mientras el robot calcula.
Una pila que se puede desarmar por capas
El flujo del proyecto se separa con facilidad en capas.
- En la capa de percepción, la RealSense D455 y LingBot-Depth observan la escena y entregan la información espacial.
- En la capa de inteligencia, LingBot VLA V2 conecta el estado visual actual con una decisión de acción.
- En la capa de cómputo, la Jetson AGX Thor mantiene esas cargas de trabajo cerca del hardware.
- En la capa de ejecución, LeKiwi y el SO-ARM convierten la decisión en desplazamiento y manipulación.