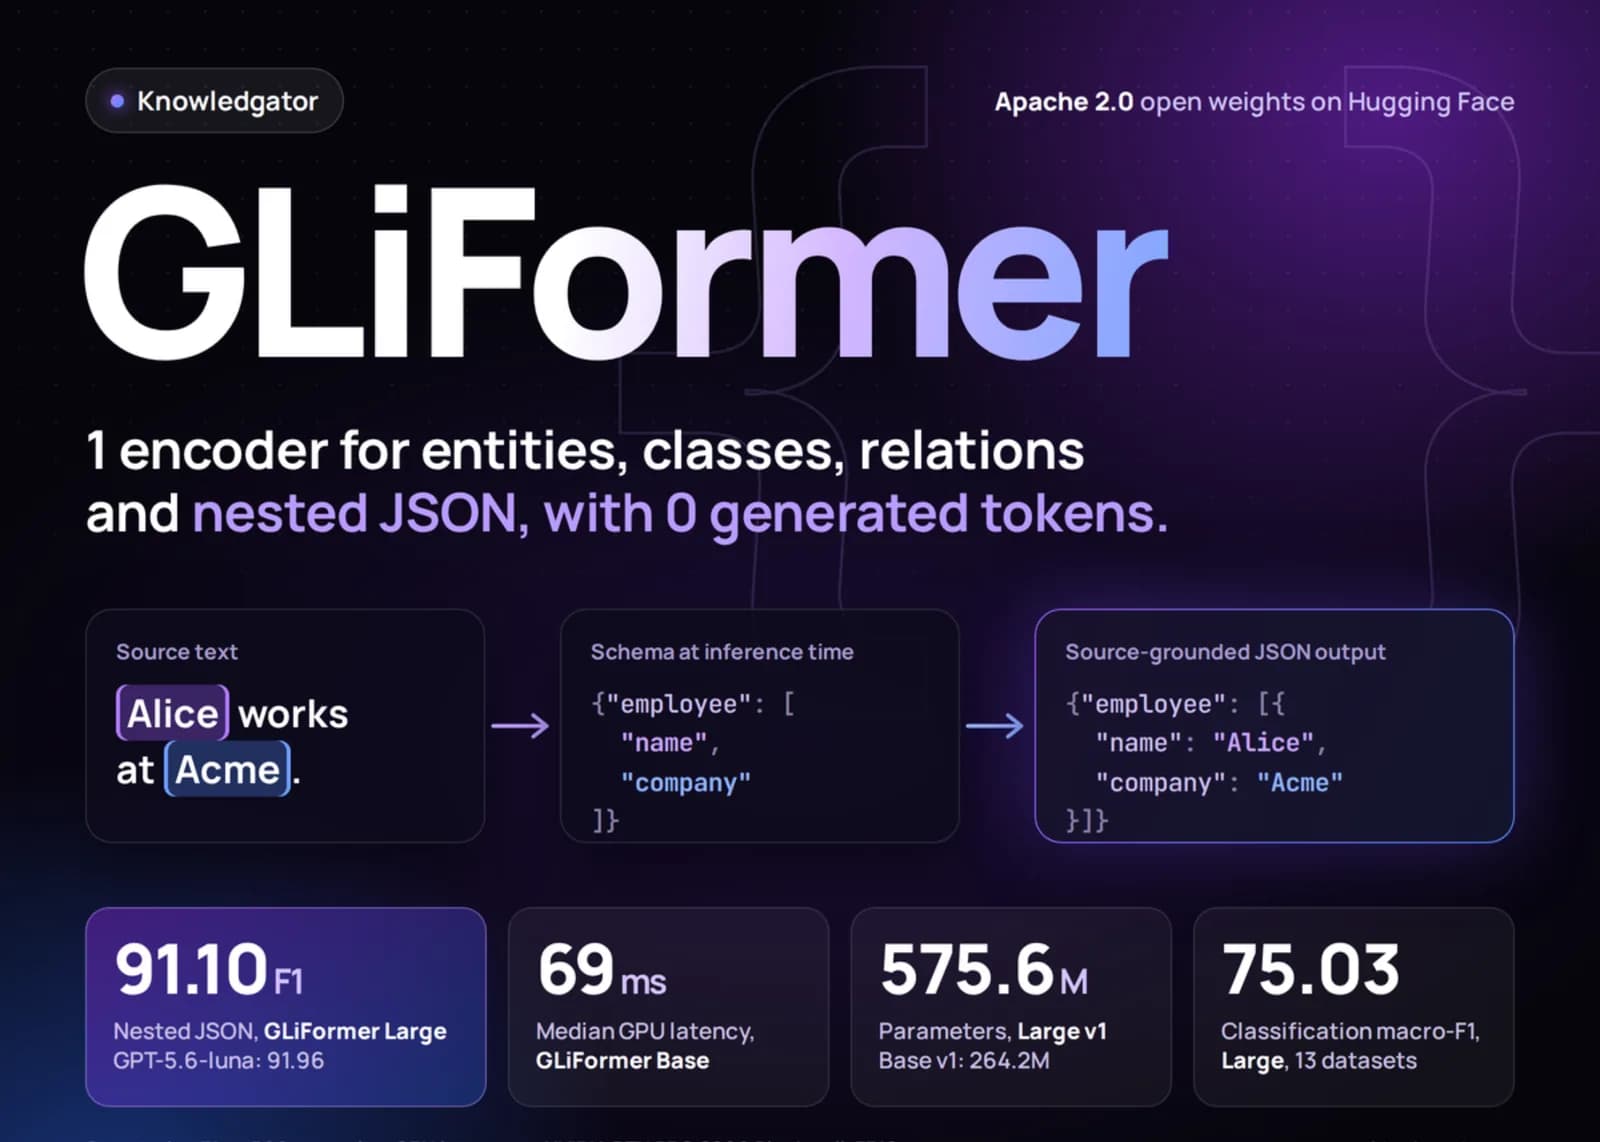
Knowledgator Engineering publicó GLiFormer, un marco de codificadores condicionado por esquema para extracción de información. Un mismo modelo resuelve reconocimiento de entidades nombradas (NER), clasificación de texto, extracción de relaciones, estructuración en JSON anidado y generación de embeddings. Las etiquetas y los esquemas de extracción se entregan en tiempo de inferencia.
Hay dos checkpoints en Hugging Face. GLiFormer Base v1 tiene 264,2 millones de parámetros y GLiFormer Large v1 tiene 575,6 millones. Los dos van con licencia Apache 2.0, se instalan con pip install gliformer y corren en CPU o en GPU.
¿Qué problema ataca?
Las cadenas de extracción suelen encadenar modelos separados. Uno etiqueta entidades, otro clasifica documentos y un tercero reconstruye los registros. El equipo de investigación sostiene que esas tareas comparten una misma operación de fondo, que consiste en codificar la fuente, representar los conceptos pedidos y puntuar su compatibilidad.
Un modelo de lenguaje grande puede emitir JSON anidado, aunque genera los nombres de campo, la puntuación y los valores token por token. GLiFormer saca la generación de salida de ese camino.
Cómo funciona
GLiFormer se construye sobre GLiNER y generaliza su emparejamiento de etiquetas mediante un ancla. El ancla es el objeto contra el que se puntúa cada etiqueta en tiempo de ejecución, y puede ser un vector de grupo para clasificación, un par de entidades para relaciones o una ranura de registro.
La fuente se codifica una sola vez. Varios esquemas sobre el mismo documento corren después como grupos locales de tarea sobre esa codificación compartida. El cómputo de las cabezas igual crece con la cantidad de grupos, etiquetas y anclas.
Para NER, la cabeza puntúa evidencia de inicio, de fin y de interior para cada par de token y etiqueta. Las salidas sigmoide independientes permiten que convivan menciones anidadas y límites compartidos.
La estructuración corre en cuatro etapas. Primero fija los valores de campo como fragmentos tomados directamente del texto fuente. Segundo, asigna esos fragmentos a ranuras de registro sin orden, entrenadas con emparejamiento húngaro. Tercero, predice enlaces dirigidos de padre a hijo, restringidos a las rutas que el esquema permite. Cuarto, ensambla el JSON anidado con un decodificador determinista.
Como los valores son fragmentos de la fuente, el modelo no puede inventar texto que no esté en la entrada. La selección de fragmentos, la asignación de registros y la jerarquía sí pueden salir mal.
Checkpoints y entrenamiento
Los dos checkpoints v1 usan el tipo de modelo gliformer-layout con cinco cabezas, para NER, clasificación, relaciones conjuntas, estructuración multinivel y embeddings. Cada uno configura un ancho máximo de fragmento de 12 palabras y 100 anclas de registro.
GLiFormer-base parte de un backbone DeBERTa que recibió preentrenamiento adicional sobre 100.000 millones de tokens. El paper documenta 1.357.671 ejemplos para el entrenamiento multitarea amplio y 372.090 para el post-entrenamiento enfocado por tarea.
Los números que reporta Knowledgator
Todos los puntajes de abajo los informa la propia empresa.
- JSON anidado, 500 ejemplos. Large marca 91,10 de F1 y Base 87,20. GPT-5.6-luna llega a 91,96 y GPT-5-mini a 82,56. La métrica es tolerante al orden y a los límites, y no exige coincidencia exacta del JSON.
- Clasificación, 13 conjuntos de datos. Large alcanza 75,03 de macro-F1 promedio y Base 72,36. GLiNER2.5 queda en 64,89 y GPT-5-mini encabeza con 79,79.
- CrossNER, 5 dominios. Base promedia 65,10 de F1 y Large 64,35. Gemma-4-31B-IT llega a 70,74.
- Relaciones, 4 pruebas. Large promedia 21,33 de micro-F1 y Base 18,94. GLiNER-Relex alcanza 25,6 y Gemma-4-31B-IT 25,08.
En los agregados combinados de NER y clasificación, el paper reporta que Large le gana a Gemma-4-E4B con unas 14 veces menos parámetros.
Velocidad sin generar tokens
Knowledgator midió GLiFormer-base sobre 40 documentos de estructuración con tamaño de lote 1. La latencia mediana fue de 69 ms en una GPU NVIDIA RTX PRO 6000 Blackwell en FP16, y de 547 ms en una CPU AMD EPYC 9B45 de ocho hilos en FP32.
La cifra de "hasta 95,8 veces más rápido" es una estimación analítica y no la medición de una corrida real contra un modelo de lenguaje. Asume prellenado a 2.000 tokens de entrada por segundo y generación a 60 tokens de salida por segundo, deja fuera las colas, la latencia de red y el razonamiento oculto, y no supone paridad de exactitud.
Cómo se usa
El repositorio en GitHub y la ficha del modelo muestran una llamada corta de estructuración.
records = model.structure(
    "Alice works at Acme.",
    {"employee": ["name", "company"]},
)
print(records)
# {'employee': [{'name': 'Alice', 'company': 'Acme'}]}
Los esquemas Pydantic anidados sirven para registros multinivel, y una sola llamada a inference puede correr entidades, clases y estructuras en conjunto. Para relaciones hay que usar joint_relations, porque los checkpoints v1 no traen una cabeza de relación abierta.