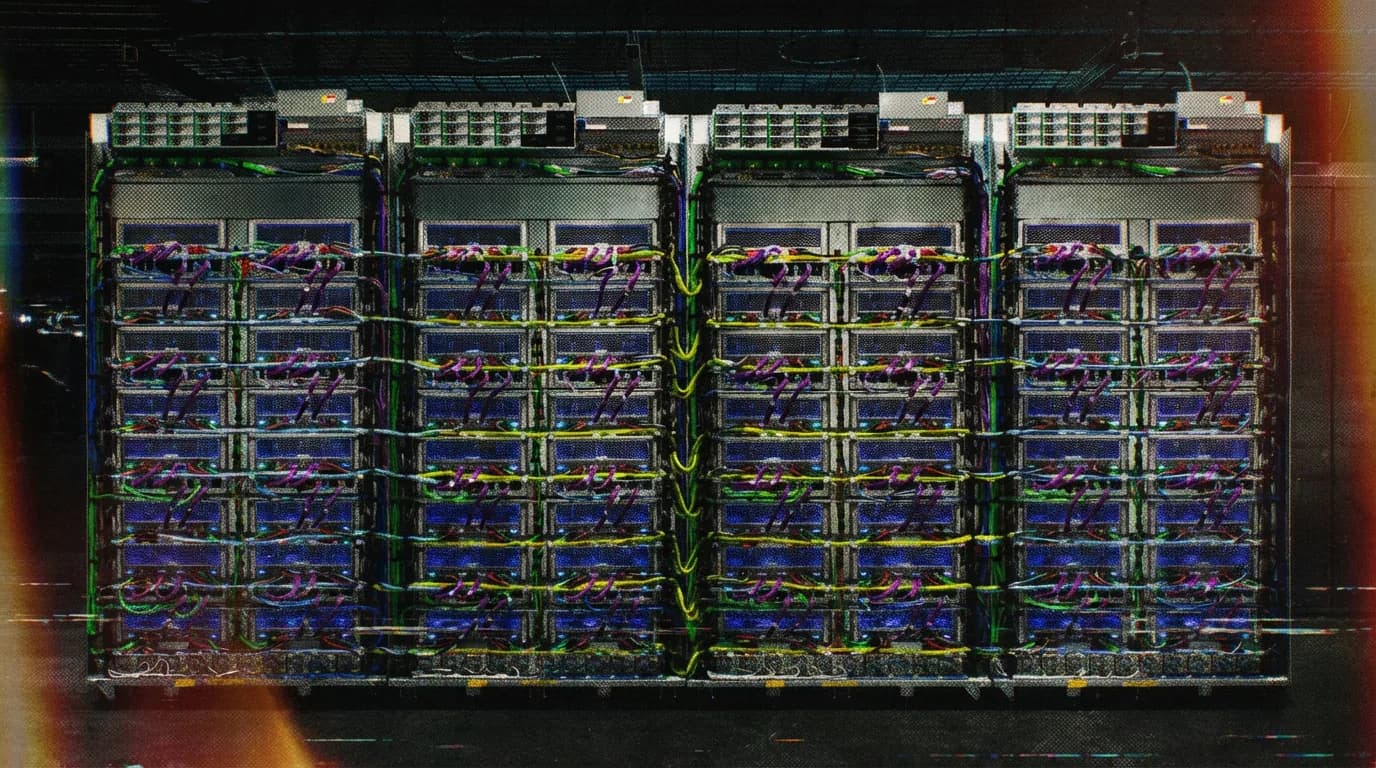
La octava generación de aceleradores de IA de Google tiene dos sistemas nuevos, la TPU 8tx, pensada para cómputo confidencial, y la TPU 8i Max, para cargas que consumen mucha memoria. Con esas dos, Google dice que por primera vez entregó cuatro sistemas TPU en un mismo año, según informó Maximilian Schreiner en The Decoder el 9 de noviembre.
Ninguna de las dos trae un chip nuevo. Están construidas sobre el silicio que ya existía, y lo que cambia es la configuración del sistema alrededor del mismo procesador: otro encapsulado, otra red y otra disposición de memoria. Google presenta ese enfoque modular como una decisión de diseño que le permite sacar variantes de hardware en meses y no en años.
La ampliación confirma el giro de Google, que ahora ofrece sus chips de IA propios como una plataforma amplia para clientes externos.
¿Qué hace la TPU 8tx?
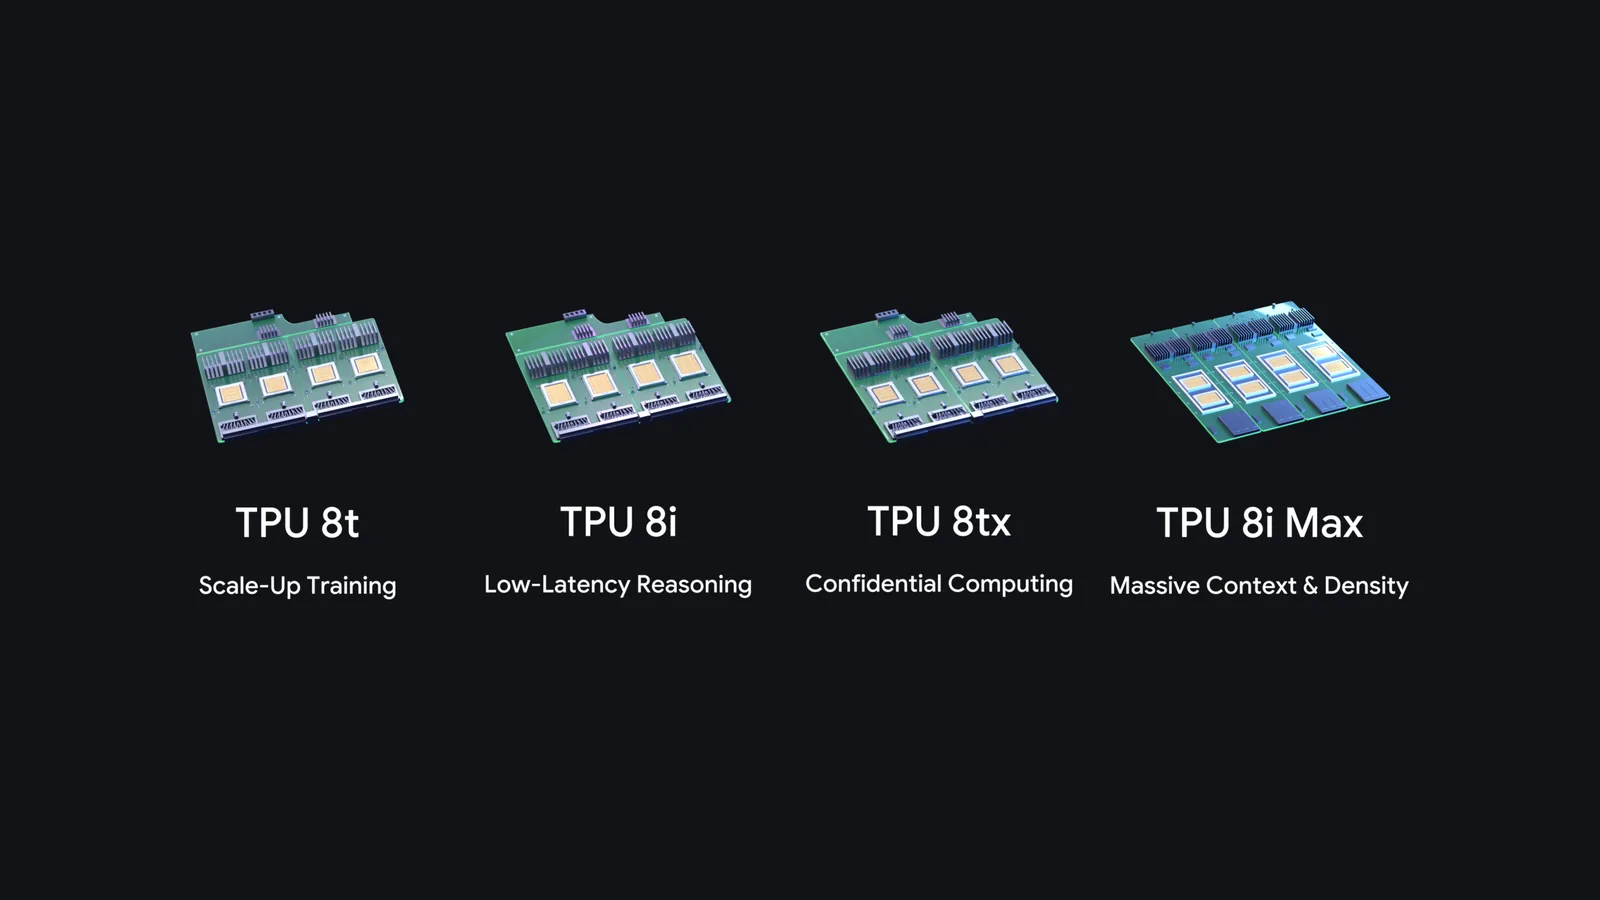
La TPU 8tx apunta a empresas y organismos de gobierno que trabajan con datos confidenciales. Normalmente los datos van cifrados cuando están almacenados y cuando viajan por la red, pero se descifran en memoria en cuanto el procesador trabaja con ellos.
Ese es el hueco que la TPU 8tx quiere cerrar. Según Google, los datos y los pesos del modelo siguen protegidos y aislados incluso mientras se usan. Nvidia ya ofrece una función comparable en sus GPU con su arquitectura de cómputo confidencial.
El sistema usa la misma red de baja latencia Boardfly que Google desarrolló para inferencia en tiempo real, y según la empresa reduce la latencia hasta el doble frente a la TPU 8t. Google dice que con un solo sistema una empresa puede ajustar modelos, destilar modelos grandes en otros más chicos y entrenar agentes de IA con aprendizaje por refuerzo, sin mover datos sensibles entre clústeres distintos.
¿Qué cambia con la TPU 8i Max?
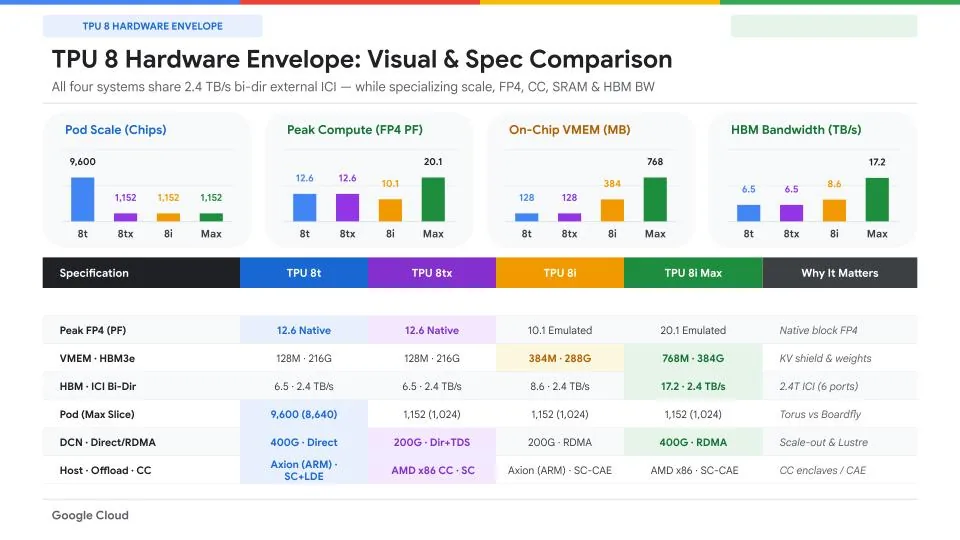
La TPU 8i Max ataca otro problema, el cuello de botella de la memoria. Cuando varios agentes de IA trabajan al mismo tiempo sobre grandes bases de código o sobre horas de video, el ancho de banda de memoria es lo que frena. Google lo resolvió poniendo dos chips TPU 8i en un mismo encapsulado.
El resultado es el doble de cómputo, el doble de memoria y el doble de ancho de banda de memoria en el mismo formato de rack. En la práctica eso significa mucho más rendimiento por metro cuadrado de centro de datos.
| Sistema | Enfoque | Cómo lo logra |
|---|---|---|
| TPU 8tx | Datos confidenciales | Datos y pesos protegidos y aislados durante el uso, red Boardfly |
| TPU 8i Max | Cargas con mucha memoria | Dos chips TPU 8i en un encapsulado, el doble de cómputo y memoria por rack |
Software para usar las TPU sin reescribir código
Además del hardware, Google trabaja para que las TPU sean más fáciles de usar. La empresa liberó como código abierto TorchTPU, para que el código escrito en PyTorch corra en TPU con cambios mínimos. También soporta frameworks de inferencia populares como vLLM y SGLang.
La inferencia empuja la carrera de los chips propios
La expansión responde al cambio de estrategia de Google, que dejó de tratar las TPU como una herramienta solo interna y las vende como plataforma competitiva para clientes de afuera. La empresa ya cuenta cerca de 100 clientes externos de TPU.
Detrás hay una tendencia más amplia del mercado. A medida que se extienden las aplicaciones de IA, el foco pasa de las costosas corridas de entrenamiento a la inferencia, o sea la operación diaria de los modelos. Ahí es donde los chips especializados como las TPU pueden sacar ventaja, y por eso Amazon, Microsoft y OpenAI también desarrollan sus propios aceleradores.
Nvidia respondió reforzando su oferta de inferencia con el acuerdo de licencia y contratación de equipo que cerró con Groq.