TorchTPU es una colaboración de código abierto entre Google y Meta que agrega a PyTorch un backend nativo para las TPU de Google. Según el anuncio publicado en el blog de PyTorch, permite ejecutar modelos y migrarlos a TPU sin preparación previa, con rendimiento competitivo en inferencia y entrenamiento gracias a optimizaciones del modo de ejecución inmediata (eager), la integración con torch.compile y la aceleración nativa del hardware.
Las TPU de Google se usan, dentro y fuera de la compañía, para entrenar y desplegar modelos de aprendizaje automático a escala masiva. Están diseñadas específicamente para esa tarea y por eso entregan ventajas en rendimiento, energía y costo. Históricamente se asociaron a los ecosistemas de TensorFlow y JAX. TorchTPU es un esfuerzo que Google inició a mediados de 2025, junto con el equipo de PyTorch de Meta, para correr PyTorch de forma nativa en TPU.
¿Por qué no bastaba con PyTorch/XLA?
Para programar una TPU por debajo del framework de Python, los desarrolladores usan la pila del compilador XLA. En 2020 Google presentó la primera versión compilada de PyTorch para TPU, PyTorch/XLA, basada en Lazy Tensors. Fue la base, pero no logró seguirle el ritmo a la evolución de PyTorch, que avanza rápido y empujada por la comunidad.
Los equipos de Google y Meta enumeran sus problemas. PyTorch/XLA exigía modificar el código fuente para marcar a mano las regiones compilables, sufría tiempos de compilación muy altos, no soportaba el modo imperativo nativo de PyTorch (eager) y llegaba tarde a las nuevas primitivas de cómputo distribuido del ecosistema.
A diferencia de PyTorch/XLA y de TorchAX, que acomodaban PyTorch a la forma de trabajar de JAX, TorchTPU se construyó como un backend de TPU propio de PyTorch. La ejecución eager es prioridad y las cargas de trabajo existentes corren tal cual con cambios mínimos de código, por ejemplo .to("cuda") pasa a .to("tpu").
Los tres principios del proyecto
Al arrancar TorchTPU, el equipo fijó a propósito un conjunto de principios.
- Ciudadanía PyTorch. Ninguna dependencia de JAX en el runtime, un modo eager sólido,
torch.compile()basado en Torch Dynamo (no en Lazy Tensor) con rendimiento similar al de la compilación de JAX, soporte amplio para los modismos distribuidos de PyTorch (DDP, FSDP, DTensor y otros) entregando las operaciones colectivas de TPU en el nivel más bajo de la pila (por ejemplo, la API Process Group), integración fluida con el ecosistema y trabajo con la comunidad. - Foco en el usuario. Portar una carga de trabajo a TPU debería ser tan simple como cambiar
model.to("cuda")pormodel.to("tpu"). El equipo aclara que con ese cambio no se alcanza el rendimiento máximo de la TPU, porque las formas de los tensores, la partición y las operaciones de un modelo pueden estar sesgadas hacia la arquitectura de una GPU, pero el modelo debería correr de inmediato. Además se buscan mensajes de error útiles y accionables, y la integración con herramientas que la comunidad ya usa, comotorch.profiler, DTensor y Ray. - Mejorar el estado del arte. Construir algo que compita con PyTorch sobre GPU en cargas grandes, introducir compilación JIT para la ejecución eager con optimizaciones en tiempo de ejecución que acorten la distancia entre ejecutar operación por operación y ejecutar código compilado, y mejorar la pila de programación de TPU con dinamismo acotado, evitando recompilar en XLA cada vez que cambia una forma y explorando kernels dinámicos precompilables.
¿En qué estado está TorchTPU?
El proyecto sigue en desarrollo activo, ya se usa en producción para inferencia y entrenamiento en algunos de los clientes más grandes de Google Cloud y está publicado como código abierto en este repositorio de GitHub. Al momento del anuncio, el equipo informa estos avances.
- Soporte para modo eager y modo compilado, incluido un nuevo modo eager llamado DeferAndFuse.
- Soporte para unas 450 operaciones ATen (sin contar las que tienen delegados estructurales o compuestos), con pasada hacia adelante y hacia atrás para todas las operaciones Core ATen que requieren las principales arquitecturas de aprendizaje profundo.
- Posibilidad de escribir kernels propios con JAX/Pallas y con el DSL Helion.
- Ejecución validada sin modificaciones sobre los 5.000 modelos más descargados de Hugging Face. Entre los LLM figuran Qwen, DeepSeek, Gemma, Llama, Mistral, GPT, OPT, BLOOM, Falcon y StableLM. En audio y voz, Whisper, Wav2Vec2, HuBERT y MMS. En visión, DinoV2, SigLIP, CLIP, Swin Transformer, ConvNeXt, ViT, ResNet y DETR. En codificadores de texto y búsqueda, BERT, ALBERT y Electra, RoBERTa, DeBERTa, T5, MT5 y Flan-T5.
- Partición basada en DTensor validada.
- Inferencia en varios servidores (vLLM y SGLang) y cargas de ajuste fino y entrenamiento (TorchTitan) validadas, con orquestación basada en Ray.
- Integración validada con vLLM, SGLang, TorchTitan, Ray y TorchRec.
Cómo es una TPU por dentro
Las TPU de Google son ASIC diseñados para las operaciones tensoriales masivas en que se basa el aprendizaje profundo. Desde el punto de vista de la arquitectura de hardware, un chip TPU contiene, según la generación, estos bloques.
- Uno o más TensorCores, cada uno con una o más unidades de multiplicación de matrices (MXU), una unidad vectorial (VPU) y una unidad escalar (ver este enlace). Según la generación, una MXU puede tener 256 x 256 multiplicadores-acumuladores dispuestos en un arreglo sistólico.
- Uno o más SparseCores, unidades especializadas en operaciones dispersas (gather, scatter, embeddings) y en operaciones colectivas. Pueden trabajar en paralelo con un TensorCore y solapar cómputo con cómputo, o cómputo con comunicación.
- Una memoria HBM grande, de 288 GB a 8,6 TB/s en la TPU 8i, que guarda los datos y los comparte con la CPU.
- Una interconexión bidireccional entre chips (ICI) de 19,2 TBps en la TPU 8t y la 8i, que comunica los chips dentro de los TPU Slices que configura el usuario. Un Slice es un subgrupo lógico de un TPU Pod, con un número fijo de chips conectados en un toroide 3D (TPU 7 y TPU 8t) o en configuración Boardfly (TPU 8i).
- Una red bidireccional de centro de datos (DCN) de 400 GBps en la TPU 8t, que comunica chips de Slices distintos.
| Componente | TPU 8i | TPU 8t |
|---|---|---|
| Memoria HBM | 288 GB a 8,6 TB/s | sin dato en el anuncio |
| Interconexión ICI | 19,2 TBps | 19,2 TBps |
| Red DCN | sin dato en el anuncio | 400 GBps |
| Topología | Boardfly | toroide 3D |
Las TPU se programan con la pila del compilador XLA a través de dos puntos de entrada, StableHLO (una representación intermedia de alto nivel para operaciones de aprendizaje automático) y Mosaic (una representación intermedia de bajo nivel para kernels propios). El juego de instrucciones real de la TPU es propietario, puede cambiar y no es público. En la práctica, StableHLO y sobre todo Mosaic cumplen un papel equivalente al de PTX en las GPU de NVIDIA.
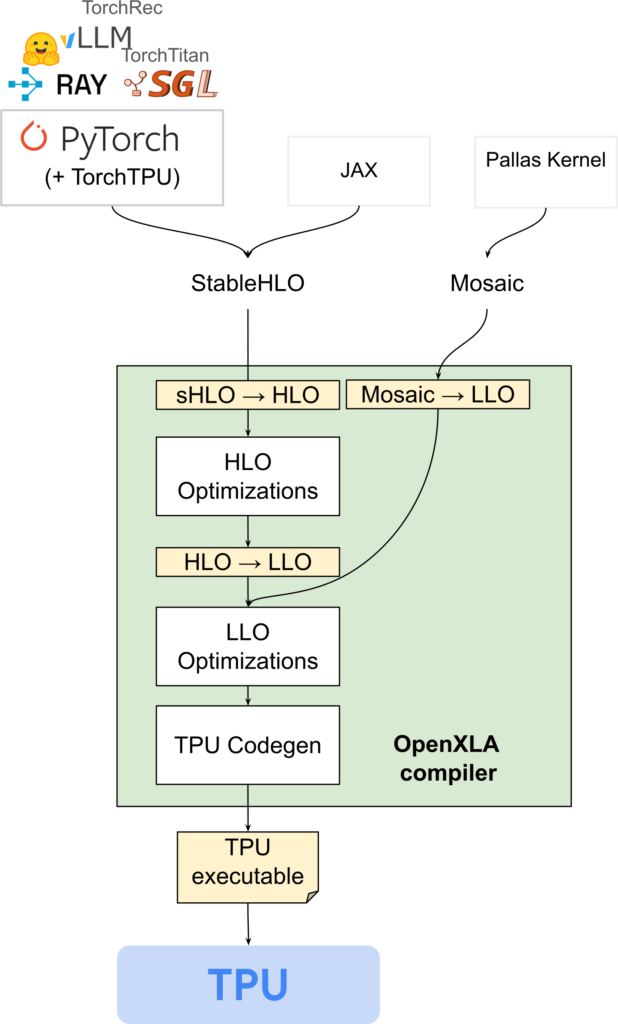
Un programa en C++ accede a una TPU local instanciando un cliente PjRT, cuya API permite compilar MLIR (StableHLO o Mosaic) a un ejecutable de TPU, lanzarlo y copiar datos hacia la TPU y desde ella. La ejecución es asíncrona, y la CPU espera un resultado esperando el PjRTBuffer asociado.
Lo que distingue a la TPU de una GPU
El equipo destaca varias características del modelo de programación.
- Un TensorCore se puede pensar como un procesador de un solo hilo con una o más MXU enormes. Para llegar al rendimiento máximo, las formas de los tensores del modelo tienen que ser lo bastante anchas para aprovechar la MXU completa. En una GPU, en cambio, lanzar varios kernels chicos en paralelo ayuda a usar mejor el hardware.
- El compilador XLA puede ordenarle a un TensorCore que derive las operaciones dispersas y colectivas al SparseCore, de forma automática o mediante anotaciones MLIR que el usuario agrega en un módulo StableHLO compilado.
- A una TPU solo puede acceder un proceso de espacio de usuario. Para integrarse con PyTorch, TorchTPU adopta un proceso por dispositivo en las cargas distribuidas, distinto del modelo de JAX, que usa un proceso por servidor. Por esa misma restricción, la colocación de aprendizaje por refuerzo (RL colocation) no funciona de entrada, y el equipo está estudiando cómo relajar o rodear ese límite.
- StableHLO sigue el paradigma SSA, que no permite mutaciones en el mismo lugar. Una escritura siempre produce un valor nuevo, al menos conceptualmente. TorchTPU igual ofrece la semántica de "vistas" de PyTorch, mutaciones incluidas, descomponiendo e invirtiendo esas vistas.
- XLA y el runtime PjRT suponen que las formas de los tensores se conocen al compilar. Como eso limita a PyTorch, el equipo agregó dinamismo acotado, que funciona cuando se conocen los máximos de cada dimensión al compilar y las dimensiones reales recién en ejecución.
- Las operaciones colectivas se traducen a XLA como operaciones StableHLO, en lugar de usar una biblioteca aparte como NCCL.
¿Cuánto código hay que cambiar?
TorchTPU se diseñó pensando en la facilidad de uso. Cuando se importa PyTorch en una máquina con TPU que tiene instalado el paquete de TorchTPU, el mecanismo de carga automática (autoload) de PyTorch hace que correr el código en TPU requiera solo cambios triviales, de un par de líneas.
Precisión numérica
TorchTPU adapta las API estándar de precisión de PyTorch al hardware de la TPU. Como toda arquitectura de alto rendimiento para aprendizaje automático, la TPU rinde al máximo con los tipos de datos nativos de su generación. El formato nativo de multiplicación de matrices es bfloat16 (BF16), que equilibra rango dinámico alto con buen rendimiento. Las MXU operan con entradas BF16 y acumulación intermedia en punto flotante de 32 bits, y esa configuración es la base del cómputo de alto rendimiento en TPU.
Para las operaciones que no son de contracción (sumas elemento a elemento, activaciones, layernorm y softmax), TorchTPU ejecuta las operaciones en FP32 con la unidad vectorial (VPU), que hace aritmética FP32 IEEE-754 completa de forma nativa.
TorchTPU traduce los modos de precisión de PyTorch a configuraciones de XLA y StableHLO. En el modo medium, las multiplicaciones usan menor precisión (las entradas se convierten a BF16 nativo para la MXU) y la acumulación se hace en FP32 para mantener la estabilidad. Es el modo por defecto, porque una multiplicación BF16 en una sola pasada con acumulación FP32 entrega precisión suficiente para casi todas las cargas de aprendizaje profundo, según el equipo.