Hugging Face sumó a la biblioteca transformers el soporte para ejecutar modelos GGUF de forma eficiente, con lo que se pueden usar checkpoints dimensionados para la memoria de un notebook a través de las mismas APIs de siempre. Se elige un GGUF del Hub, se carga con from_pretrained y se empieza a generar en la propia máquina.
Correr modelos de inteligencia artificial en el notebook se volvió mucho más fácil, y llama.cpp tuvo una parte grande en eso. Su motor de inferencia mueve herramientas locales como Ollama, LM Studio y Jan. Junto a proyectos como MLX, ayudó a que la inferencia local sea una opción práctica para el uso diario.
GGUF, desarrollado por el equipo de llama.cpp, es un formato de uso extendido para inferencia local. Ese mismo equipo comparte checkpoints cuantizados bajo ggml-org en el Hub. Publicadores como Unsloth, LM Studio Community y bartowski también entregan checkpoints GGUF listos para usar en un rango de cuantizaciones, de modo que cada uno elige la versión que le calza a su máquina. Los modelos GGUF se descargaron millones de veces.
La idea es facilitar también correr esos modelos de forma local con transformers. La compatibilidad sirve solo si el modelo resulta agradable de ejecutar, así que para acercar el rendimiento al de llama.cpp se reutilizan sus kernels de ggml por medio de la biblioteca kernels y se recorta la sobrecarga en generate. El foco inicial es la inferencia local en Apple Silicon, empezando por la arquitectura Qwen3.5.
¿Qué es el formato de archivo GGUF?
GGUF empaqueta en un solo archivo los pesos del modelo y sus metadatos, incluida la información del tokenizador y una plantilla de chat opcional. Admite distintos niveles de cuantización, lo que permite cambiar algo de precisión por una huella de memoria más chica. Variantes como Q4_K_M mezclan precisiones por tensor, con pesos de 4 bits en la mayor parte y tensores sensibles a precisión más alta.
La recomendación es partir con Q4_K_M y después probar Q5_K_M o Q6_K si hay más memoria disponible. Una cuantización más agresiva ayuda a que quepan modelos más grandes, pero el costo en calidad depende del modelo y de la tarea. Conviene evaluarlo sobre el trabajo que uno quiere que el modelo haga de verdad. La documentación de GGUF del Hub describe los tipos de cuantización disponibles, y los tamaños de archivo según cuantización se ven en el repositorio de Qwen3.5-4B de Unsloth.
Cómo cargar un GGUF con transformers
Para partir hacen falta tres cosas.
- Un Mac con Apple Silicon.
- Una versión de PyTorch soportada por los builds publicados del kernel ggml-quantization, por lo general las dos últimas versiones de PyTorch.
- La última versión de transformers, hoy la rama principal hasta el próximo release, y una versión compatible de
kernels.
pip install -U "git+https://github.com/huggingface/transformers.git" kernelsPara cargar un modelo GGUF se pasa el model_id del Hub y el nombre del archivo como gguf_file a from_pretrained.
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

model_id = "unsloth/Qwen3.5-4B-GGUF"
filename = "Qwen3.5-4B-Q4_K_M.gguf"

tokenizer = AutoTokenizer.from_pretrained(model_id, gguf_file=filename)
model = AutoModelForCausalLM.from_pretrained(
    model_id,
    gguf_file=filename
)
No hace falta configuración extra. Cuando los pesos se mantienen empaquetados sobre Metal, transformers carga de forma automática los kernels de capa de ggml y Metal compatibles y usa ggml-org/ggml-attn como implementación de atención. Si ese kernel no se puede descargar, el modelo cae de vuelta a "sdpa" con una advertencia, y siempre se puede forzar "sdpa" pasando attn_implementation="sdpa" de forma explícita. La documentación de GGUF en transformers trae más opciones de carga.
Ese es el único paso específico de GGUF. Todo lo que viene después es la API estándar de transformers.
messages = [{"role": "user", "content": "Explain why the sky is blue in a few sentences."}]
inputs = tokenizer.apply_chat_template(
    messages,
    tokenize=True,
    add_generation_prompt=True,
    return_dict=True,
    return_tensors="pt",
).to(model.device)

with torch.inference_mode():
    outputs = model.generate(**inputs, max_new_tokens=256)

print(tokenizer.decode(outputs[0], skip_special_tokens=True))
Sin un kernel de cuantización compatible, el cargador cae en descuantizar el modelo y ocupa más memoria.
Servir un GGUF desde la interfaz que uno prefiera
El mismo checkpoint también se usa con transformers serve, que expone una API compatible con la de OpenAI.
pip install -U "transformers[serving] @ git+https://github.com/huggingface/transformers.git" kernels

transformers serve "unsloth/Qwen3.5-4B-GGUF:Qwen3.5-4B-Q4_K_M.gguf"
El argumento del modelo tiene el formato <model_id>:<filename>.gguf. Antes de los dos puntos va el repositorio del Hub, unsloth/Qwen3.5-4B-GGUF, y después el archivo que se carga, Qwen3.5-4B-Q4_K_M.gguf. Así se elige una cuantización específica dentro de un repositorio que puede tener varias.
Para modelos cuya plantilla de chat admite razonamiento, se agrega --reasoning off para saltárselo o --reasoning on para habilitarlo. El valor por defecto, --reasoning auto, sigue lo que diga la plantilla. Se puede conectar un cliente como Jan o Pi agregando un proveedor personalizado compatible con la API de OpenAI. transformers corre el modelo en el Mac y el cliente aporta la interfaz de conversación.
¿Qué tan lejos queda de llama.cpp?
La referencia de rendimiento para inferencia local es llama.cpp. La comparación cubre tres checkpoints GGUF, un modelo denso chico, uno denso más grande y uno de mezcla de expertos.
La columna de llama.cpp sale de la herramienta llama-bench, build 5f55650a7, release b10200, backend Metal de ggml 0.18.0, ejecutada como llama-bench -m <file> -p 0 -n 128 -r 3, que informa tg128, la tasa de generación de tokens sobre 128 tokens decodificados, promediada en tres repeticiones y con el procesamiento del prompt excluido. La columna de transformers es generate produciendo esos mismos 128 tokens a partir de un prompt de 12 tokens, el mejor de tres corridas ya calientes, e incluye el prefill.
Todo medido sobre un MacBook Pro M2 Max con 32 GB de memoria unificada, macOS 26.6, PyTorch 2.12.1, kernels 0.17.0 y el equipo enchufado.
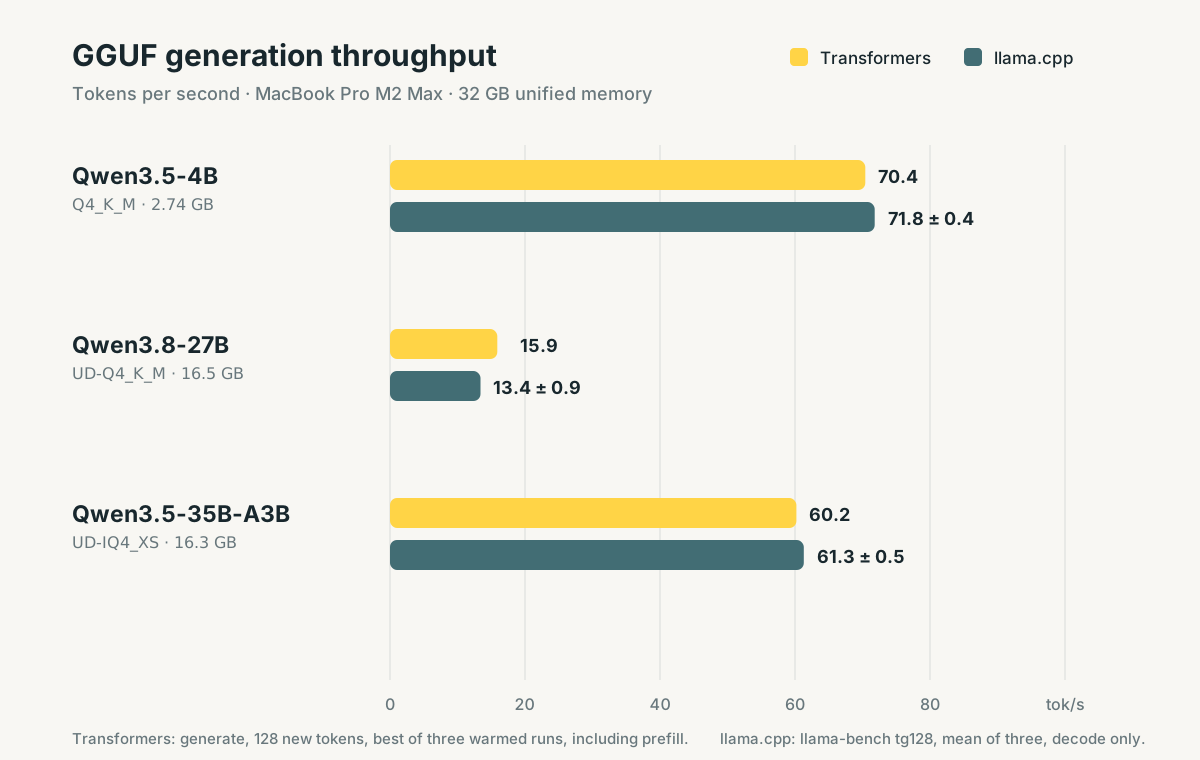
Transformers queda cerca de llama.cpp en los tres checkpoints. El gráfico usa las mismas mediciones descritas arriba y no implica condiciones idénticas de prueba, porque la medición de transformers incluye el prefill mientras que llama-bench informa rendimiento solo de decodificación.
Para qué sirve cada uno
Cuando GGML y llama.cpp se sumaron a Hugging Face, se describieron sus roles como complementarios. llama.cpp aporta la base para la inferencia local y transformers aporta la base para la definición de modelos. El soporte de GGUF acerca esas dos piezas.
llama.cpp sigue siendo el motor recomendado cuando la prioridad es la inferencia local eficiente. Su runtime dedicado, su manejo de memoria y su soporte amplio de hardware están construidos con ese objetivo. Lo que la integración agrega es trabajar con los mismos checkpoints GGUF dentro de transformers.
- Experimentar con GGUF en Python y PyTorch. Inspeccionar activaciones intermedias con hooks, modificar el paso hacia adelante de un modelo o prototipar capas propias con las herramientas habituales de PyTorch.
- Evaluar modelos GGUF. Usar los flujos de evaluación que ya se tienen en transformers para medir la calidad de los checkpoints cuantizados.
- Validar conversiones a GGUF. Cargar el checkpoint original y su conversión a GGUF en transformers facilita comprobar que los pesos se convirtieron bien, considerando el error de cuantización.
- Probar ideas nuevas de decodificación. Usar procesadores de logits y criterios de parada propios con
generate, o escribir el bucle de generación completo en Python. - Afinar desde un checkpoint GGUF. Descuantizar los pesos y seguir con un flujo de entrenamiento estándar de transformers.
Para ese último caso se usa GgufConfig(dequantize=True).
import torch
from transformers import AutoModelForCausalLM, GgufConfig

model = AutoModelForCausalLM.from_pretrained(
    "unsloth/Qwen3.5-4B-GGUF",
    gguf_file="Qwen3.5-4B-Q4_K_M.gguf",
    quantization_config=GgufConfig(dequantize=True),
    dtype=torch.bfloat16,
)
Los kernels de ggml más allá de GGUF
La oportunidad más grande es llevar el rendimiento de ggml a modelos que llama.cpp no soporta.
transformers ya trae las implementaciones en PyTorch de esas arquitecturas. Con los kernels y los esquemas de cuantización de ggml disponibles en PyTorch, se puede acelerar las operaciones soportadas sin implementar antes el modelo entero en llama.cpp. Eso sirve sobre todo para arquitecturas nuevas, modelos de investigación y variantes propias que quizá nunca reciban una implementación dedicada en llama.cpp.
La oportunidad se extiende más allá del propio formato GGUF. Un kernel opera sobre tensores y no exige que el modelo completo venga de un archivo GGUF, así que los mismos bloques se integran en otros modelos y flujos de carga de transformers. También abre un camino hacia otras modalidades. Modelos de visión por computador, de audio y multimodales podrían reutilizar kernels compatibles de atención, normalización y multiplicación de matrices sin tener antes una implementación completa en llama.cpp. Cada arquitectura igual necesita integración y validación, y los ejemplos iniciales con GGUF cubren generación de texto.
Inferencia local rápida con Python y PyTorch
El objetivo también fue mostrar hasta dónde se llega manteniendo el modelo y el bucle de generación en Python. Con los kernels correctos y un bucle de generación eficiente, Python y PyTorch entregan buen rendimiento de inferencia local. Los kernels se hacen cargo del cómputo pesado, mientras el bucle de generación mantiene ocupada la GPU evitando sincronizaciones innecesarias.
El foco fue hacer rápida la ejecución en modo eager sin obligar a usar torch.compile. Para uso interactivo se buscaba un arranque rápido y un flujo parejo de tokens, sin pausas de compilación ni recompilaciones cuando cambian las formas de la entrada. Las dos piezas principales de ese trabajo son los kernels y el propio generate.
Un kernel es un programa pequeño que ejecuta una operación en la GPU. PyTorch entrega implementaciones de propósito general, y un kernel especializado puede hacer menos trabajo, combinar varias operaciones o leer los pesos cuantizados directo en el formato en que están guardados.