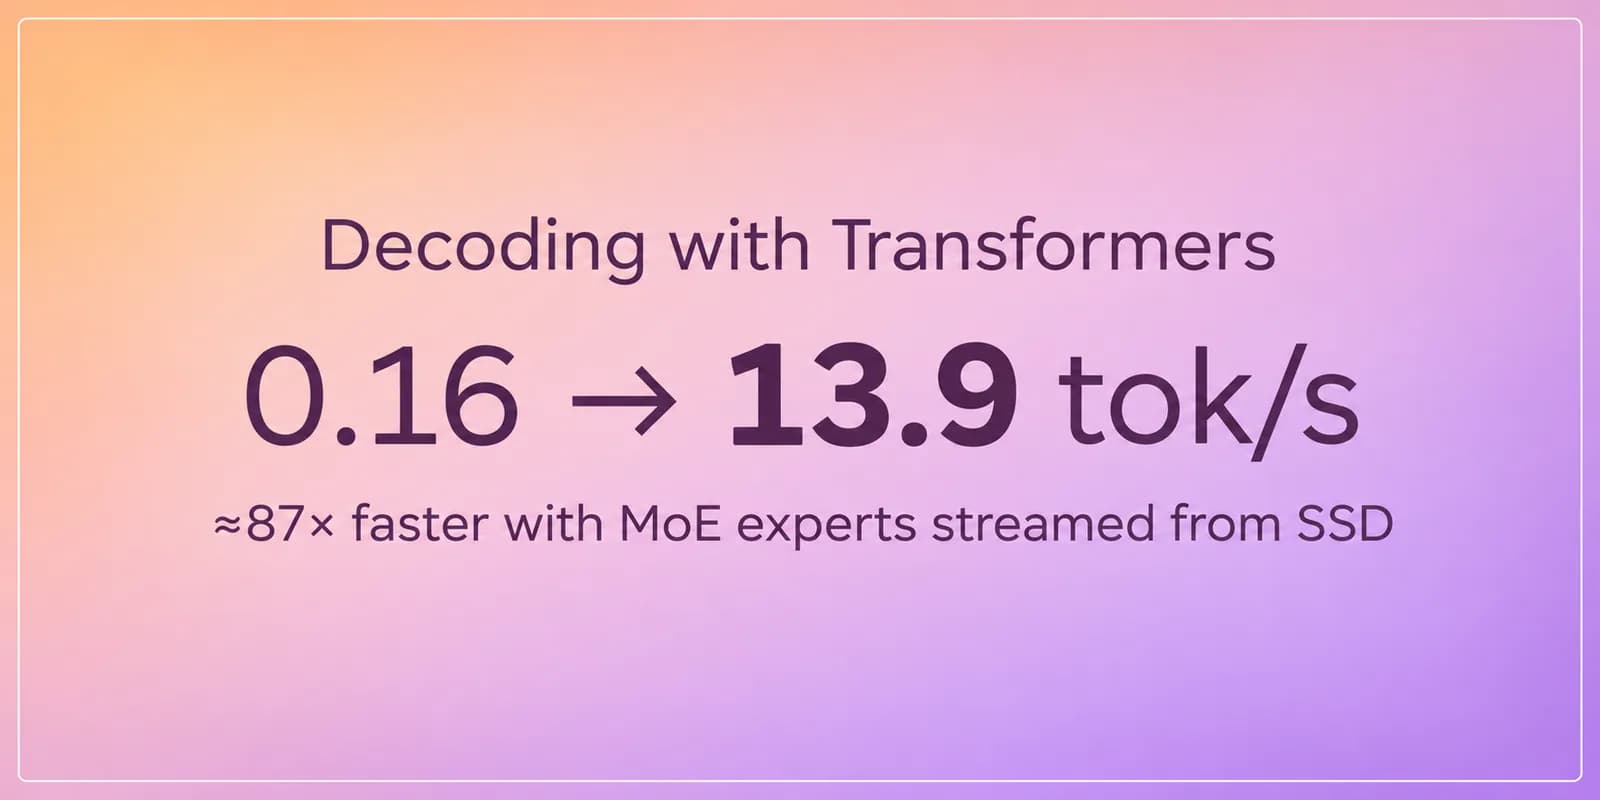
Hacer streaming de los expertos de un modelo MoE directamente desde el SSD deja a Transformers a 6% de la velocidad de Strata al generar tokens. Es el resultado de un experimento publicado en el blog de Hugging Face, que corre un modelo de 180.000 millones de parámetros en un MacBook M5 con 32 GB de memoria unificada.
El autor cuenta que intenta depender menos de los modelos en línea y correr modelos más grandes en local. En su casa tiene un PC con dos RTX 4090, al que llama Orthrus por el perro de dos cabezas de la mitología griega, y para trabajar usa un MacBook M5 con 32 GB de memoria unificada.
Orthrus corre Windows 11 porque sus hijos juegan todo el tiempo. Tenía arranque dual con Ubuntu, pero los juegos terminaron ocupando casi todos los dos terabytes del disco. Además, se declara fan del RMD (rooms moving development), o sea una hora en la cocina con café, dos en el escritorio y después el sillón. Una torre fija no le sirve.
Su primer experimento fue correr Qwen 3.8 27B con llama.app en Orthrus y usarlo desde el notebook a través de pi. Ese modelo hace las tareas de programación, un modelo en línea como Opus orquesta, y la segunda RTX corre un modelo FIM para el autocompletado en Neovim.
Cuando lo contó en redes sociales, la respuesta fue insistente. Le dijeron que usara Strata con Qwen3.8-Flash-Next.
¿Qué es Strata?
Strata es un motor de inferencia para modelos MoE como Qwen. Solo los expertos más usados quedan en la VRAM, y el resto va a la RAM o incluso al disco. Los expertos son más del 90% de los pesos de un modelo MoE, así que un modelo de 180B como este puede correr en una GPU con mucha menos memoria, como una RTX 4090.
También funciona en un notebook. El autor encontró una entrada de blog que hacía justo eso, Qwen3.8-Flash-Next en un Mac M4 de 32 GB, más rápido que llama.cpp, a 13,5 tokens por segundo.
Es demasiado lento para su forma de usar agentes de programación, pero el problema le pareció interesante. Hay toda una gama de modelos MoE que no caben en la memoria unificada de un MacBook y que podrían correr a una velocidad razonable.
¿Cómo descargan memoria los otros motores?
Antes de decidirse por Strata, revisó qué hacen llama.cpp, vLLM y Transformers cuando un modelo MoE no cabe. Importan tres preguntas. Dónde viven los expertos, dónde corre la multiplicación de matrices de cada experto y qué se mueve en cada token.
llama.cpp mapea el archivo GGUF con mmap y puede dejar los expertos en la CPU (--cpu-moe, --n-cpu-moe N, -ot "exps=CPU", o --fit on para que elija solo). Esos expertos también se calculan en la CPU, así que por PCIe solo cruzan las activaciones, nunca los pesos. Funciona muy bien cuando los expertos caben en la RAM. Cuando no caben, la caché de páginas colapsa. Hace poco llegó una caché de expertos en GPU (--moe-cache-mib), pero fragmenta el grafo (las 2 divisiones por token pasan a 50) y pierde cerca de 10% incluso cuando todo cabe.
En vLLM, la opción --cpu-offload-gb N deja N GB de pesos en RAM fijada, y los kernels los leen en su lugar a través de PCIe. En una capa MoE eso afecta solo a los expertos enrutados, pero no hay caché. Un experto muy usado vuelve a cruzar PCIe en cada token, y no existe un nivel de disco. Por defecto, los pesos descargados incluyen las capas densas, que se leen en cada token, y --cpu-offload-params experts lo limita a los expertos. Ese diseño calza con los lotes grandes de vLLM, que tocan casi todos los expertos de todas formas, y mucho menos con un solo usuario en una GPU.
Transformers descarga a través de Accelerate (device_map="auto", offload_folder), un módulo a la vez. Unos ganchos copian los pesos del módulo a la GPU antes de forward. En un MoE ese módulo es el banco completo de expertos de una capa, así que cada token copia todos los expertos de cada capa descargada para usar 8 o 10. No hay caché ni noción de enrutamiento. Y en un Mac la CPU y la GPU comparten la misma memoria, así que "descargar a la CPU" no libera nada.
El autor probó los tres con Qwen3.6-35B-A3B en una A10G (24 GB) con RAM de sobra, y Harry Mellor volvió a correr vLLM con mejores opciones. Descargar solo los expertos duplica la velocidad de vLLM, y FP8 ayuda todavía más (la mitad de bytes por experto y más modelo dentro de la GPU). El otro modo de descarga de vLLM, que copia grupos de capas por adelantado, corrió a menos de 1 token por segundo.
Si los expertos caben en la RAM, llama.cpp es difícil de superar. Si no caben, hay que traer solo lo que elige el enrutador, a través de una caché acotada y lo bastante rápido para que el cuello de botella sea el SSD y no Python, idealmente reusando los kernels rápidos de expertos del propio modelo. Ese es el caso de Qwen3.8-Flash-Next en un Mac de 32 GB, y Transformers no lo resolvía de fábrica.
Qwen3.8-Flash-Next en un Mac de 32 GB con Transformers
Strata ya era demasiado lento para él en el notebook, y Transformers no iba a superarlo pronto. Pero el camino de Accelerate estaba tan lejos que quiso arreglar la descarga dentro de Transformers, con el modelo grande en su notebook como meta, sabiendo que probablemente seguiría siendo lento para su forma de trabajar.
Todo el código se construyó con IA, desde el PR a Transformers hasta el paquete específico del modelo y los kernels de Metal. Su parte fue elegir qué probar, leer los perfiles de rendimiento y decidir qué conservar. Todo está en un Space, tarekziade/moe-expert-streaming.
Empezar en chico
Partió con OLMoE-1B-7B, que cabe en memoria, para comparar cada token con Transformers sin cambios.
La primera versión tenía los expertos en disco, una caché LRU en el dispositivo y un bucle de Python que corría un experto a la vez. Con todos los expertos ya en caché llegó a 10,1 tokens por segundo, contra unos 32 de la versión sin cambios. La lectura de disco estaba bien y el problema era su bucle, porque la versión original usa grouped_mm, que corre todos los expertos de una capa en un solo kernel.
La solución, y la idea central del proyecto, fue convertir la caché en un pool de ranuras. Es un tensor único reservado de antemano en el dispositivo y compartido por todas las capas, más una tabla por capa que traduce el identificador de cada experto a su ranura. Al remapear los identificadores que entrega el enrutador, el pool se ve como un banco de expertos normal y grouped_mm corre sobre él tal cual, sin una multiplicación de matrices propia. Con eso llegó a 34,6 tokens por segundo, contra 38,1 de la versión sin cambios.
La opción experts_offload
Después convirtió el cargador independiente en una opción de from_pretrained, en huggingface/transformers#50717. Para probarlo hay que instalar Transformers desde ese PR.
pip install "git+https://github.com/huggingface/transformers.git@refs/pull/50717/head"Luego, pasando de OLMoE al objetivo real, Qwen3.8-Flash-Next:
path = snapshot_download("tarekziade/Qwen3.8-Flash-Next-expert-streaming")

model = AutoModelForCausalLM.from_pretrained(
    f"{path}/dense",
    dtype=torch.bfloat16,
    device_map={"": "mps", "experts.*": "disk"},
    quantization_config=MetalConfig(bits=8),
    experts_offload={
        "cache_bytes": 12 << 30,
        "quantized_experts": f"{path}/experts-q3",
    },
)
Ese repositorio guarda la salida del script de conversión del proyecto, con los pesos densos, los expertos cuantizados a 3 bits y la tabla de n-gramas.
Los expertos asignados a "disk" pasan por el camino de streaming en vez de la descarga de Accelerate. El cargador se salta sus tensores y las capas MoE cambian a una implementación descargada. Los fallos de caché los leen 8 hilos de entrada y salida, con una lectura contigua por experto. Los enrutadores de las dos capas siguientes corren antes, sobre los estados ocultos actuales, para adivinar qué expertos conviene traer por adelantado. Los expertos se pueden cuantizar antes, para que las lecturas sean más chicas. Funciona con modelos MoE que usen la disposición estándar de expertos.
La API todavía se discute con los mantenedores de Transformers. La forma con device_map salió de esa conversación, y los expertos cuantizados probablemente pasarán por el plan de cuantización por capa de #50245 en vez de tener una opción propia.
121 GB de expertos en un Mac de 32 GB
Qwen3.8-Flash-Next tiene 48 capas de 512 expertos (10 activos), que suman 121 GB en FP8. No basta con hacer streaming de los expertos, porque además hay una tabla de embeddings de n-gramas de 51 GB que necesita su propio camino a disco. La configuración quedó así:
- expertos cuantizados a 3 bits, 49 GB en disco y 12 GiB en la caché del dispositivo
- capas densas en 8 bits (unos 5,4 GB, con 0,2% más de perplejidad que en BF16)
- la tabla de n-gramas se queda en disco y sus filas se leen cuando hacen falta
La conversión toma unas 5 horas. Una vez cargado, el modelo usa unos 18 GiB, y un prompt de 6.000 tokens llega a un máximo de 25,4 GiB. Es más o menos el límite. El autor tiene que cerrar el navegador o macOS empieza a usar swap.
Las piezas específicas del modelo (la tabla de n-gramas y los kernels de Metal) viven en un paquete chico, moe-expert-streaming, sobre el PR. La primera versión corría a unos 10 tokens por segundo.
Después instaló Strata en el mismo M5, con los mismos prompts. Strata 0.1.60 usó expertos IQ3_XXS. Los dos corrieron en modo greedy, sin razonamiento, sin MTP ni borradores especulativos, y con bloques de prellenado de 1.024 tokens. La configuración completa y los resultados están en la página de detalles del Space.
También probó vllm-metal, vLLM para GPU de Apple a través de MLX, que hace poco sumó descarga de expertos. Trae los expertos enrutados desde un checkpoint de MLX a través de una caché acotada, igual que este proyecto. Pero no logra correr Qwen3.8-Flash-Next en 32 GB por el problema de los n-gramas, ya que solo hace streaming de los expertos y las tablas de n-gramas quedan en memoria. Eso son 32 GB en los checkpoints de MLX del Hub, antes de sumar los cerca de 5 GB de capas densas y cualquier caché de expertos.
Cómo se cerró la brecha
La mayor parte del tiempo no se fue en los expertos. Esto es lo que ayudó, según el autor:
- Enviar antes el trabajo a la GPU. PyTorch en MPS retiene los kernels chicos hasta la siguiente sincronización, así que la GPU quedaba ociosa mientras Python trabajaba. Forzar el envío después de cada bloque dio 10% más. Esto debería arreglarse en PyTorch.
- Kernels de Metal para las partes sin camino rápido en macOS, Gated DeltaNet y las hiperconexiones.
- Los pesos de Strata. Cambió a los pesos GGUF de Strata, lo que bajó el tráfico de pesos densos de 5,4 GB a 3,9 GB por token y el tamaño de cada experto de 2,15 MB a 1,75 MB, con un pool de caché separado para cada tamaño de experto.
- Prellenado. Pasó de 68 a unos 228 tokens por segundo con bloques más grandes y leyendo los expertos de la capa siguiente mientras se calcula la actual.
- Documentos largos. Atención solo sobre los bloques que elige el indexador, y una caché KV que crece en su lugar en vez de copiarse en cada token.
- Fallos de caché. Strata no los esconde, espera igual que esta versión, y ninguna política de caché le ganó por mucho a LRU. Lo que sirvió fue leer un solo experto adivinado por capa mientras el SSD habría quedado ocioso.
Así corre hoy una capa MoE para un token:
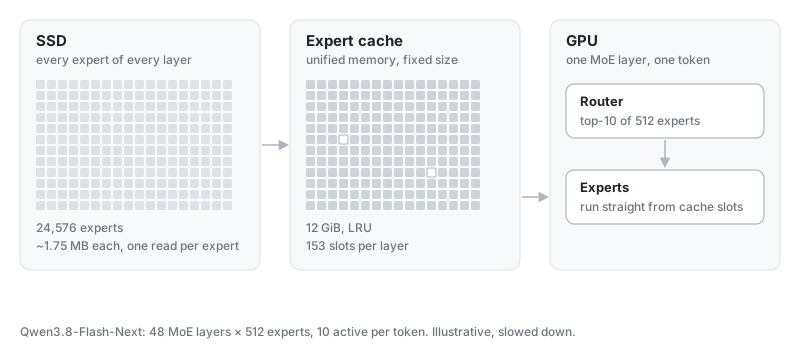
Con estas optimizaciones, en el mismo M5 y con los mismos prompts, la versión de Transformers quedó cerca de 6% detrás de Strata al decodificar textos cortos, con un prellenado algo más rápido.
Lo que falta son sobre todo los viajes de ida y vuelta al host, unos 10 ms por token. Despertar después de una sincronización es solo cerca de 1 ms de eso. El resto es la GPU sin trabajo mientras Python encola la siguiente capa. Strata encola de una vez todo el trabajo del token, y la GPU espera en un evento compartido de Metal en cada capa mientras el host lee expertos. PyTorch no expone ese mecanismo. El autor intentó imitarlo con un kernel que da vueltas sobre una bandera que escribe la CPU, y la GPU tardó entre un segundo y nunca en ver la escritura. La solución real sería una operación nativa en el stream MPS de PyTorch, con riesgo de bloqueos, y no la construyó.