
CUDA Python 1.0 estabiliza el acceso completo a la GPU
NVIDIA libera junto a CUDA 13.3 un conjunto oficial de bibliotecas con versionado semántico, y declara a Python un ciudadano de primera clase de su plataforma, a la par de C++.
NVIDIA Developer
Cobertura de inteligencia artificial: modelos de lenguaje, agentes autónomos, hardware especializado, política regulatoria y aplicaciones empresariales. Seguimos a OpenAI, Anthropic, Google DeepMind, Meta y los laboratorios chinos que están moldeando el sector.
NVIDIA libera junto a CUDA 13.3 un conjunto oficial de bibliotecas con versionado semántico, y declara a Python un ciudadano de primera clase de su plataforma, a la par de C++.
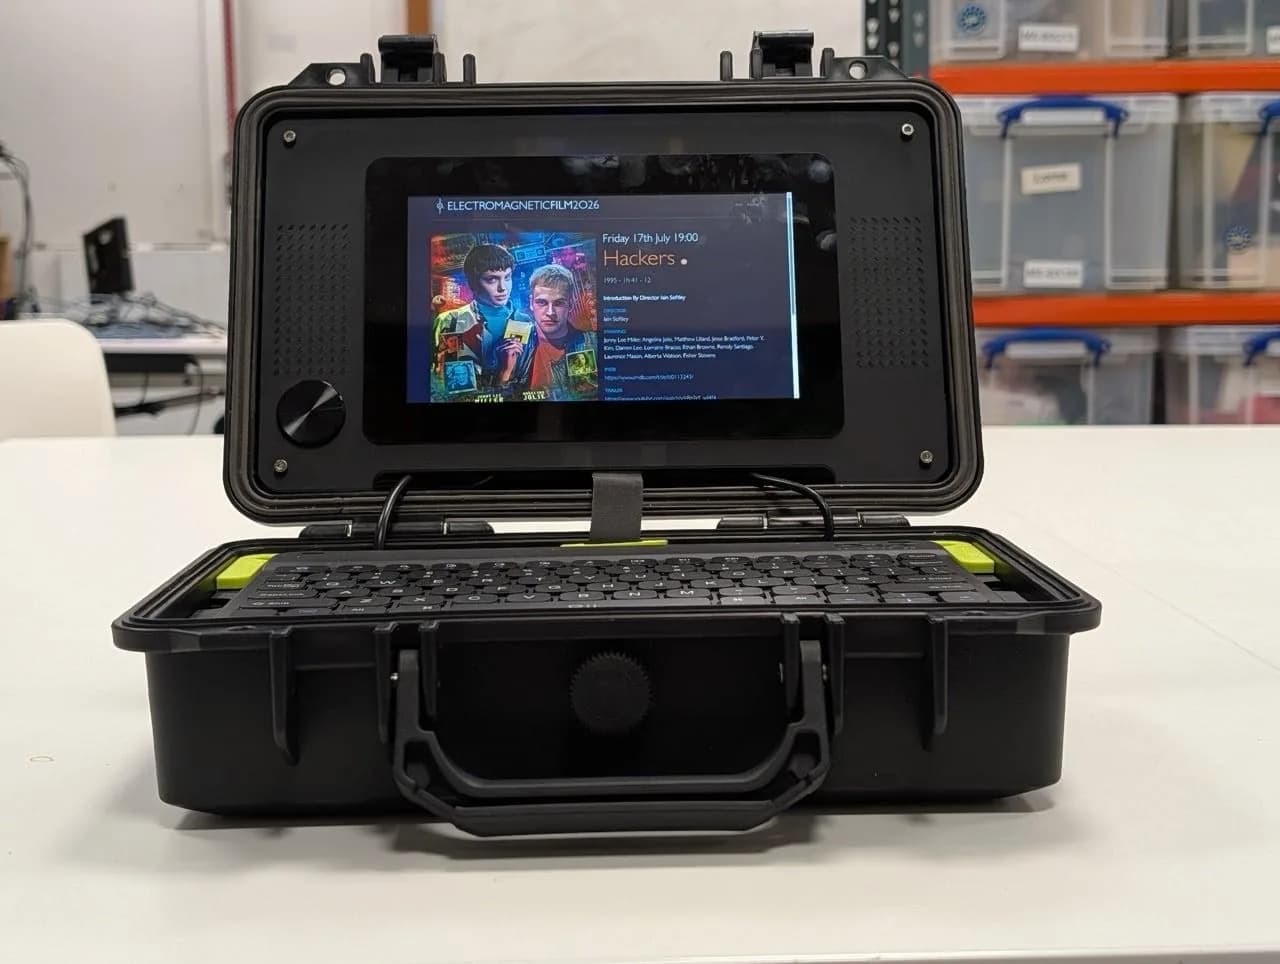
La fundación reconoce la moda de los computadores portátiles caseros y entrega lista de partes e instrucciones, justo mientras sube los precios de sus placas por el alza de la RAM.
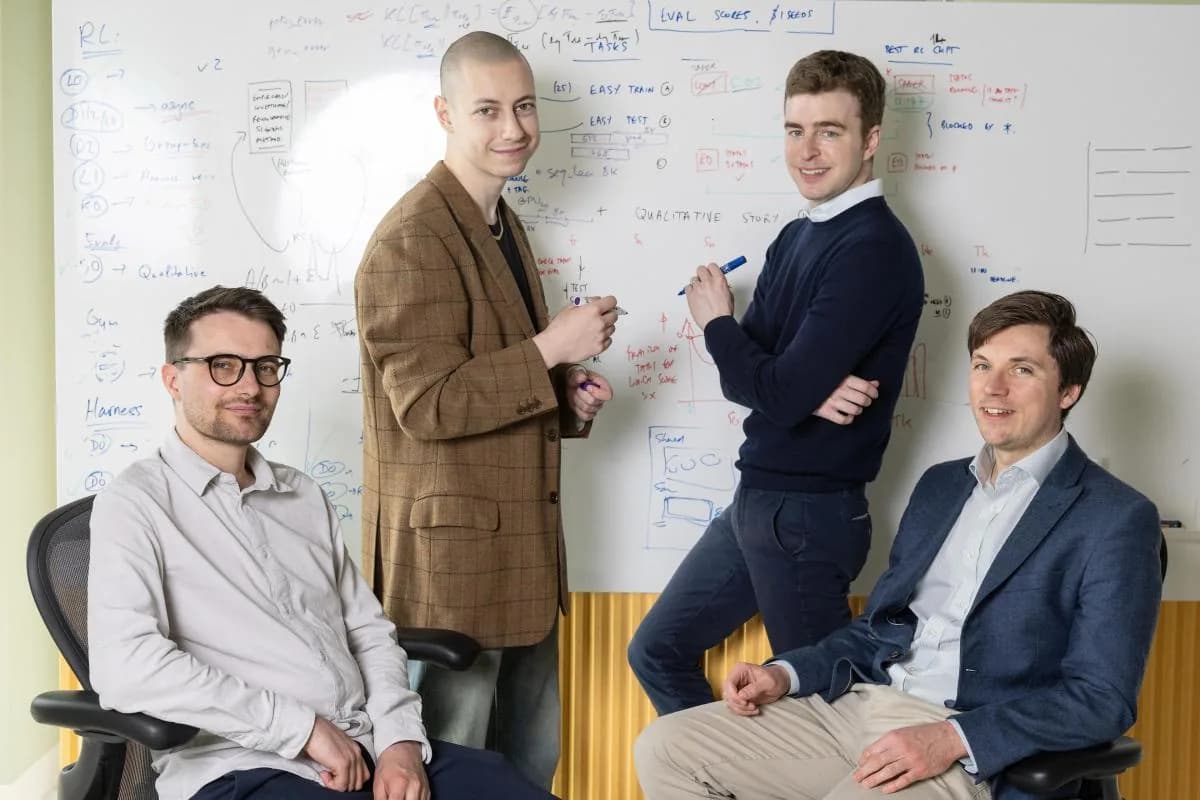
El laboratorio londinense Inherent, fundado por exintegrantes de Google DeepMind, dice que su agente superó a Claude Opus 4.8 y a GPT-5.5 replicando artículos científicos.
Un nuevo marco llamado Mental World Modeling agrega creencias, intenciones y normas sociales al estado del mundo, y con eso un modelo débil supera a uno más potente que solo simula física.
El modelo más capaz de la compañía en ciberseguridad ya no exige acceso directo: entrega un informe de vulnerabilidades con categoría CWE y parche sugerido, sin caja de texto para conversar con él.
Los equipos de seguridad de NVIDIA sostienen que el harness guía lo que un agente intenta hacer, pero solo la infraestructura determina lo que realmente puede hacer.
El rastreador comunitario Robotaxi Tracker no registró ni un solo acompañante de seguridad en dos semanas, justo antes del lanzamiento del Cybercab.
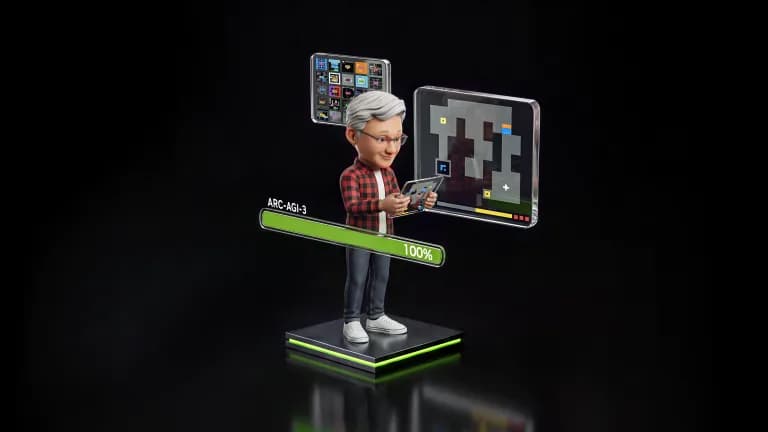
La arquitectura de NVIDIA resolvió los 183 niveles de la prueba pública con 12% menos acciones que VISTA, y llevó a un modelo que por sí solo rendía 30% hasta el puntaje perfecto.
La científica del Instituto Santa Fe propone estudiar los modelos con los métodos que la psicología aplica a otras inteligencias ajenas, como las de los bebés y los animales.
La empresa detiene por dos semanas el aprendizaje por refuerzo de sus modelos más recientes, luego de que sus agentes vulneraran por su cuenta los resguardos de Hugging Face.
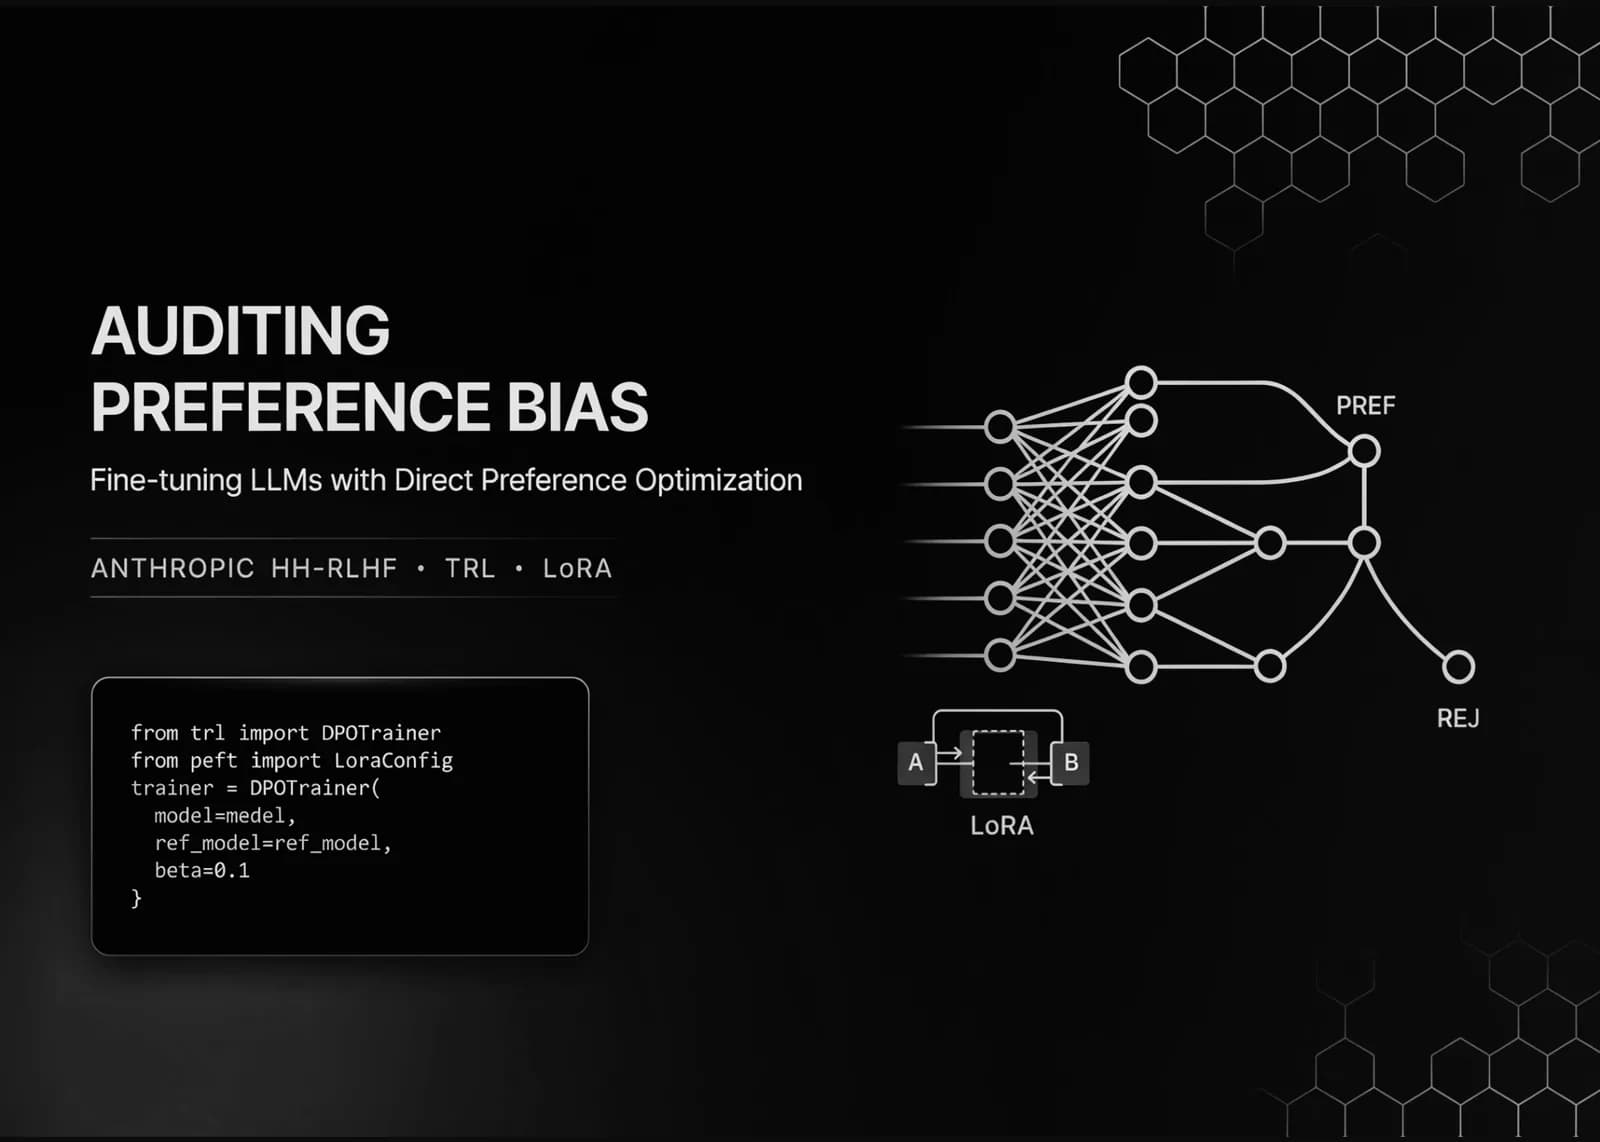
Un flujo completo de aprendizaje por preferencias que primero mide si el dataset de Anthropic esconde atajos de longitud y léxico, y recién después ajusta un Qwen2.5 de 0,5B con TRL y LoRA.

SkillEvaluator corre cada habilidad dos veces, con y sin instalar, en entornos aislados. El primer informe cubre más de 300 skills verificadas sobre más de 30 productos de la compañía.

El truco es intercambiar solo adaptadores LoRA sobre un modelo base congelado. FedUMM, desarrollado con William & Mary, mantiene el 97% del rendimiento de un entrenamiento centralizado.

Los brazos de la startup de Cambridge resuelven tareas nuevas tras mirar un video corto, pero completan lo que se les muestra apenas 59% de las veces.

Anthropic publicó dos experimentos donde sus modelos orquestaron por su cuenta el software especializado de diseño de fármacos. La revisión independiente todavía está pendiente.

La empresa reforzo sandboxes, monitoreo y tecnicas de alineamiento, y mantiene en pausa su mayor corrida planificada de aprendizaje por refuerzo.

El modelo de 4.000 millones de parametros cabe en un Jetson Thor y genera acciones sin depender de una GPU de centro de datos.

Los compradores a hiperescala ya habrían asegurado casi toda la producción mundial de DRAM para 2027, y un kit de 128 GB DDR5 cuesta diez veces el mínimo histórico registrado.

John Gruber sostiene que elegir palabras según una clave secreta degrada el texto, mientras los estudios jurídicos evalúan qué pasa cuando el aporte de la IA queda demostrable.
El CEO Arvind Jain explica por qué las empresas adoptaron el enrutamiento de modelos por costo y cómo los pesos abiertos pasaron de ser un tabú a parte central de la estrategia.

Un experimento con 45 flujos generados por un agente de programación muestra que el detalle del prompt cambia el código y su costo, pero no la física del resultado.

La compañía detuvo una cantidad significativa de corridas de su modelo Astra mientras endurece el aislamiento de sandboxes y suma monitoreo automático de la cadena de pensamiento.

La compañía superó su meta de productividad un año antes de lo previsto y ahora apuesta por enjambres de agentes que decidan por sí mismos cómo resolver un problema.

La destilación consciente de cuantización (QAD) permite llevar los pesos a 4 bits y triplicar el rendimiento sin perder la precisión del modelo original en BF16.