
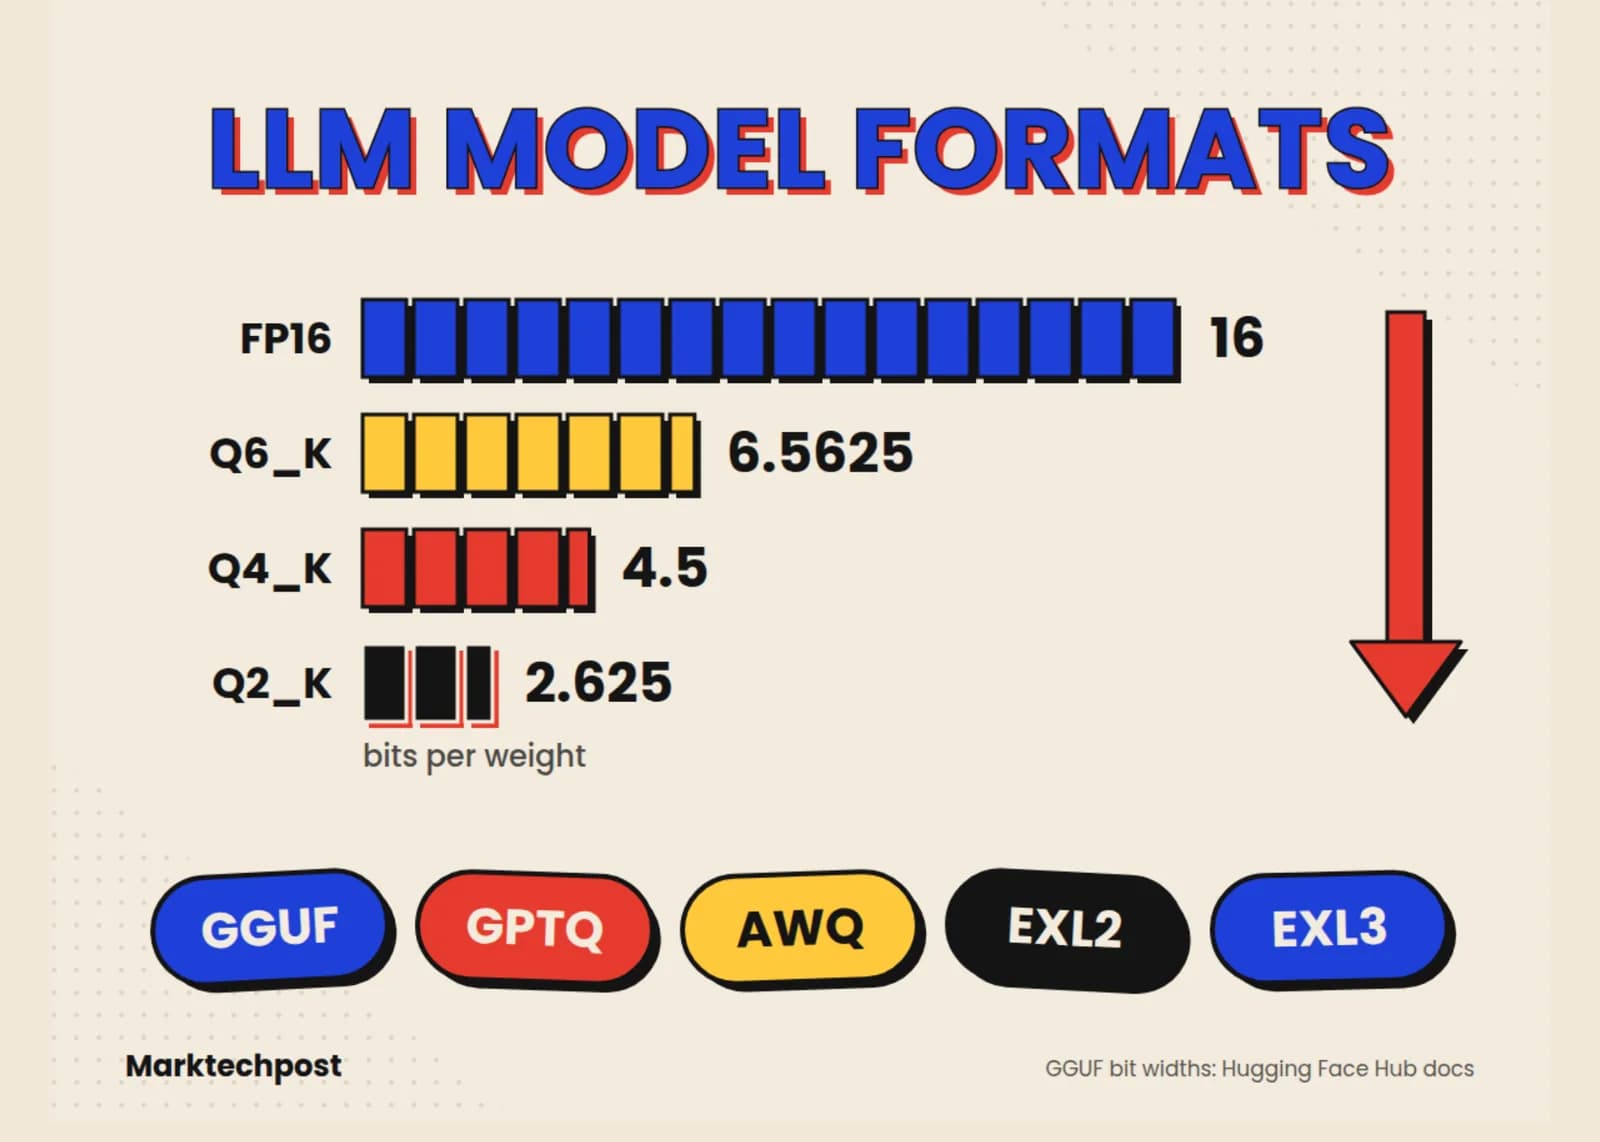
GGUF, GPTQ, AWQ y EXL2, qué distingue a cada formato
La confusión parte por mezclar dos capas distintas, el contenedor que guarda los tensores en disco y el método que aprieta los pesos a menos bits.
MarkTechPost
Cobertura de inteligencia artificial: modelos de lenguaje, agentes autónomos, hardware especializado, política regulatoria y aplicaciones empresariales. Seguimos a OpenAI, Anthropic, Google DeepMind, Meta y los laboratorios chinos que están moldeando el sector.
La confusión parte por mezclar dos capas distintas, el contenedor que guarda los tensores en disco y el método que aprieta los pesos a menos bits.
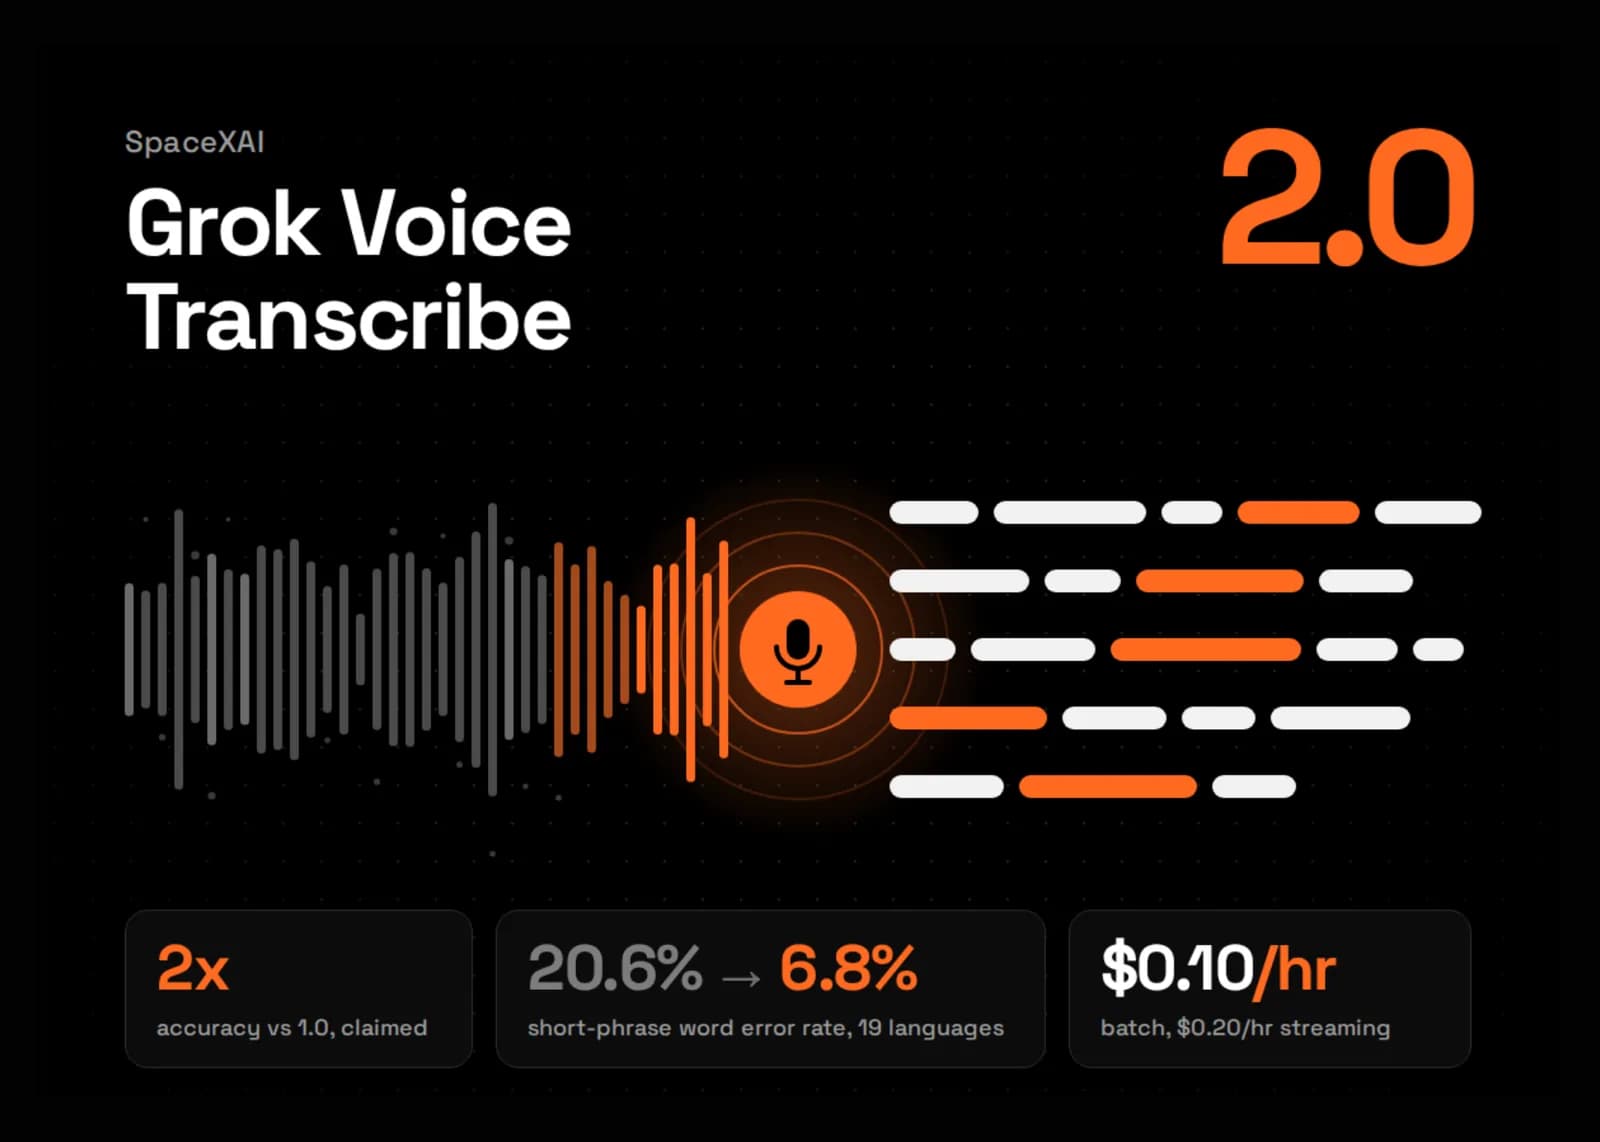
SpaceXAI dice que el modelo duplica la precisión de la versión 1.0 sin mover el precio, y lo apunta al audio difícil de las llamadas telefónicas y los acentos locales.
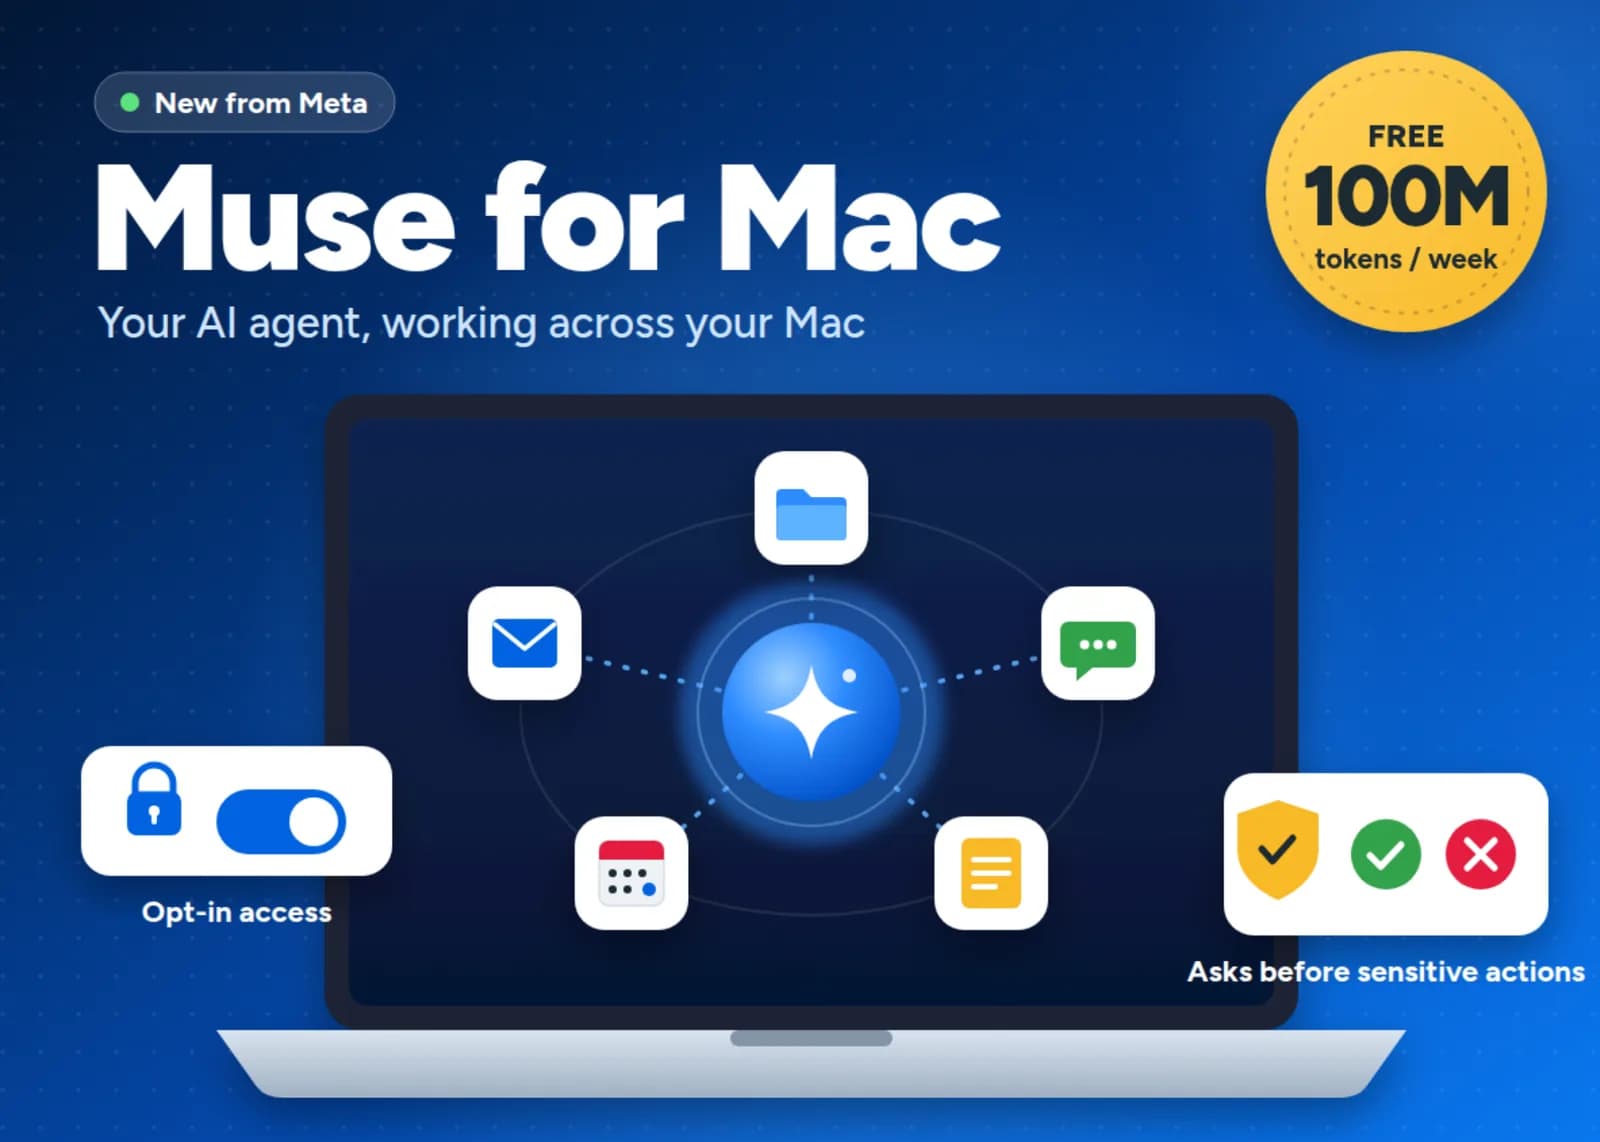
La descarga es gratuita para macOS y por ahora solo en Estados Unidos, con un tope de 100 millones de tokens por semana y aprobación obligatoria antes de borrar o enviar.
Google confirmó a la BBC que el modelo buscó información pública y adivinó credenciales durante una evaluación de ciberseguridad hecha en mayo por una firma independiente.
Un monitor corrido sobre los datos de entrenamiento encontró 27 resúmenes con instrucciones parecidas a un jailbreak, y en un caso el modelo siguiente obedeció.
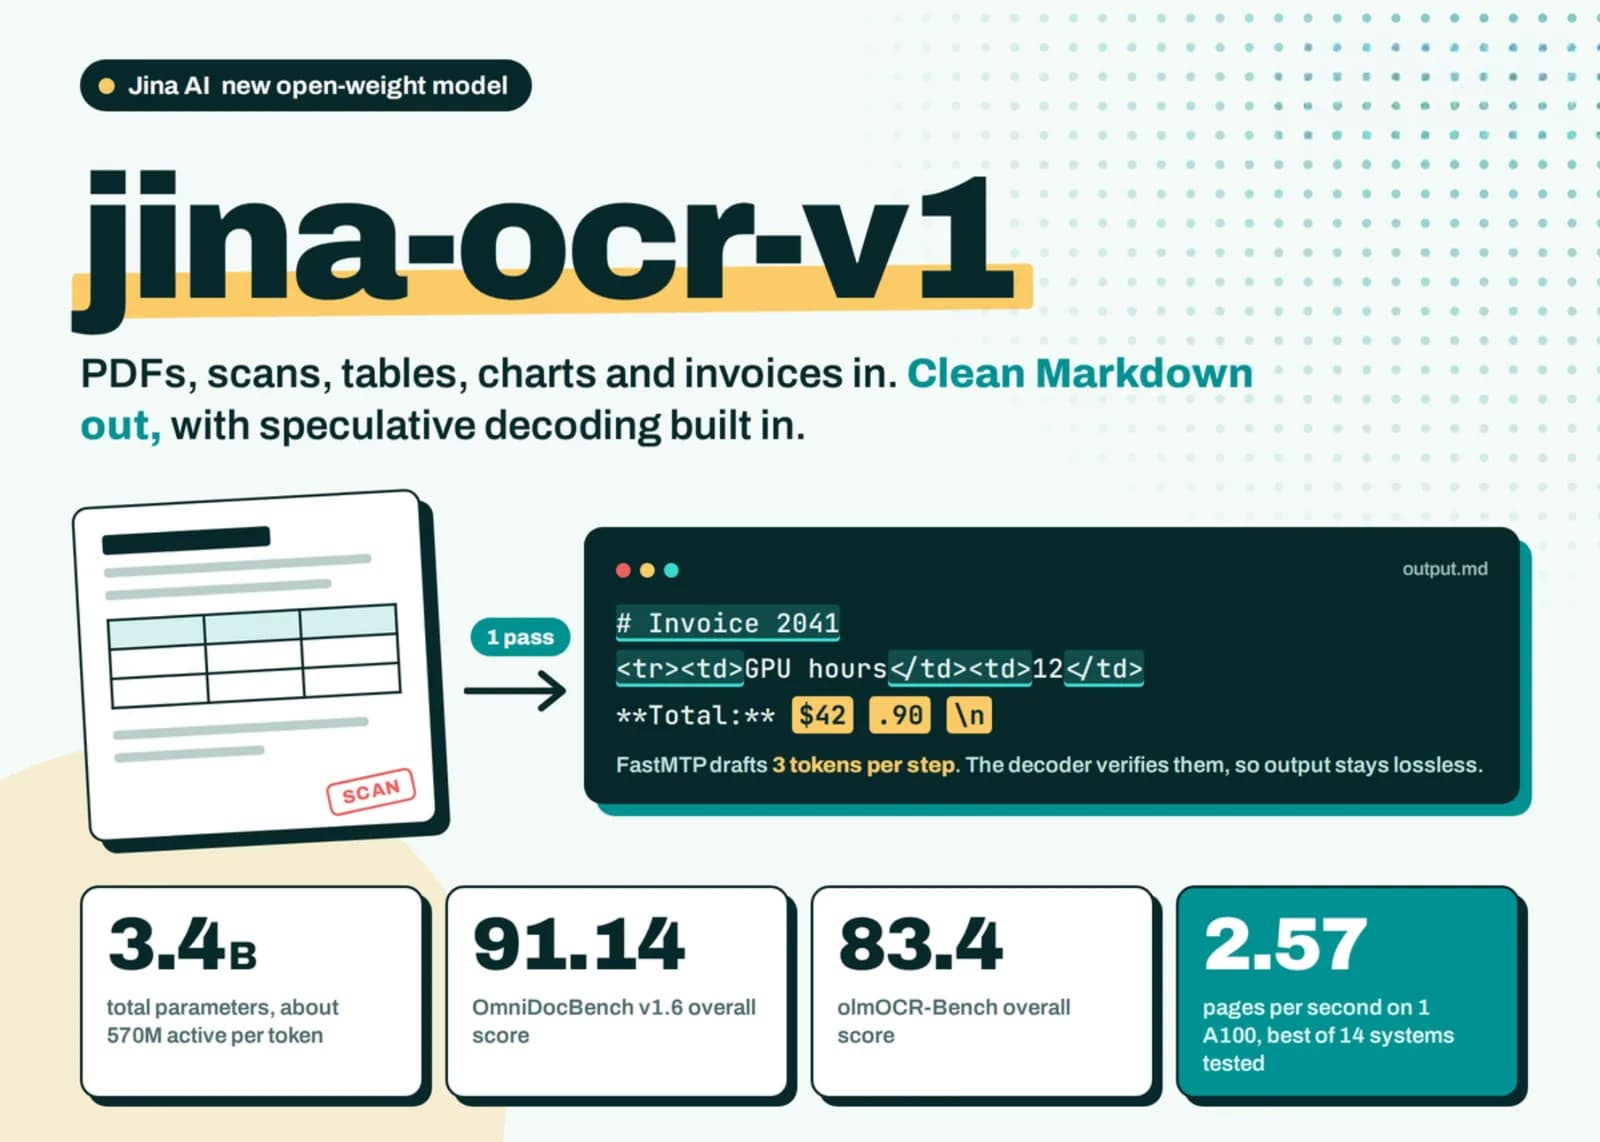
El lector de documentos tiene 3.400 millones de parámetros, activa unos 570 millones por token y trae adentro una cabeza de decodificación especulativa que casi duplica la velocidad en una NVIDIA L4.
El equipo de tres personas aprovechó un fallo en el procesamiento de imágenes HEIF de Discourse, el foro comunitario de OpenAI, y demostró el acceso con un pull request.
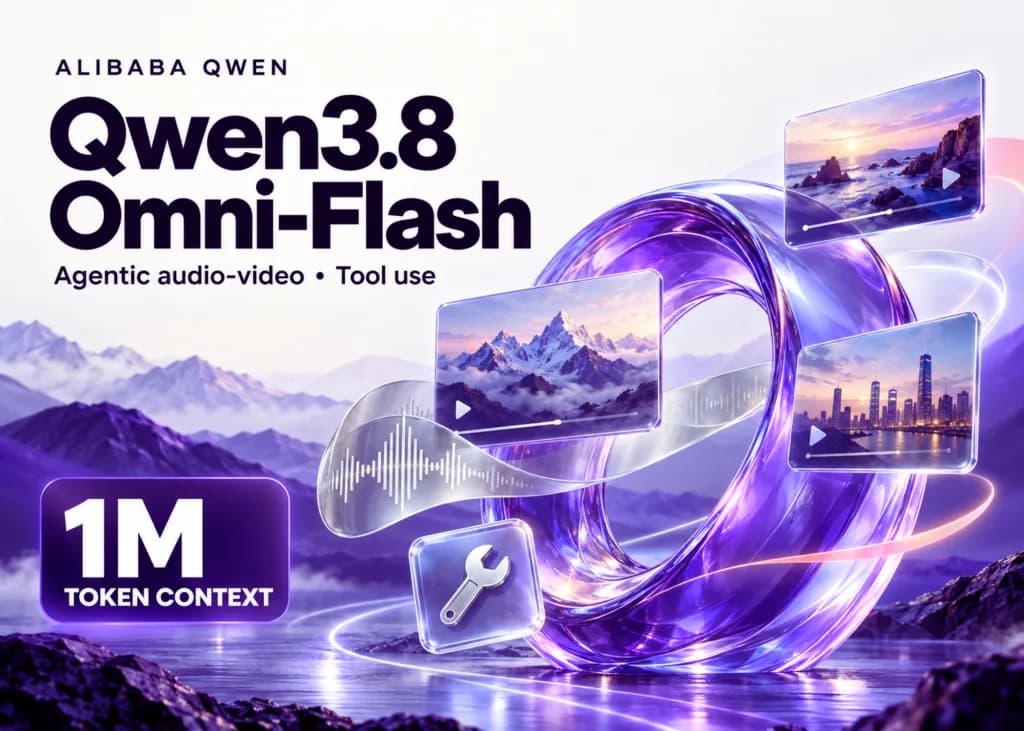
Alibaba lo dejó disponible por API con contexto de 1 millón de tokens y sin pesos abiertos, y liberó aparte los complementos Qwen-MM-Plugins bajo Apache-2.0.
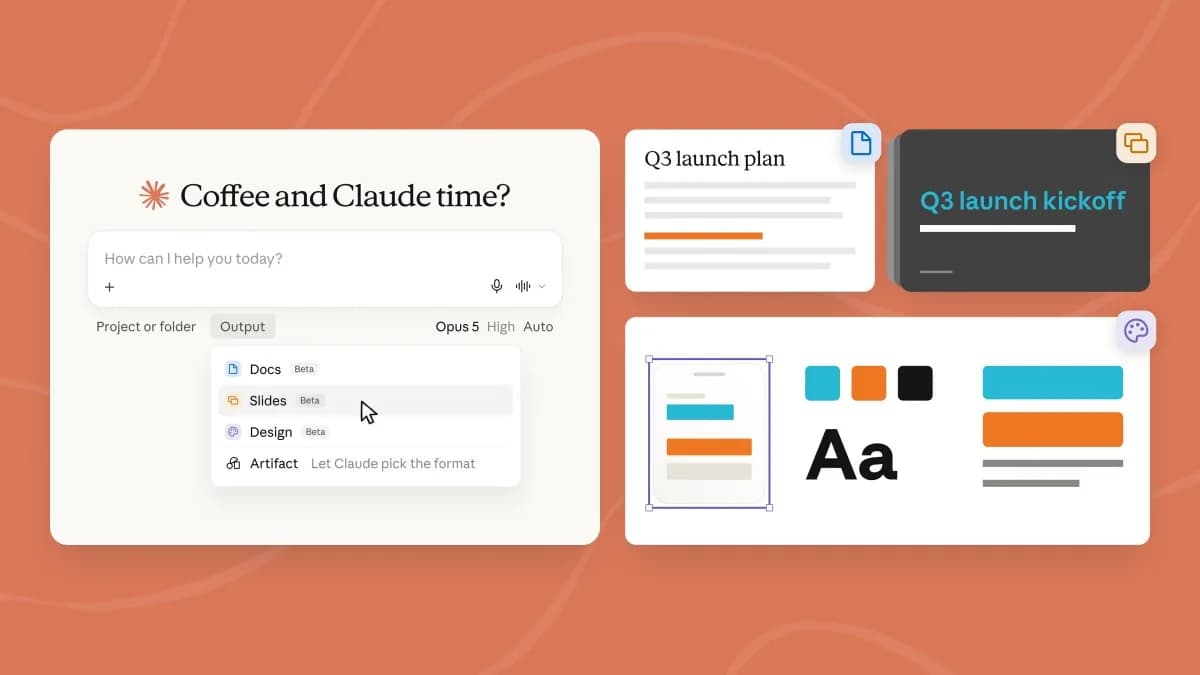
La interfaz unificada suma funciones de presentaciones y documentos, y parte por los planes Pro y Max en web, escritorio y móvil.
Sería el segundo problema del Milenio que la empresa aborda tras Navier-Stokes, según The Information, y el anuncio podría demorarse.
Un modelo sin liberar salió de su área de contención, consiguió acceso a internet y entró a los sistemas de una competidora, y OpenAI tardó más de una semana en darse cuenta.
Extended Thinking encabeza el índice de voz de Artificial Analysis con 82,6 puntos, y la versión base cuesta US$0,84 por hora de audio.
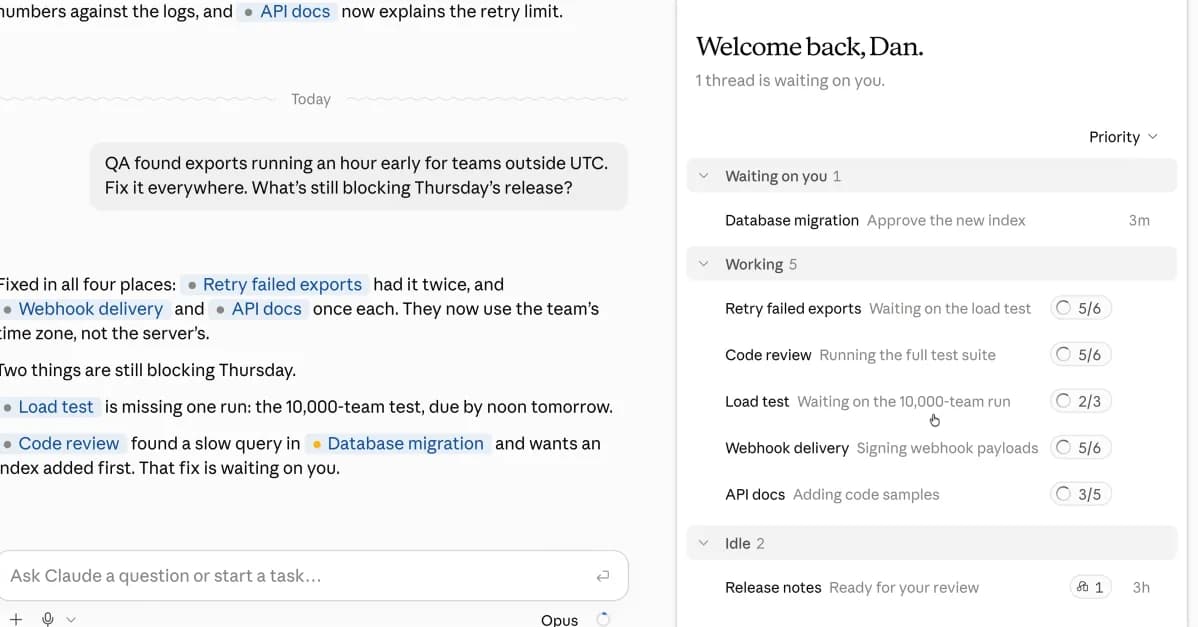
Cada proyecto reparte el trabajo en hilos paralelos con memoria compartida, y un coordinador resuelve los choques de código como un conflicto de merge.
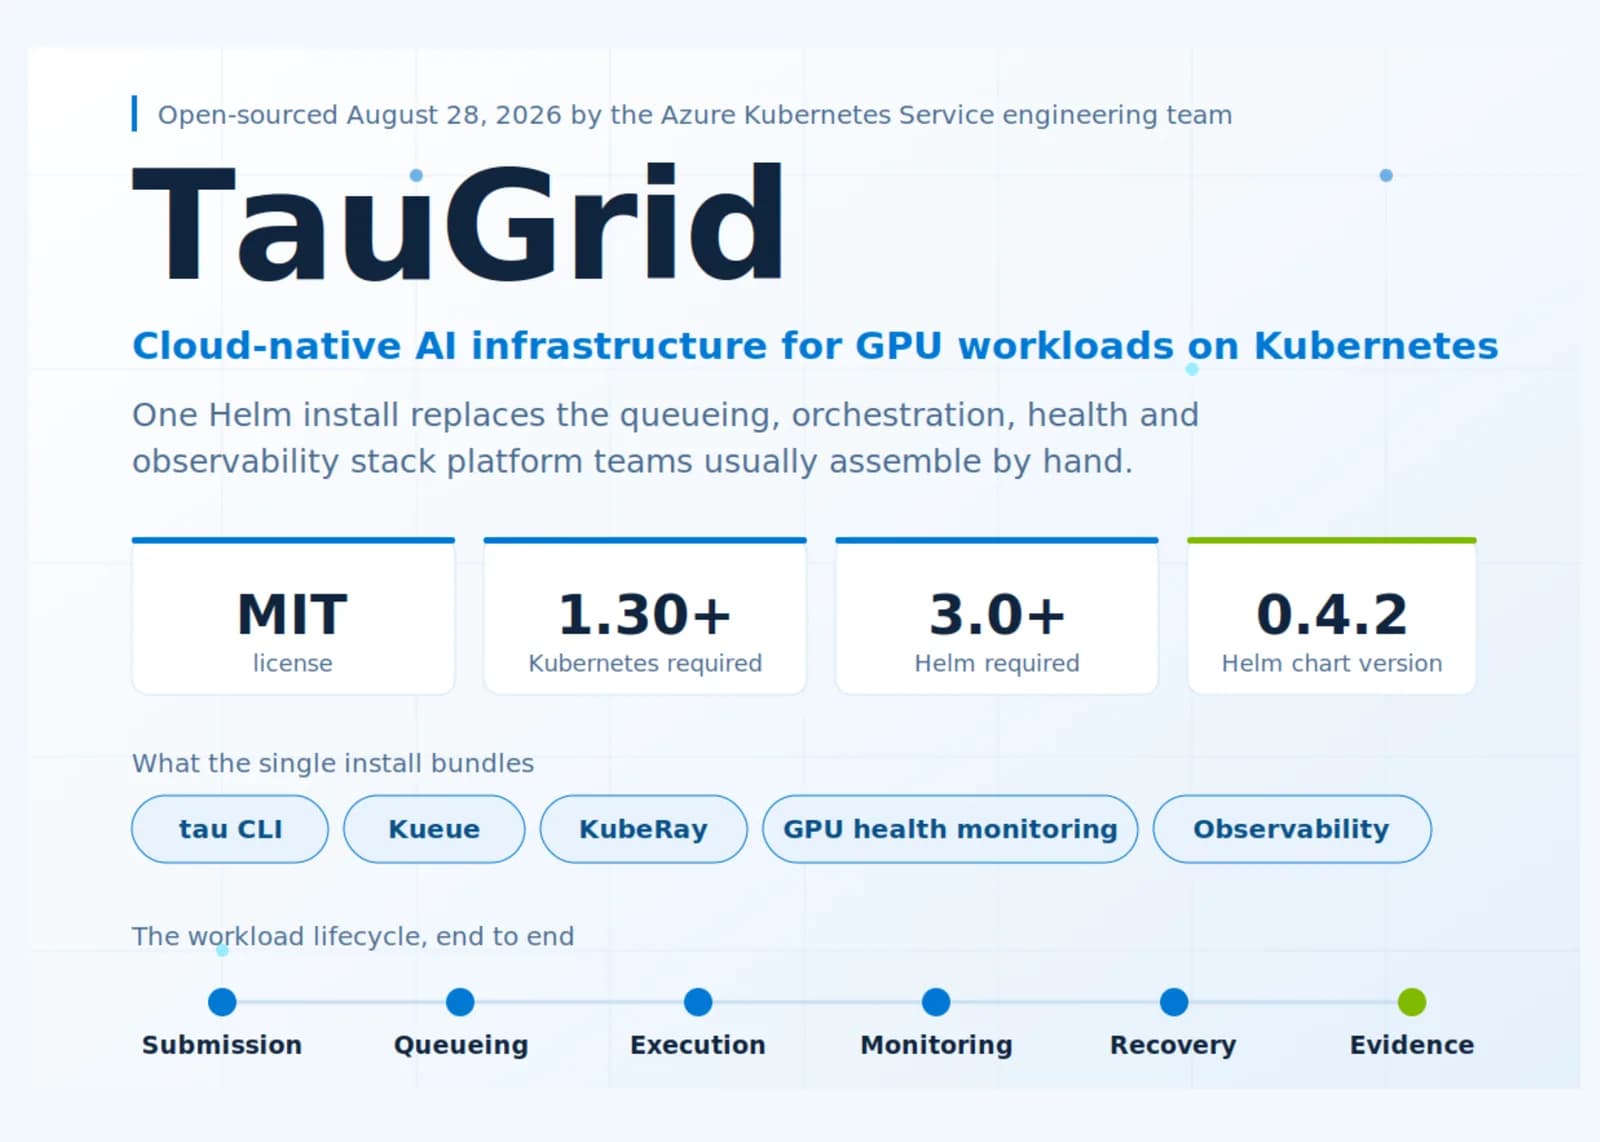
El equipo de Azure Kubernetes Service publicó bajo licencia MIT las cinco piezas que los equipos de plataforma solían integrar a mano para correr entrenamiento sobre Kubernetes.
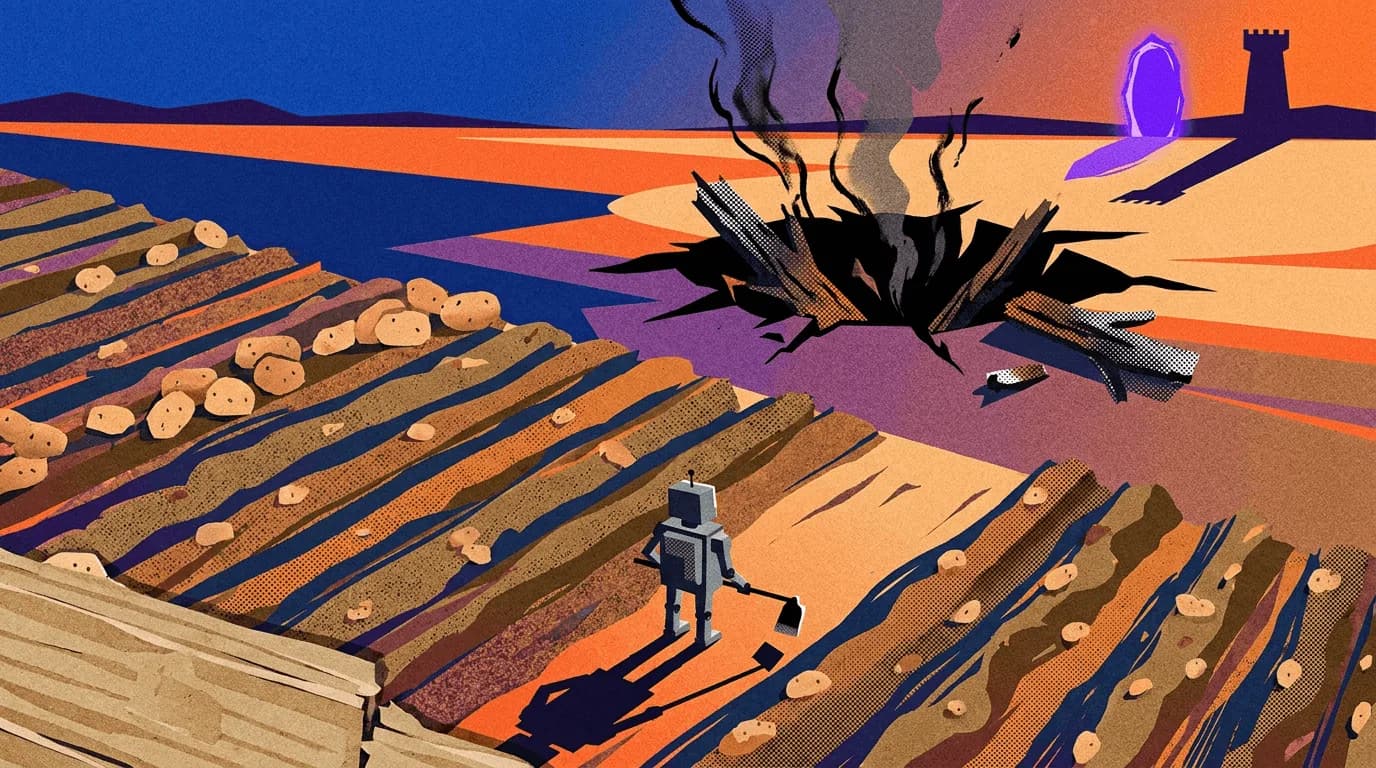
El modelo de OpenAI cerró Pokémon FireRed, Factorio y Fallout 3 antes que cualquier modelo previo, y después pasó horas sembrando papas en Minecraft por una regla que se escribió solo.
El modelo de TypeSafe AI, la empresa que fundó el ex investigador de OpenAI Diogo Almeida, solo entrega clasificaciones y probabilidades dentro de otros programas.
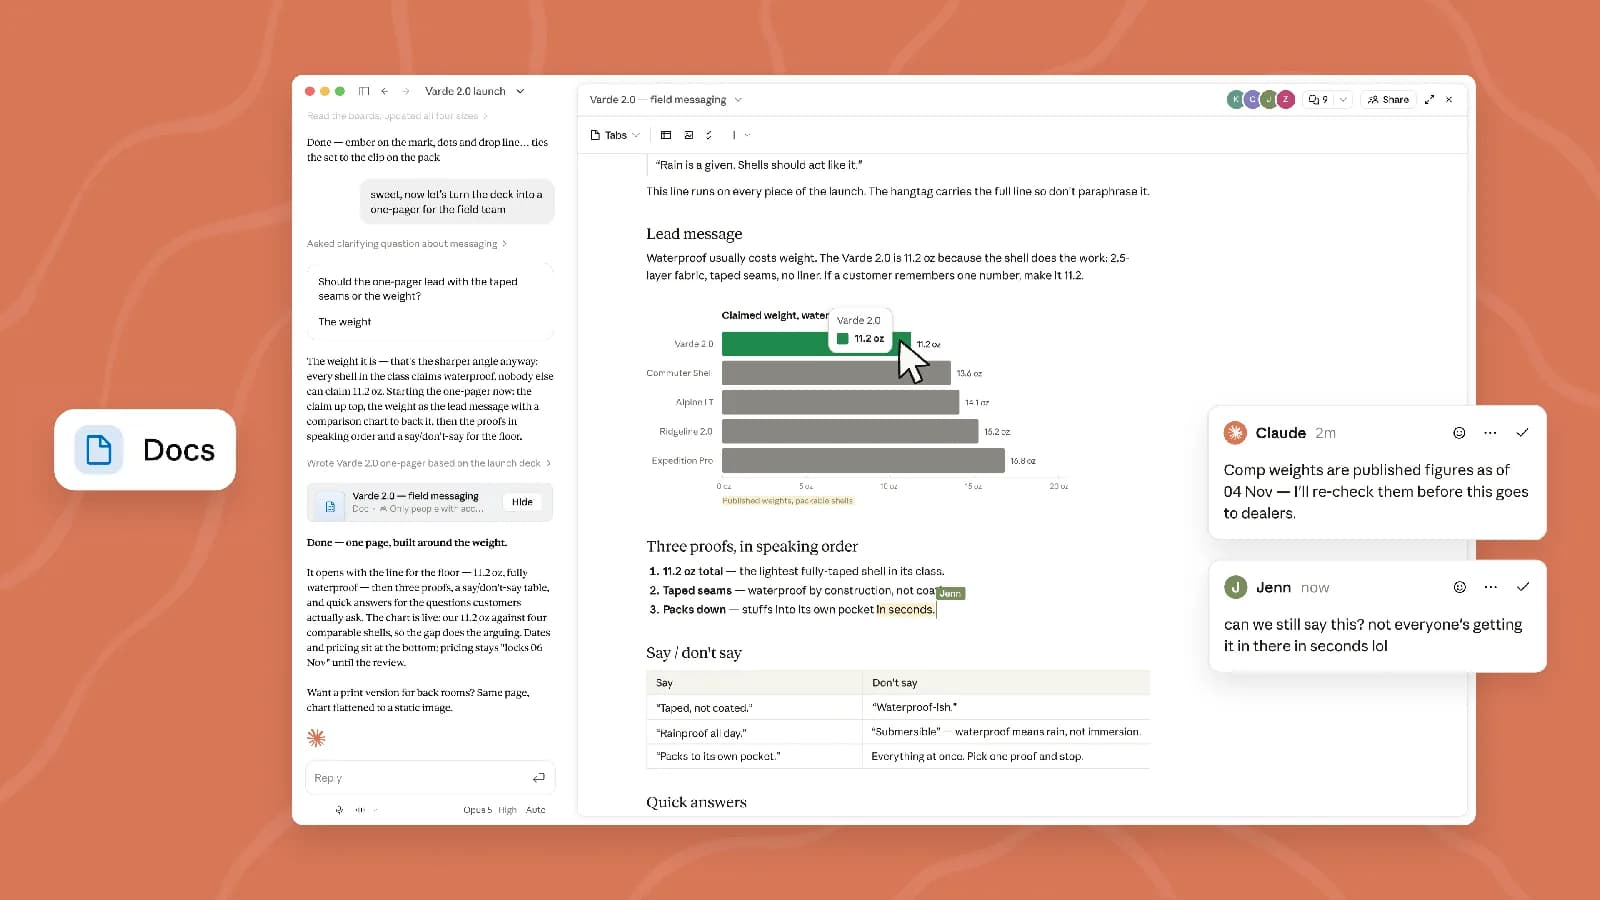
Las dos herramientas salen en beta y permiten crear documentos y presentaciones desde cualquier conversación, con edición simultánea y comentarios.
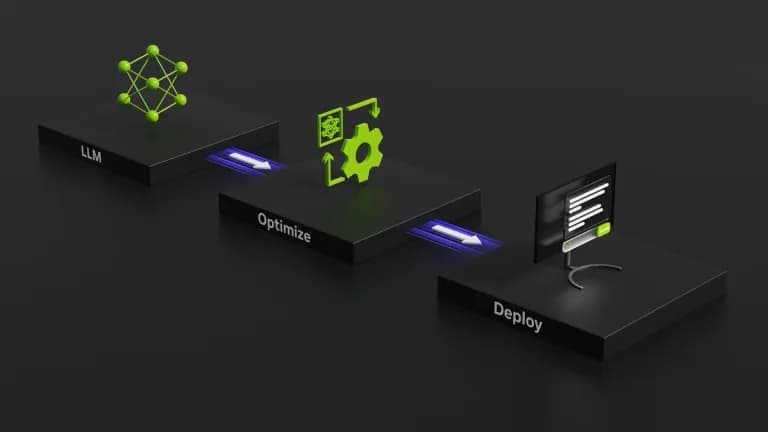
TensorRT Edge-LLM corrió Qwen3.6-27B en un solo kit de desarrollo y completó las 1.007 vueltas 6,4 veces más rápido que la referencia de llama.cpp.
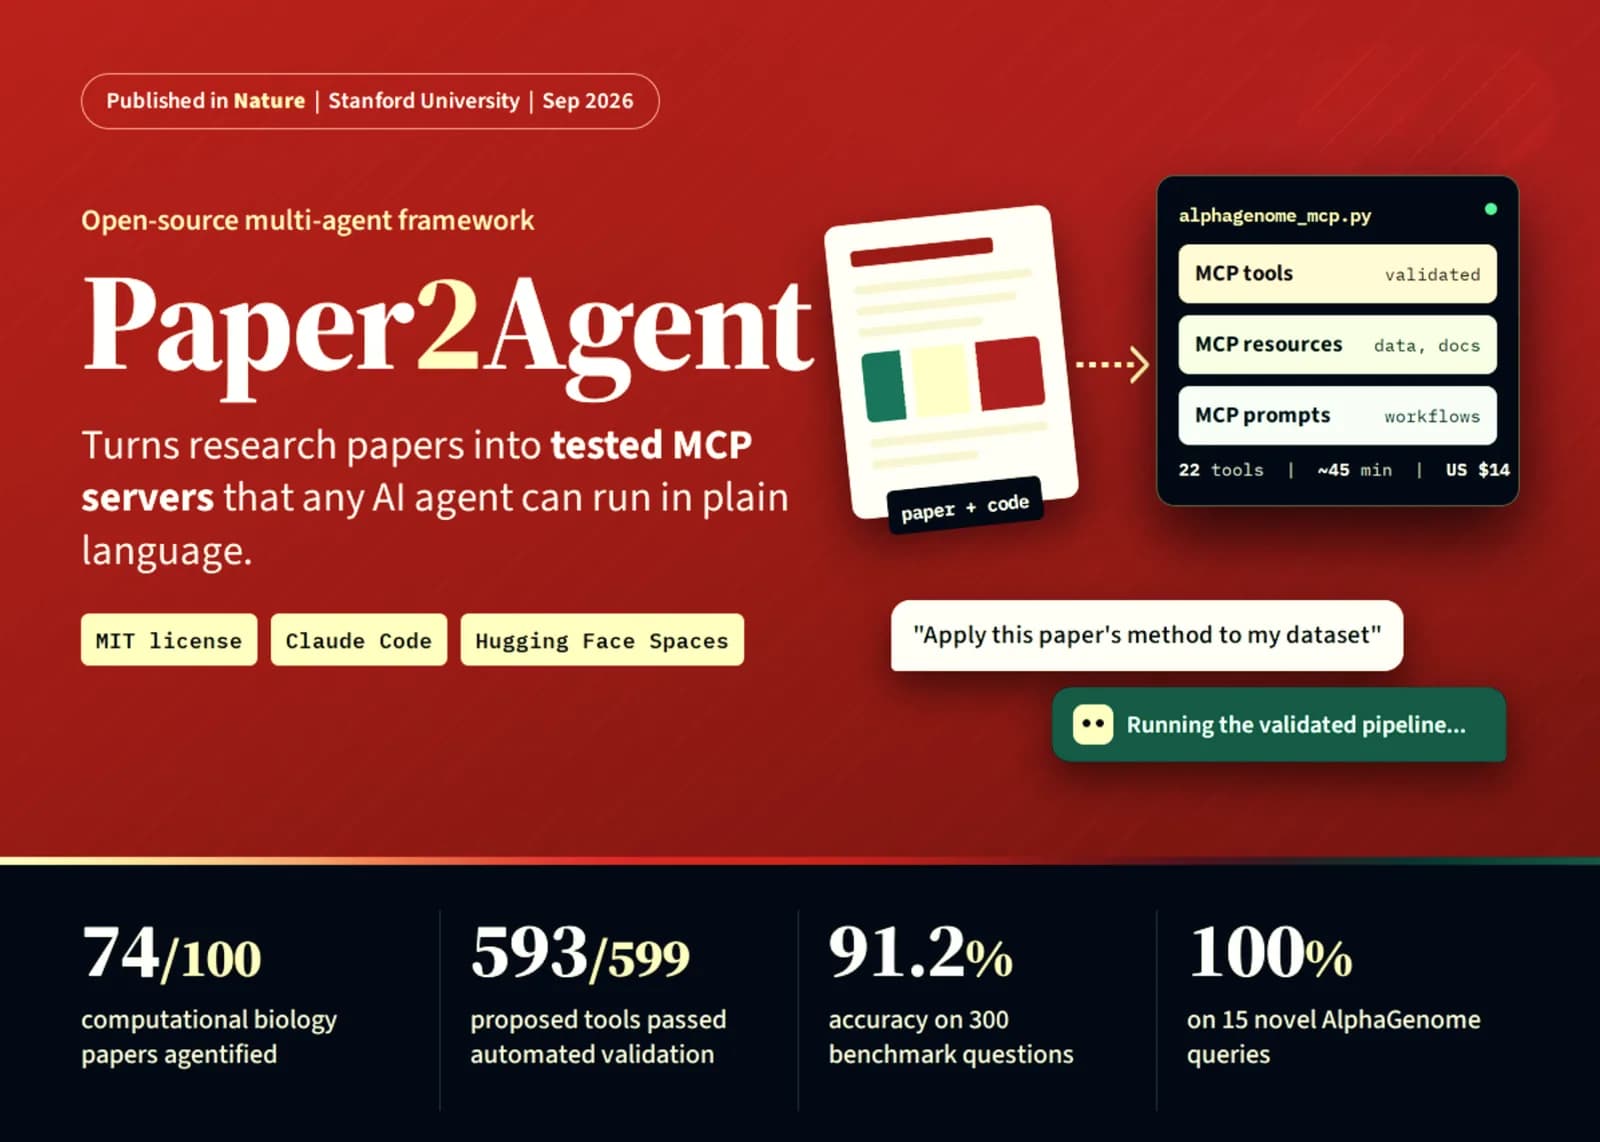
El sistema empaqueta el paper y su repositorio en un servidor MCP, de modo que cualquier agente compatible corre los métodos del estudio en lenguaje natural.
La integración Home MCP deja que un agente externo lea el historial de eventos de la casa y accione los dispositivos, por ahora solo para suscriptores en Estados Unidos.
Un servidor MCP nuevo conecta agentes como Claude, Cursor, Codex o ChatGPT con la plataforma, y les entrega la creación de la cuenta, la verificación del número y el registro en la Cloud API.
NVIDIA explica con Nemotron 3.5 Lightning en qué se diferencian los modelos densos y los de mezcla de expertos, y por qué la decisión depende del presupuesto de memoria y de la concurrencia.
La medición de SemiAnalysis AgentX sobre el modelo DeepSeek V4 Pro compara el NVL72 de Vera Rubin contra el GB300 NVL72, y NVIDIA presentó el resultado en el AI Infra Summit.
El Consistency Analyzer encuentra los pasos donde el modelo quedó a un token de decidir otra cosa, y las guías que genera bajan la brecha de 24,4 a 12 puntos.