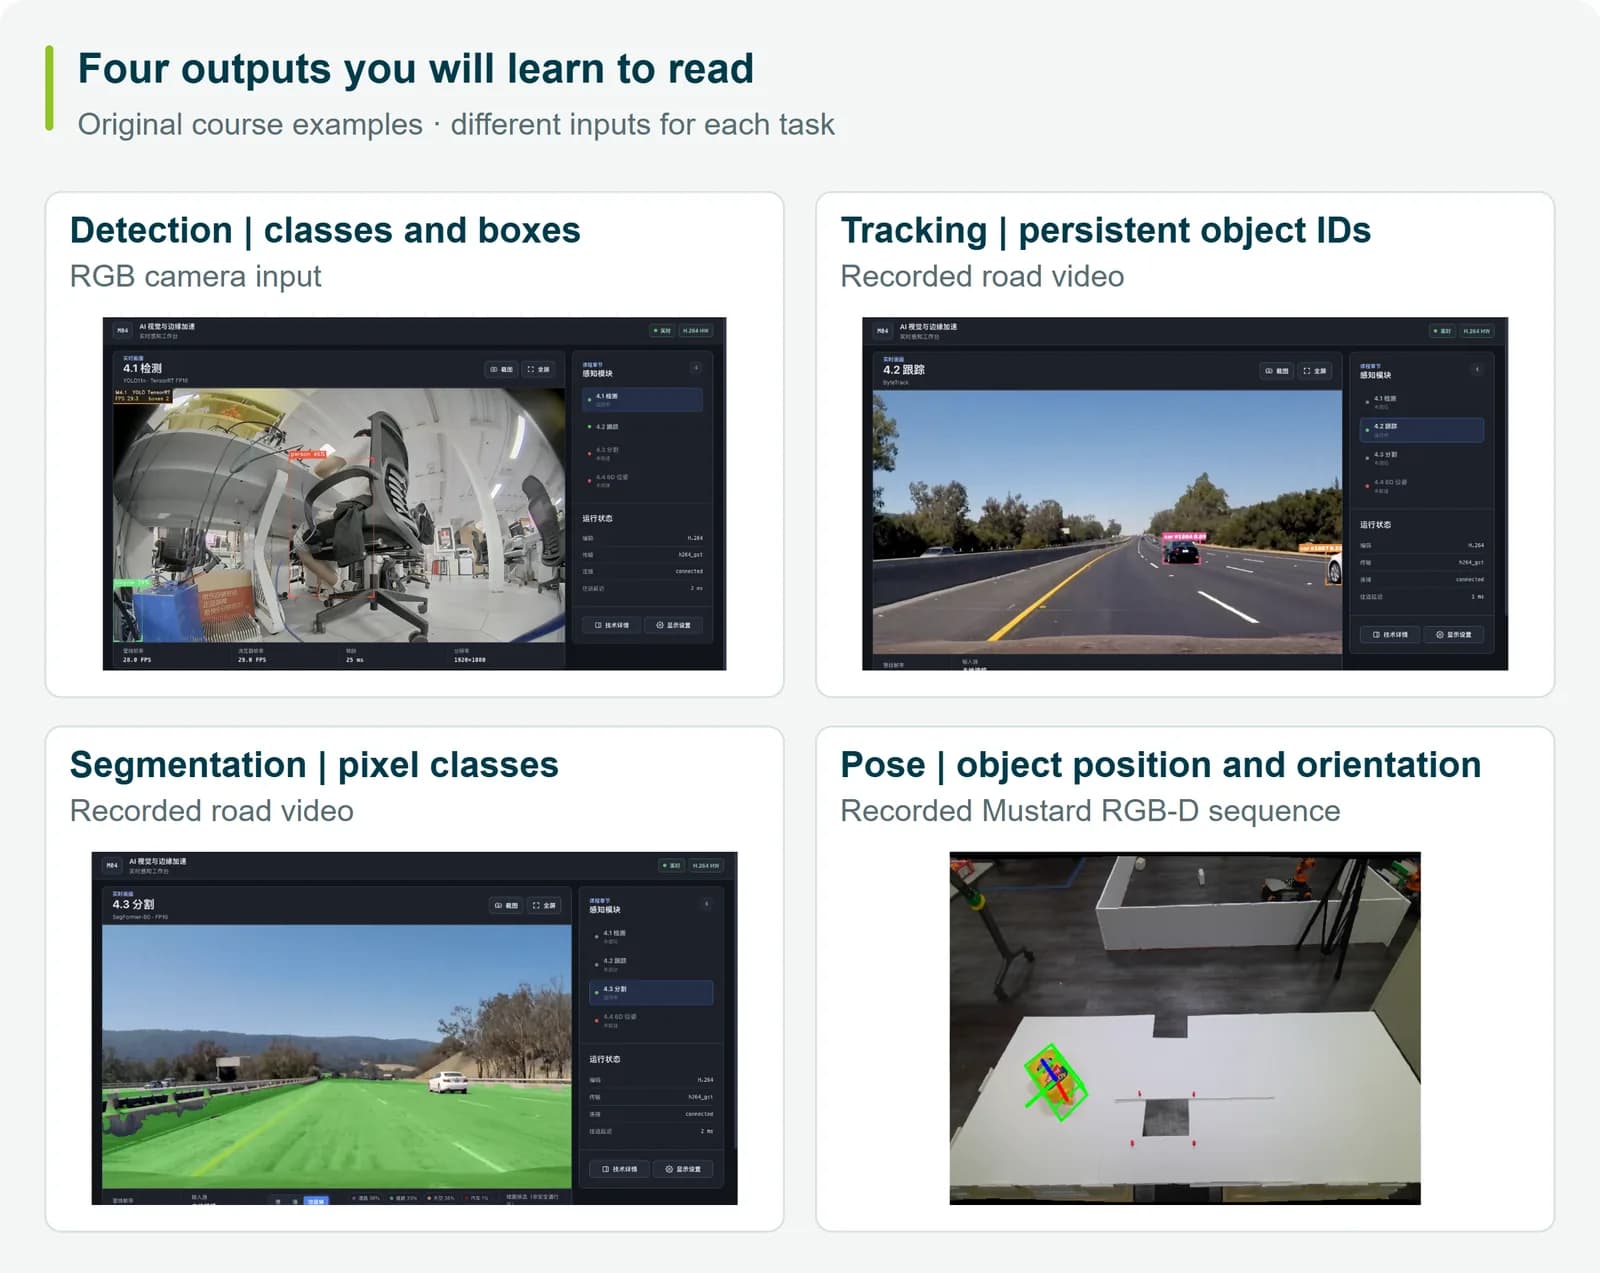
Seeed Studio publicó el 11 de noviembre la cuarta parte de su curso de desarrollo completo de un robot móvil, esta vez sobre visión por IA. El módulo recorre la detección de objetos, el seguimiento de varios objetos, la segmentación semántica y la estimación de pose 6D en una NVIDIA Jetson con ROS 2.
La tercera parte explicó cómo un robot estima su propio movimiento juntando LiDAR, IMU, odometría de ruedas y GNSS en un flujo de fusión de sensores. Saber cómo se mueve es solo una parte. El robot también tiene que interpretar lo que ven sus cámaras, o sea identificar objetos, mantener su identidad de un cuadro a otro, distinguir regiones relevantes y estimar la pose de los objetos con los que tiene que interactuar.
Un recuadro de detección, un identificador de seguimiento, un mapa de clases por píxel y una pose 6D son información de distinto tipo. Cada uno responde una pregunta distinta, depende de entradas distintas y necesita su propia validación. La guía del módulo 04 sigue los experimentos de percepción en el reComputer Robotics J501 y se concentra en cómo revisar lo que entrega cada modelo y cómo pasarlo a interfaces de ROS 2 que otros componentes del robot puedan usar.
El módulo enseña cuatro cosas.
- Desplegar YOLO11 con TensorRT y verificar los recuadros de detección, las coordenadas y los mensajes de ROS 2.
- Usar ByteTrack para mantener la identidad de los objetos entre cuadros e investigar los cambios de identificador.
- Usar SegFormer para interpretar clases por píxel y derivar una máscara de suelo candidato para una tarea específica.
- Estimar la pose 6D de un objeto conocido a partir de datos RGB-D grabados con FoundationPose, y entender la transformación hacia el marco de referencia del robot.
Ayuda conocer los tópicos de ROS 2, los comandos de terminal y el entorno de desarrollo en Jetson de las partes anteriores. No hace falta correr los cuatro experimentos a la vez, porque cada sección se puede explorar y validar por separado.
Quien llegue recién a la serie puede partir por la introducción del curso, con la ruta completa. También están la parte I, sobre la base de desarrollo con Jetson y ROS 2, la parte II, sobre integración y calibración de cámaras, y la parte III, sobre LiDAR, IMU y fusión de sensores. El repositorio abierto del curso tiene la documentación completa, el código y las actualizaciones.
La guía propone partir por los resultados. Se deja fija la entrada y se aprende a explicar cada resultado antes de sumar otro componente.
¿Qué tarea de percepción necesita el robot?
Un robot que entra a una zona de trabajo puede necesitar identificar objetos cercanos, seguir observando uno mientras se mueve, distinguir el suelo de lo que lo rodea o determinar la posición y la orientación de una pieza conocida. Cada necesidad lleva a una tarea distinta.
- Detección de objetos con YOLO. Predice clases, recuadros 2D y puntajes de confianza a partir de una imagen RGB. El curso despliega el modelo pasando por PyTorch, ONNX y TensorRT, y publica las detecciones como mensajes de ROS 2.
- Seguimiento de varios objetos con ByteTrack. Asocia las detecciones entre cuadros con predicción de movimiento y emparejamiento, y asigna identificadores de seguimiento persistentes.
- Segmentación semántica con SegFormer-B0. Predice una clase para cada píxel y luego selecciona clases configuradas para formar una máscara de suelo candidato.
- Estimación de pose 6D con FoundationPose. Combina RGB-D, los parámetros intrínsecos de la cámara, una máscara de la instancia objetivo y una malla CAD para estimar la traslación y la rotación 3D de un objeto conocido en el marco de la cámara.
Tres caminos de datos separados
Detección y seguimiento forman un solo camino. Las imágenes RGB alimentan a YOLO, sus detecciones van a /perception/detections y ByteTrack produce detecciones identificadas en /perception/tracks.
La segmentación corre por su cuenta sobre imágenes RGB. SegFormer entrega clases por píxel en /perception/semantic_mask, y una regla de selección de clases genera /perception/drivable_mask. Las etiquetas semánticas no identifican instancias individuales de objetos, y que un píxel quede marcado como suelo no prueba que el robot pueda pasar por ahí con seguridad.
La pose del objeto necesita RGB-D y CameraInfo, una máscara de esa instancia en particular y su malla. FoundationPose genera hipótesis de pose, las refina y puntúa a los candidatos. Un recuadro de detección o una máscara de clase semántica no reemplazan a esa máscara de instancia. La pose que sale, expresada en el marco de la cámara, necesita una transformación de coordenadas antes de usarse en el marco base del robot.
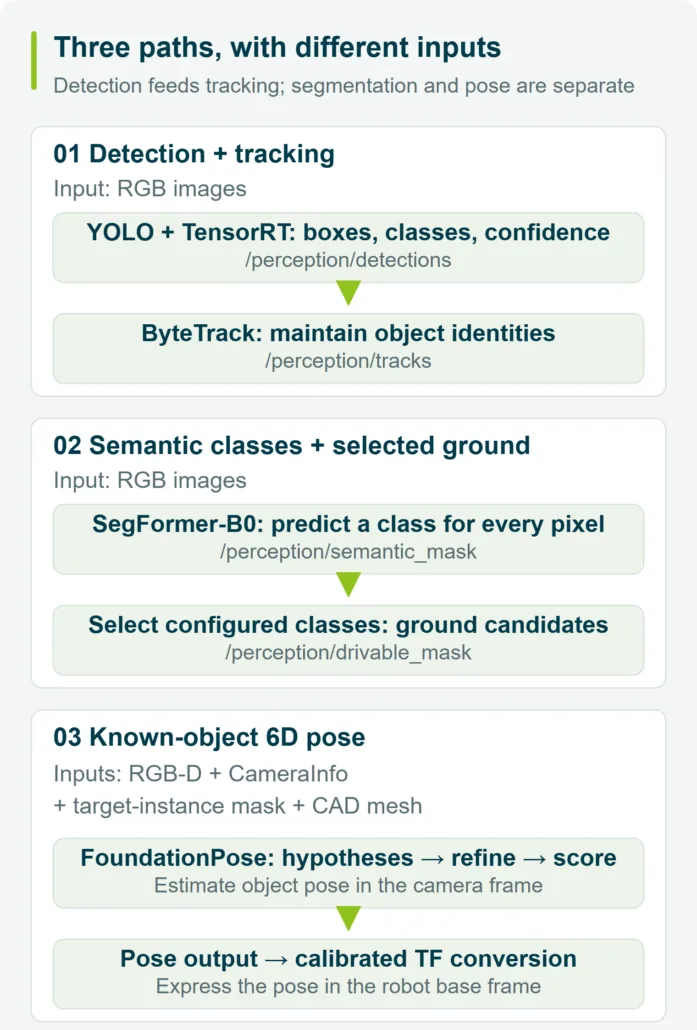
El curso ofrece dos implementaciones de la tarea de pose, NVIDIA Isaac ROS FoundationPose en el M4.4 y FoundationPose nativo de NVlabs en el M4.5. Son dos rutas de ingeniería distintas, no modelos consecutivos de un mismo flujo.
La plataforma Jetson y las entradas
La plataforma de referencia del curso es el reComputer Robotics J501 de Seeed con una NVIDIA Jetson AGX Orin de 32 GB. La guía pide replicar su entorno documentado antes de cambiar versiones.
La cámara GMSL frontal entrega imágenes por /dev/video0. Los ejercicios de pose usan además datos RGB-D grabados, porque conectar una cámara RGB-D en vivo agrega trabajo de alineación y sincronización. Las vistas previas del curso usan entradas distintas para cada tarea, detección en interiores, video de carretera grabado para seguimiento y segmentación, y la secuencia RGB-D Mustard para la pose.
Antes de lanzar un ejercicio hay que instalar dependencias, compilar el espacio de trabajo y preparar los modelos. El repositorio no trae todos los pesos, motores ni mallas. Las instrucciones de instalación vigentes y los enlaces de cada lección están reunidos en la navegación del curso.
Hecho eso, se fija la ruta del directorio de código de la copia local. Cada terminal nueva de inspección necesita además cargar los entornos de ROS y del espacio de trabajo.
export M4_CODE_ROOT="$HOME/mobile-robot-full-stack-course/docs/M04-AI-Vision-And-Edge-Acceleration/code"
cd "$M4_CODE_ROOT"
source /opt/ros/humble/setup.bash
source "$M4_CODE_ROOT/ros2_ws/install/setup.bash"
Para comparar parámetros, la guía pide dejar fijos la entrada, la resolución, el modelo y la configuración. Se cambia un ajuste a la vez, para que una escena nueva o una geometría de cámara distinta no tape el efecto.
¿Cómo se despliega YOLO con TensorRT?
Entender los candidatos antes de filtrarlos
La exportación de YOLO11n entrenada en COCO que usa el curso recibe una imagen de 640 × 640 y devuelve [1, 84, 8400]. Eso es un lote, cuatro valores de recuadro más 80 puntajes de clase, y 8.400 ubicaciones candidatas que salen de 80×80 + 40×40 + 20×20. Otros modelos y modos de exportación pueden usar contratos de salida distintos.
El posprocesamiento lee los puntajes de clase y las coordenadas de los recuadros, filtra los candidatos de baja confianza, aplica supresión de no máximos (NMS) por clase y devuelve los recuadros a la imagen original. La confianza decide qué predicciones sobreviven y el umbral de IoU del NMS controla la supresión de duplicados. Una confianza de 0,8 no equivale a una precisión medida de 80%.
Con yolo11n.pt y las dependencias listas, se exporta el modelo y se construye el motor.
yolo export model=yolo11n.pt format=onnx simplify=True dynamic=False
python3 -c "import onnx; onnx.checker.check_model(onnx.load('yolo11n.onnx'))"
/usr/src/tensorrt/bin/trtexec \
  --onnx=yolo11n.onnx \
  --saveEngine=yolo11n_fp16.engine \
  --fp16 --memPoolSize=workspace:4096
Estos pasos exportan un grafo estático, revisan su estructura y construyen un motor FP16 para el entorno con TensorRT 10.3 del curso. No reentrenan el detector. El motor y las etiquetas se ubican según la configuración del nodo, y la compatibilidad se vuelve a revisar al cambiar de hardware, de entorno de ejecución o de ajustes de exportación. Detectar objetos fuera de las clases preentrenadas exige un flujo aparte de datos y entrenamiento.
Clase correcta y recuadro corrido
El preprocesamiento con letterbox conserva la relación de aspecto y rellena la imagen hasta el tamaño de entrada del modelo. Para devolver un punto predicho a la imagen original, primero se resta el relleno y después se divide por la escala guardada en el preprocesamiento.
Por ejemplo, una imagen de 1920 × 1080 pasa a 640 × 360, con 140 píxeles de relleno arriba y abajo. El centro original (960, 540) queda en (320, 320) dentro de la entrada rellenada. Si se omite la resta del relleno, el recuadro recuperado queda desplazado. Hay que usar la escala y el relleno reales guardados en el preprocesamiento, redondeo incluido, y revisar también el orden BGR o RGB, la normalización y la disposición HWC o NCHW.
Revisar el mensaje y no solo la imagen superpuesta
Desde el directorio de código preparado se arranca el detector.
./scripts/m4/run_m4_1_demo.shEn otra terminal con el entorno cargado se revisan la interfaz, la QoS y la frecuencia de publicación, y después el mensaje mismo.
ros2 topic info -v /perception/detections
ros2 topic hz /perception/detections
ros2 topic echo /perception/detections --once
La salida es un vision_msgs/msg/Detection2DArray. Se empareja cada mensaje con su imagen de origen y se revisan la clase, las coordenadas del recuadro, la marca de tiempo de adquisición y el frame_id. Un cuadro procesado sin objetivos igual debe publicar un arreglo de detecciones vacío, para que el seguimiento posterior distinga una observación vacía de una entrada detenida.
Si un tópico existe pero el suscriptor no recibe nada, hay que revisar la QoS. El curso publica los sensores en modo BEST_EFFORT, y un suscriptor que pida entrega RELIABLE puede resultar incompatible. Para medir la calidad de la detección se usan datos etiquetados. La precisión mide cuántos de los objetos reportados son correctos y la exhaustividad (recall) cuántos de los objetos reales se encontraron. El mAP se informa junto con el conjunto de datos y la convención de IoU, para que las comparaciones tengan sentido. Una imagen superpuesta por sí sola no mide precisión.
¿Cómo se sigue el mismo objeto entre cuadros?
La detección entrega recuadros en cada cuadro. ByteTrack los conecta con los seguimientos existentes. Un modelo de Kalman predice el movimiento, la asociación empareja las observaciones y la gestión de seguimientos se encarga de crearlos, de las pérdidas temporales y de eliminarlos.
Su asociación en dos etapas usa primero las detecciones de puntaje alto y después los candidatos de puntaje bajo, para ayudar a recuperar algunos seguimientos sin pareja. Esos candidatos de puntaje bajo tienen que llegar al rastreador. En el curso, la confianza del detector y el umbral de activación del rastreador vienen ambos en 0.25 por defecto, y un filtrado previo puede eliminar justo los candidatos que necesita la segunda etapa.
Antes de correr el seguimiento hay que detener la demostración de detección, porque el nuevo punto de entrada arranca su propio flujo de detección y seguimiento.
./scripts/m4/run_m4_2_demo.shEl tópico /perception/tracks se revisa en otra terminal con el entorno cargado. Sigue siendo un Detection2DArray, pero ahora lleva los identificadores de seguimiento en Detection2D.id.
Ajustar una falla y repetir la misma secuencia
La configuración del curso incluye estos parámetros.
track_activation_threshold: 0.25
lost_track_buffer: 90
minimum_matching_threshold: 0.8
frame_rate: 30
minimum_consecutive_frames: 1
Subir minimum_consecutive_frames retrasa la confirmación y puede filtrar seguimientos falsos de corta vida. lost_track_buffer controla cuánto tiempo sigue disponible un seguimiento perdido. La biblioteca calcula esa ventana como int(frame_rate / 30.0 * lost_track_buffer), así que estos ajustes dan 90 cuadros procesados. Eso equivale a unos tres segundos si el sistema corre de verdad a 30 FPS, o a seis segundos a 15 FPS si la configuración no se cambia.