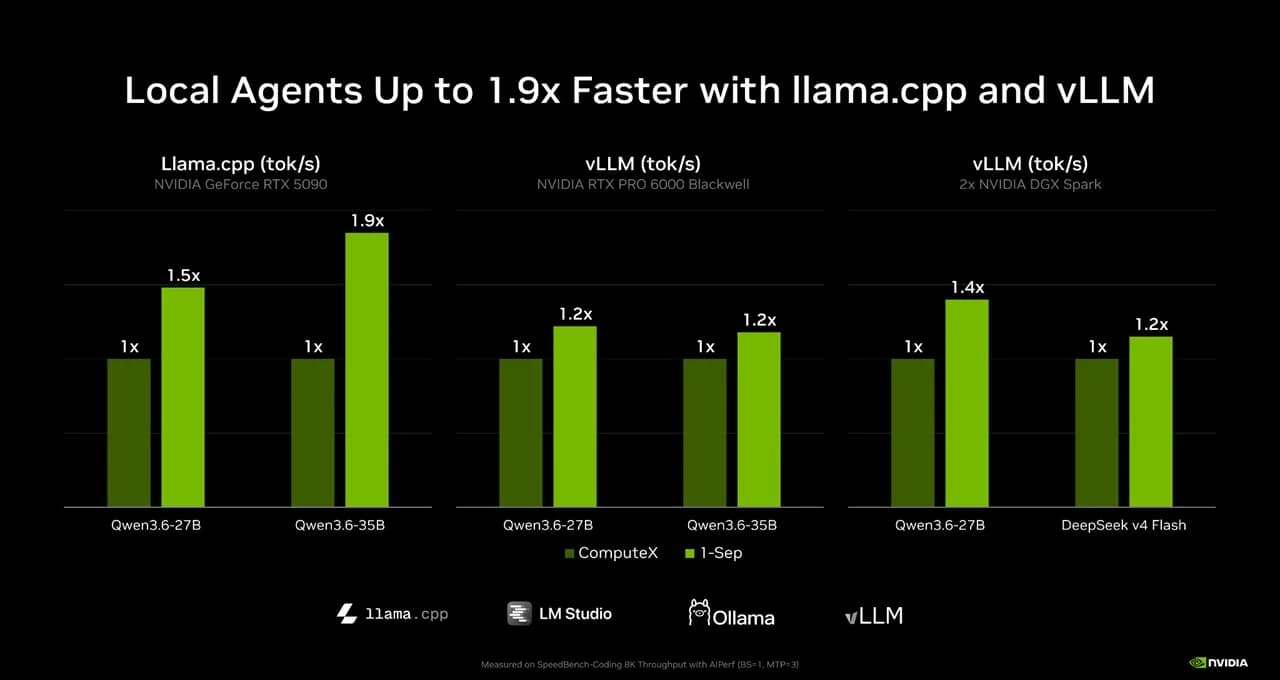
Las bibliotecas de llama.cpp y ggml pasaron a la versión v1.0.0 el 13 de noviembre. El anuncio salió en el blog de Hugging Face, firmado por el equipo de ggml-org, y su punto central es un compromiso con quienes programan sobre ellas. Desde ahora, llama.cpp y ggml van a reflejar cualquier incompatibilidad de API o de ABI con un salto de versión mayor.
llama.cpp permite correr modelos de lenguaje multimodales en una gama amplia de hardware, desde un equipo doméstico hasta servidores empresariales de gama alta. Lo logra con cuantización, backends optimizados y una implementación portable en C/C++. El equipo lo define como la plataforma "más liviana, versátil y sensata para construir productos de IA multiplataforma y privados".
¿Por qué una versión 1.0 después de tres años y medio?
El proyecto lleva unos tres años y medio desde su primer commit. En ese tiempo creció mucho, y varias aplicaciones ya dependen de su código. El equipo espera que esa tendencia siga, porque la IA local y la privacidad pesan cada vez más en el uso diario.
Cada integración nueva suma desarrolladores que dependen de las interfaces de la biblioteca. Por eso, explican, tener una API flexible pero estable es prioritario. La v1.0.0 busca dejar clara esa responsabilidad, y a medida que crezca la adopción el equipo será más estricto para que los límites entre versiones queden visibles para quienes consumen el código más abajo en la cadena.
Versionado semántico en todo ggml-org
El anuncio fija reglas de actualización para todos los proyectos de ggml-org que usan versionado semántico. La regla de fondo es la de cualquier esquema de ese tipo. Un cambio que rompa la API o la ABI obliga a subir el número mayor, y quien integra la biblioteca puede saber por el número si una actualización le va a exigir cambios.
Distribución
El equipo quiere ampliar las vías por las que el software de ggml-org llega a desarrolladores y usuarios finales. Para sumar sus proyectos a flujos de empaquetado y publicación, remite a una discusión abierta en GitHub.
Cómo se desarrolla el proyecto
El anuncio destaca la comunidad de contribuidores que se formó alrededor del código. Con el avance de la IA en ingeniería de software, el equipo dice que sigue integrando modelos de lenguaje en su ciclo de desarrollo "de manera reflexiva y razonable". Mantener un código de calidad, controlar la arquitectura y entender los detalles de la implementación seguirán siendo sus prioridades.
Para sostener un ritmo de desarrollo más rápido, el proyecto invierte cada vez más en la infraestructura de integración continua. Con herramientas de Hugging Face como HF Buckets y HF Jobs, escala la capacidad necesaria para verificar cada cambio que entra a las ramas master. Con hardware aportado por NVIDIA, AMD, Qualcomm, Arm, IBM e Intel, suma además ejecutores propios de pruebas en todas las plataformas de hardware principales.
¿En qué hardware y con qué modelos corre?
El motor de aprendizaje automático que está debajo de llama.cpp es ggml, diseñado para funcionar en prácticamente cualquier hardware. Lo consigue con backends dedicados para cada plataforma. Cada uno se puede compilar como biblioteca dinámica y cargarse, si se quiere, en tiempo de ejecución.
La lista completa de backends implementados está en el repositorio de ggml. En modelos, llama.cpp soporta hoy más de 150 variantes de arquitectura y todos los métodos de decodificación especulativa de uso común. El equipo se compromete a dar soporte continuo a todas las arquitecturas.
Recursos
El equipo de llama.cpp en Hugging Face agradeció a los mantenedores de largo plazo y a todos los contribuidores. Junto al anuncio dejó estos enlaces:
- Ejemplos de llama.cpp
- ggml-org en Hugging Face
- ggml-org en GitHub
- Las aplicaciones de escritorio Llama para macOS y Windows, hechas por el mismo equipo de llama.cpp y Hugging Face.
En los comentarios del anuncio, un usuario preguntó si no habrá versión de escritorio para Linux. El equipo no la mencionó en el texto.