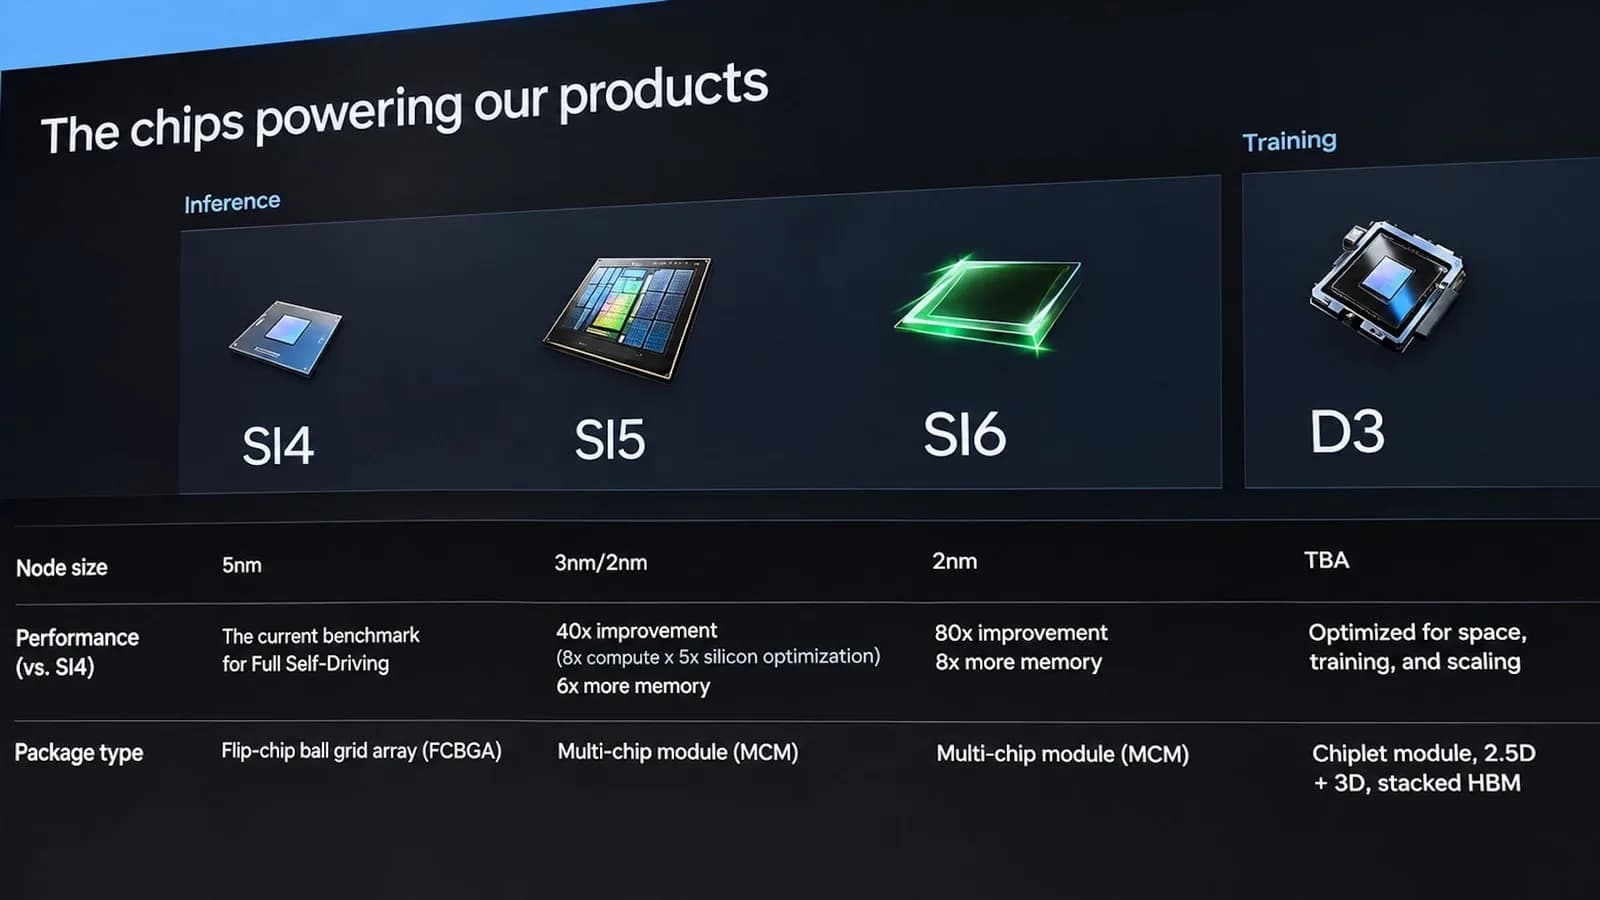
Tesla dio a conocer una hoja de ruta renovada para sus aceleradores de IA. Según la lámina, su acelerador de inferencia de sexta generación entregará 80 veces el cómputo del chip de cuarta generación que llevan hoy sus autos, y el acelerador de entrenamiento D3 abandonará la arquitectura centrada en SRAM para pasar a un diseño de varios chiplets con memoria HBM apilada. Lo informó Anton Shilov en Tom's Hardware el 6 de noviembre.
Hay además un cambio de nombre. Tesla dejó de hablar de inteligencia artificial y adoptó el término "superinteligencia" para sus aceleradores, que ahora llevan la sigla SI. Elon Musk confirmó hace poco que SpaceXAI pasaría a llamarse SpaceXSI por la misma razón. Un usuario de X notó el 4 de noviembre que los chips que antes se llamaban AI4, AI5 y AI6 aparecían en la presentación como SI4, SI5 y SI6, y lo relacionó con la intención del presidente Trump de reemplazar "inteligencia artificial" por "superinteligencia".
La hoja de ruta en una tabla
Tom's Hardware armó esta tabla con los datos de la lámina y sus propias estimaciones, marcadas como tales.
| HW3 / AI3 | SI4 / HW4 | SI5 / AI5 | SI6 / AI6 | Dojo D1 | Dojo D3 | |
|---|---|---|---|---|---|---|
| Uso | Inferencia | Inferencia | Inferencia | Inferencia | Entrenamiento | Entrenamiento |
| Proceso | Samsung 14 nm | Samsung 7 nm | TSMC 3 nm / Samsung 2 nm | Clase 2 nm | TSMC 7 nm | Por definir |
| Arquitectura | Monolítica | Monolítica | MCM | MCM | SoW | Chiplets |
| Memoria | LPDDR4, 8 GB | GDDR6, 16 GB | 96 GB | 144 GB | 440 MB de SRAM por chip | HBM apilada |
| Rendimiento frente a SI4 | s/d | 1x | 40x | 80x | s/d | s/d |
| Cómputo estimado (TOPS) | 72 | 216 a 576 | 8.640 a 23.040 | 17.280 a 46.080 | 362 TFLOPS | Por definir |
| Estado | Heredado | Producción | Cerca de producción | Desarrollo | Descontinuado | Desarrollo |
¿Abandona Dojo D3 la integración a nivel de oblea?
Para Tom's Hardware, lo más llamativo es el regreso del acelerador de entrenamiento Dojo, diseñado en casa. Elon Musk canceló el proyecto Dojo a escala de oblea en agosto de 2025, y en agosto de 2026 dijo que SpaceX y xAI usarían solo hardware de Nvidia, tanto en sus centros de datos en la Tierra como en los que planean fuera de ella. La tercera generación de Dojo será muy distinta de las dos primeras, D1 y D2.
Tesla describe el D3 como un diseño de chiplets que combina empaquetado 2.5D y 3D con memoria HBM apilada. Es un quiebre con la arquitectura sistema en oblea del Dojo D1, que se apoyaba en SRAM distribuida dentro del chip e interconectaba 25 procesadores D1 con 11 GB de SRAM mediante empaquetado a escala de oblea.
Pasar a HBM sugiere que Tesla quiere aumentar mucho la capacidad de memoria. Los modelos de IA actuales consumen enormes cantidades de memoria para guardar parámetros, activaciones y datos intermedios, y eso hace poco atractiva la SRAM en términos de capacidad. La HBM facilita escalar la memoria, aunque trae otros compromisos de latencia, ancho de banda, empaquetado y consumo. No queda claro si la empresa abandonó del todo la integración a nivel de oblea.
Se pueden apilar módulos HBM a medida sobre chips lógicos interconectados con empaquetado a escala de oblea. Pero esa integración es cara y tiene sentido en pocos casos, entre ellos las arquitecturas centradas en SRAM. Poner HBM encima de lógica interconectada a escala de oblea agrega complejidad de diseño, problemas de refrigeración, una fabricación más difícil que puede bajar el rendimiento de producción, dudas de confiabilidad a largo plazo y, al final, costo. Para Tom's Hardware, eso hace menos probable que el D3 use oblea completa.
Tesla no ha revelado el rendimiento, la capacidad de memoria, el proceso de fabricación ni el calendario del D3. Sí dice que estará optimizado para "espacio, entrenamiento y escalamiento". Eso apunta a un acelerador fácil de escalar, de arquitectura más convencional. La mención al espacio indica que estará pensado también para funcionar fuera de la Tierra, lo que probablemente implica versiones endurecidas contra la radiación.
¿Cuánto rendiría el SI6?
La lámina indica que el SI6 tendrá 80 veces el cómputo y 9 veces la memoria del HW4. Según cómo se mida el rendimiento del HW4, eso equivale a entre 17.280 y 46.080 TOPS (billones de operaciones por segundo), o entre 17,28 y 46,08 POPS. No se sabe qué formatos de datos admitirá el SI6, y las cifras son estimaciones.
Como referencia, la GPU Rubin de Nvidia ofrece 50 PFLOPS en NVFP4 para inferencia, 35 PFLOPS en NVFP4 para entrenamiento y 17,5 PFLOPS en FP8/FP6. Rubin ya se entrega a clientes, mientras el SI6 está previsto para 2029 o 2030.
El punto de partida, el HW4
El procesador de inferencia de cuarta generación que usan hoy los autos de Tesla se llamó HW4, después AI4 y ahora SI4. Lo fabrica Samsung Foundry con su proceso de clase 7 nm, usa empaquetado FCBGA convencional y presumiblemente 16 GB de GDDR6. La lámina dice por error que se fabrica en un nodo de clase 5 nm, advierte Tom's Hardware.
Tesla lo describe como la referencia actual de su conducción autónoma FSD, así que es la base contra la que se miden las generaciones futuras. La empresa no publica su rendimiento absoluto, su memoria ni su consumo. Musk dijo una vez que el HW4 rinde entre 3 y 8 veces más que el HW3, que tenía un valor oficial de 72 TOPS. Eso deja al HW4 entre 216 y 576 TOPS, siempre como estimación.
SI5, multichip y hasta 800 W
La lámina confirma que el SI5 (también llamado HW5 o AI5) se fabricará en procesos de clase 3 nm en TSMC y de clase 2 nm en Samsung Foundry, y que usará un módulo multichip (MCM), a diferencia del empaquetado convencional del HW4.
Tesla espera que el SI5 rinda 40 veces más que el HW4. Según Musk, ese salto combina 8 veces más capacidad de cómputo, por procesos más densos y más unidades de ejecución, con 5 veces de ganancia por optimización del silicio. Eso apunta a entre 8.640 y 23.040 TOPS, también estimados. El procesador consumiría entre 250 y 800 W según la aplicación, y tendrá seis veces la memoria de su antecesor, o sea 96 GB. Según use GDDR6 o GDDR7, su ancho de banda quedaría entre 768 GB/s y 1.536 GB/s.
SI6 en Samsung hasta 2033
Para el SI6, Tesla habla de 80 veces el rendimiento del HW4 y de 144 GB de memoria. La empresa ya firmó un acuerdo con Samsung Foundry para fabricar sus aceleradores de inferencia de sexta generación hasta 2033, y la lámina revela que el chip se hará en un proceso de clase 2 nm.
Como el chip llegaría en 2029 o 2030, Tom's Hardware cree que se trataría de alguna variante del nodo SF2 de Samsung, ya sea SF2A para automóviles, SF2P de mayor rendimiento o incluso SF2Z con alimentación por la cara trasera. La lámina tampoco muestra planes de producir el SI6 en Terafab con el proceso 14A de Intel en la década de 2030.
El SI6 mantendrá el enfoque multichip que estrena el SI5. Así aprovecha la experiencia con la quinta generación y contiene el costo de empaquetado. Varios fabricantes de autos evalúan diseños de varios chiplets y memoria HBM para sus próximos sistemas en paquete, lo que encarecerá esos componentes. No se sabe cuándo adoptará Tesla la HBM en sus aceleradores de inferencia, y probablemente no será con el SI6.