El equipo de PyTorch integró Helion en el backend lineal de vLLM para estudiar si un lenguaje de kernels de alto nivel con autoajuste puede mejorar el rendimiento de la inferencia de modelos de lenguaje y, a la vez, simplificar la escritura de kernels. Una sola implementación de multiplicación general de matrices (GEMM) en Helion cubre varias variantes de algoritmo, entre ellas la GEMM estándar, Split-K y Swap-AB. La mejor variante y su configuración se eligen solas mediante autoajuste por forma de entrada.
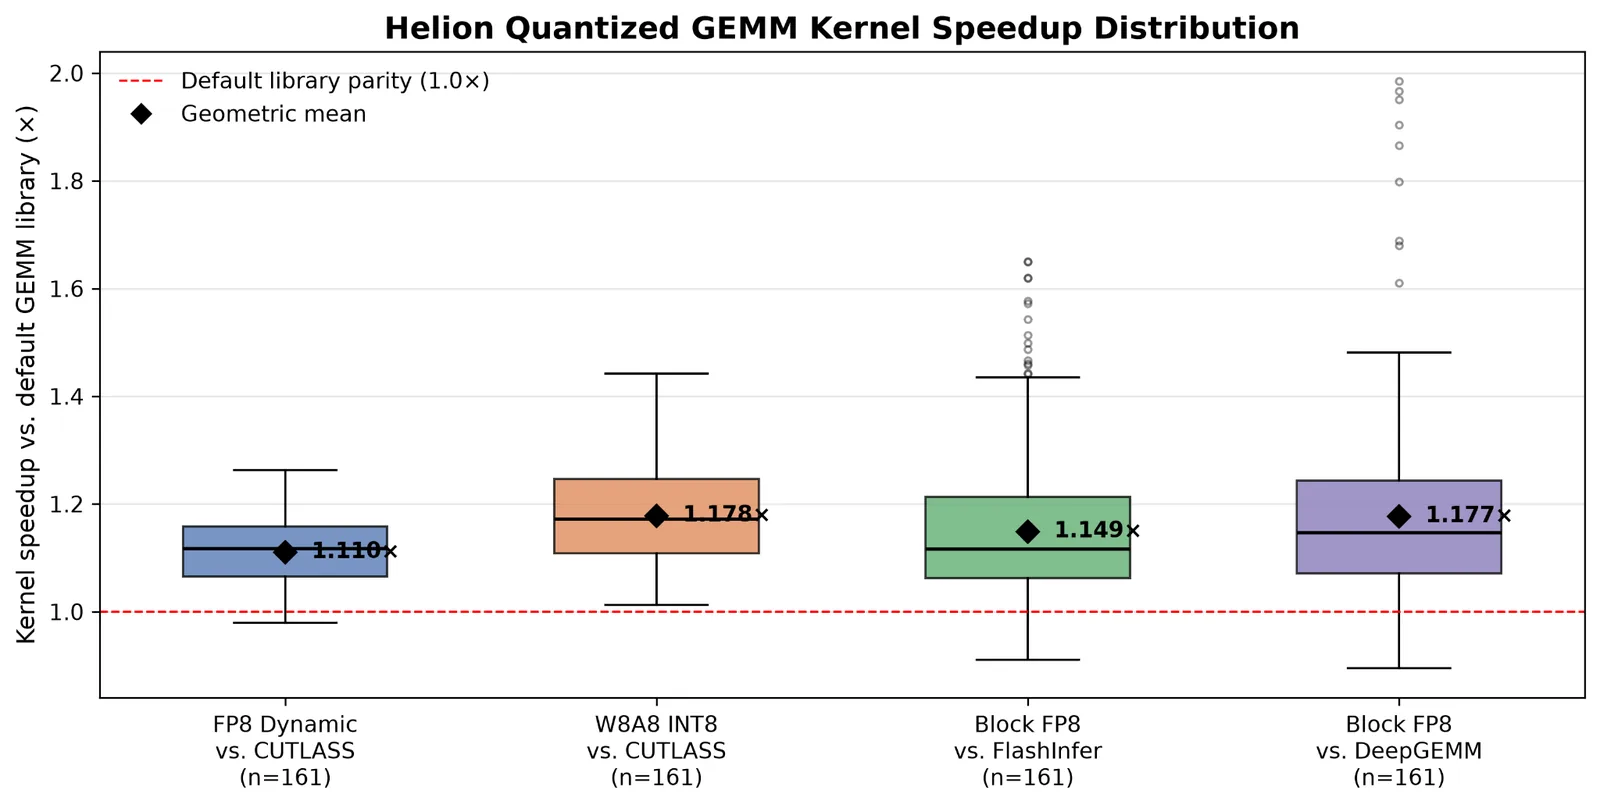
En GPU Hopper de NVIDIA, el backend lineal de Helion combina ese ajuste por forma con un despacho híbrido y supera a los backends por defecto de vLLM, CUTLASS y DeepGEMM, en todos los modelos evaluados. Las ganancias de rendimiento de punta a punta son consistentes y en algunas cargas superan el 10%.
¿Qué son vLLM y Helion?
vLLM es un framework de alto rendimiento para inferencia y despliegue de modelos de lenguaje grandes (LLM). Para capas lineales cuantizadas, como FP8, INT8, INT4 y NVFP4, vLLM ofrece backends lineales especializados que integran kernels optimizados para hardware de bibliotecas como CUTLASS, DeepGEMM y FlashInfer. Esos backends le permiten usar kernels optimizados para distintos formatos de cuantización y plataformas de hardware.
Helion es un lenguaje específico de dominio (DSL) para kernels, nativo de PyTorch e independiente del hardware, pensado para escribir kernels de alto rendimiento con un modelo de programación por bloques (tiles). Su abstracción de alto nivel permite expresar un kernel una sola vez en código Python conciso, y Helion genera código especializado para distintas cargas en distintas plataformas.
En vez de especializar a mano cada kernel para cada carga y cada hardware, Helion usa un autoajustador previo a la ejecución (AOT) que explora de forma sistemática un espacio de búsqueda amplio. Ese espacio va desde la disposición de memoria y la planificación del kernel en bajo nivel hasta las decisiones de algoritmo en alto nivel, y el autoajustador elige la configuración que mejor rinde. Helion también admite búsqueda guiada por un LLM para hacer el ajuste más eficiente.
Oportunidades y desafíos de adoptar Helion
Oportunidades
Rendimiento. Un trabajo anterior del equipo mostró que Helion puede alcanzar el estado del arte en kernels de inferencia con distintos patrones de carga y plataformas de hardware gracias al ajuste fino.
Un marco de ajuste sistemático. Frente a enfoques agénticos más abiertos, que generan, perfilan y refinan implementaciones de kernels de forma iterativa, Helion plantea el ajuste como un problema estructurado de optimización numérica sobre un espacio de búsqueda bien definido. Eso hace el proceso más estable y confiable, con una eficiencia competitiva y sin depender del perfilado para guiar la búsqueda. Además admite búsqueda guiada por LLM, que combina la capacidad de razonamiento del modelo con la optimización numérica sistemática.
Portabilidad y abstracción. Helion permite mantener una sola implementación del kernel y optimizarla para distintos patrones de carga y plataformas de hardware.
Optimización del lado del usuario. Los kernels por defecto de motores de inferencia como vLLM suelen estar optimizados para cargas generales y modelos de uso común. Con Helion, el usuario puede ajustar el rendimiento para su propio despliegue sin experiencia especializada en kernels ni un esfuerzo de ingeniería grande.
Desafíos
La integración de Helion en motores de inferencia todavía enfrenta problemas, y el equipo de Helion trabaja en mitigarlos.
Costo del ajuste previo. Helion automatiza y sistematiza el ajuste de kernels, pero un ajuste fino todavía puede tomar horas. Ese costo viene sobre todo de la granularidad de la estrategia de ajuste y no de Helion en sí. Lograr el mismo nivel de especialización por carga con otros DSL de kernels tendría un costo de ajuste comparable o incluso mayor.
Costo al arrancar. La captura de CUDA Graph durante el arranque de vLLM dispara la compilación JIT de Helion, lo que aumenta la latencia del arranque en frío. En los arranques en caliente ese costo se elimina casi por completo guardando en caché los artefactos compilados.
Costo en tiempo de inferencia. Fuera del rango de captura de CUDA Graph, el despacho y lanzamiento de kernels de Helion durante la inferencia puede sumar carga a la CPU y anular las ganancias del ajuste fino. En la práctica, Helion rinde más cuando se ejecuta bajo CUDA Graphs, que evitan esa carga.
Costo de mantenimiento. Distribuir configuraciones preajustadas para los modelos populares crea una carga de mantenimiento permanente en el proyecto. Los archivos de configuración grandes son difíciles de mantener y no se pueden validar a fondo con pruebas unitarias e integración continua.
El triángulo de compromisos
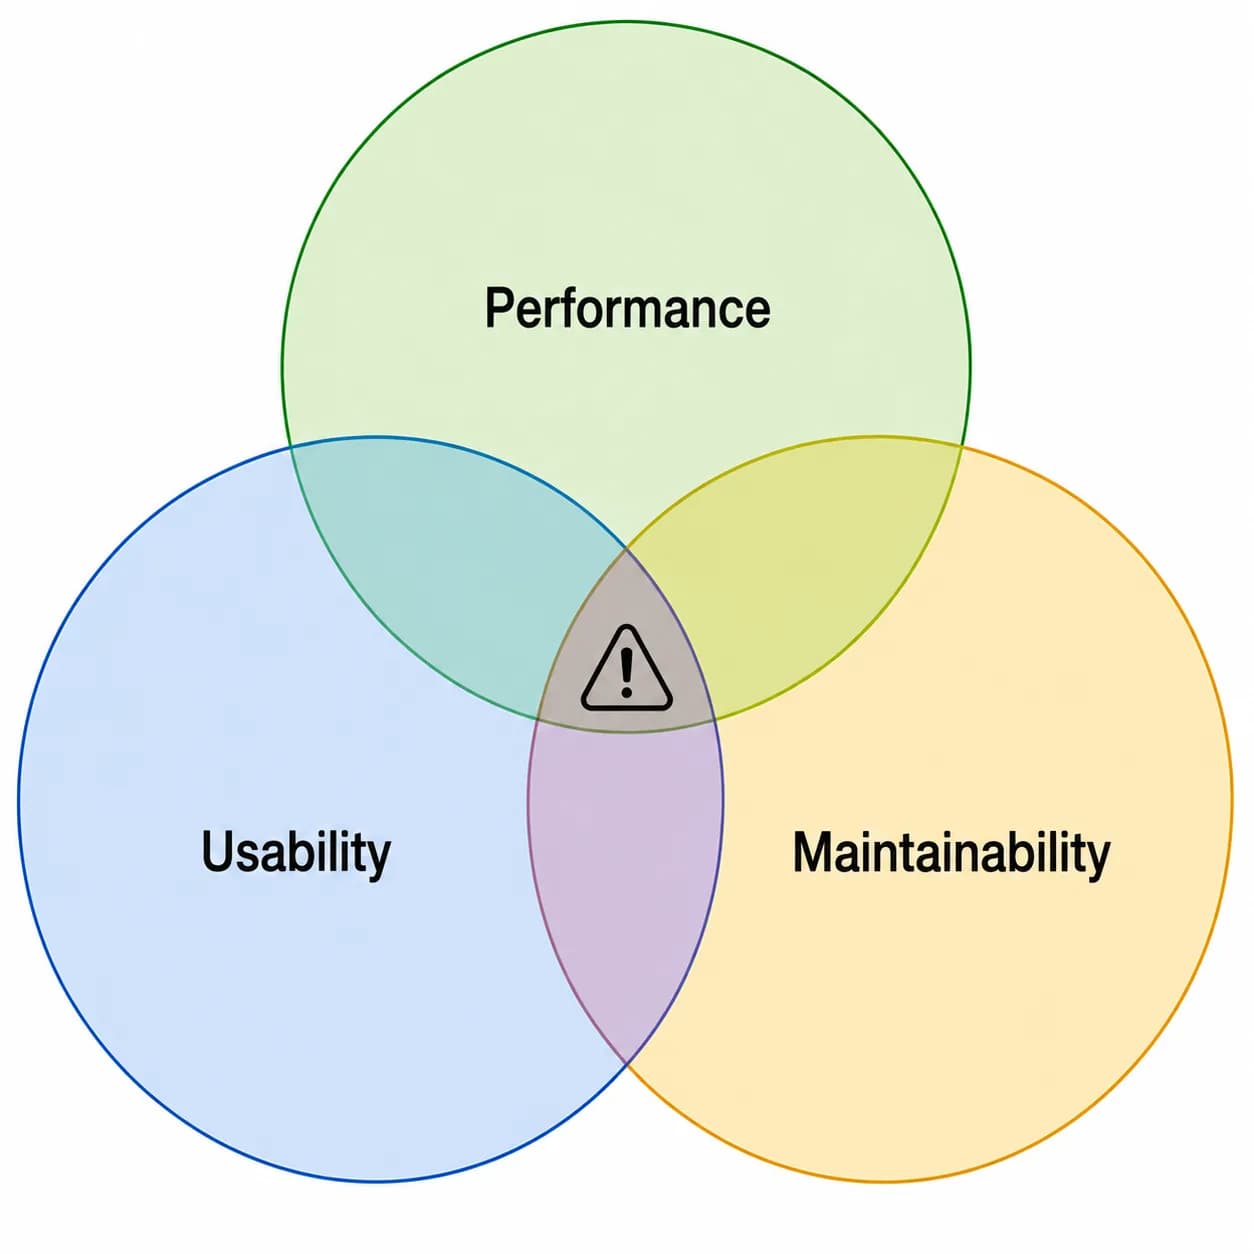
El ajuste fino de kernels con Helion obliga a elegir entre rendimiento, facilidad de uso y facilidad de mantenimiento. El compromiso no es propio de Helion. Viene con cualquier optimización de kernels por carga, y optimizar dos de esos factores suele costar el tercero.
Más rendimiento exige, en general, un ajuste de configuración más fino. Eso aumenta el costo del autoajuste del lado del usuario o obliga a los mantenedores a entregar y mantener más configuraciones preajustadas. La meta es encontrar el equilibrio correcto para cada caso de uso.
El backend lineal de Helion
Alcance
Este trabajo agrega un backend lineal de Helion a vLLM y se concentra en GPU Hopper de NVIDIA, usando el backend Triton de Helion. FP8 e INT8 son los formatos de cuantización principales para inferencia eficiente en Hopper, así que el objetivo son las GEMM cuantizadas con estos formatos:
- FP8_Dynamic, con activaciones FP8 escaladas por token y pesos escalados por canal.
- W8A8_INT8, con activaciones INT8 escaladas por token y pesos escalados por canal.
- Block_FP8, FP8 con escalado de activaciones de 1×128 y de pesos de 128×128.
Los resultados iniciales con el backend CuteDSL de Helion muestran un rendimiento de GEMM competitivo en GPU Blackwell de NVIDIA. A medida que ese backend madure, el trabajo se podrá extender a Blackwell.
¿Cómo se implementa el kernel?
Hay variantes del algoritmo GEMM que mejoran el rendimiento para ciertas formas de entrada. En particular:
- Split-K reparte la dimensión K entre varios bloques de hilos para aumentar el paralelismo cuando las dimensiones M o N son demasiado chicas.
- Swap-AB reescribe
A@Bcomo(B.T@A.T).Tpara mejorar el rendimiento en formas con una dimensión M pequeña, porque permite un mosaico más favorable y un mejor uso de la GPU.
Tradicionalmente, quien escribe kernels tiene que implementar varias variantes de GEMM, medir la estándar contra las especializadas y desarrollar heurísticas para decidir cuál despachar según la forma de la entrada. Por ejemplo, el backend lineal Block_FP8 actual de vLLM despacha a la variante Swap-AB cuando M < 32 en Hopper. Esas heurísticas suelen funcionar bien en general, pero pueden no ser óptimas para cada modelo o carga.
Con Helion, una sola implementación unificada de GEMM cubre las tres variantes, la estándar, Split-K y Swap-AB. En vez de escribir kernels separados y diseñar a mano las heurísticas de despacho, las decisiones de algoritmo quedan expuestas como parámetros ajustables. El autoajustador AOT elige solo la mejor variante, junto con la configuración de bajo nivel del kernel, para cada carga.
Para simplificar, el ejemplo de abajo usa un kernel básico de multiplicación de matrices. Los kernels GEMM cuantizados de este trabajo siguen la misma estructura, con lógica adicional de cuantización y escalado.
def matmul(
    out: torch.Tensor,  # [M, N]
    a: torch.Tensor,    # [M, K]
    b: torch.Tensor,    # [K, N]
) -> None:
    M, K = a.shape
    N = b.shape[1]
    hl.specialize(K)
    hl.specialize(N)

    out_dtype = out.dtype
    acc_dtype = torch.float32

    split_k = hl.register_tunable(
        "split_k", PowerOfTwoFragment(1, 256)
    )
    k_block_size = helion.next_power_of_2(helion.cdiv(K, split_k))
    if split_k > 1:
        out.zero_()

    swap_ab = hl.register_tunable(
        "swap_ab", BooleanFragment()
    )

    for tile_m, tile_n, outer_k in hl.tile(
        [M, N, K],
        block_size=[None, None, k_block_size]
    ):
        acc = hl.zeros([tile_m, tile_n], acc_dtype)
        acc_t = acc.t()
        for tile_k in hl.tile(outer_k.begin, outer_k.end):
            if swap_ab:
                a_blk = hl.load(a, [tile_m.index[None, :], tile_k.index[:, None]])
                b_blk = hl.load(b, [tile_k.index[None, :], tile_n.index[:, None]])
                acc_t = hl.dot(
                    b_blk,
                    a_blk,
                    acc=acc_t,
                    out_dtype=acc_dtype,
                )
            else:
                acc = hl.dot(
                    a[tile_m, tile_k],
                    b[tile_k, tile_n],
                    acc=acc,
                    out_dtype=acc_dtype,
                )

        if swap_ab:
            out_blk = acc_t.t().to(out_dtype)
        else:
            out_blk = acc.to(out_dtype)

        if split_k == 1:
            out[tile_m, tile_n] = out_blk
        else:
            hl.atomic_add(out, [tile_m, tile_n], out_blk)
La implementación expone las dos decisiones de algoritmo como parámetros ajustables. split_k queda limitado a potencias de dos hasta 256 y swap_ab es un parámetro booleano. El autoajustador recorre ese espacio de búsqueda acotado, mide las distintas combinaciones y elige la mejor variante para cada carga.
Despacho híbrido
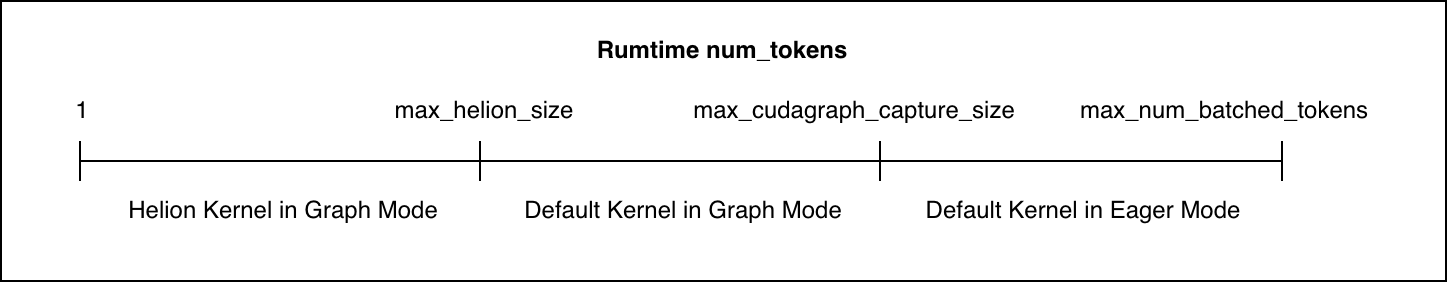
El equipo adoptó una estrategia de despacho híbrido según el valor de num_tokens en tiempo de ejecución y la cobertura de CUDA Graph. Para formas pequeñas, hasta max_helion_size, el backend lineal despacha a Helion bajo la reproducción de CUDA Graph. Para formas más grandes, vuelve al kernel por defecto (CUTLASS o DeepGEMM).
Esta estrategia tiene tres beneficios prácticos:
- Elimina la carga de Helion en tiempo de ejecución. Los kernels de Helion solo corren mediante la reproducción de CUDA Graph, así que se evita la carga adicional de CPU por despacho y lanzamiento.
- Reduce el costo del ajuste. El ajuste fino de Helion se limita al rango pequeño de
num_tokensque domina la decodificación. Eso reduce mucho las formas de entrada que hay que ajustar y mantiene la posibilidad de ganancias de punta a punta. - Reduce el costo de mantener configuraciones. Con menos configuraciones ajustadas, es más práctico validarlas, distribuirlas y mantenerlas en el tiempo.
Autoajuste de los kernels
Los kernels lineales de Helion se autoajustan con el script de utilidad que trae vLLM:
HELION_AUTOTUNER=LLMSeededLFBOTreeSearch \
HELION_BENCHMARK_CUDAGRAPH =1 \
python scripts/autotune_helion_kernels.py \
  --kernels scaled_mm block_scaled_mm \
  --autotune-effort "full"