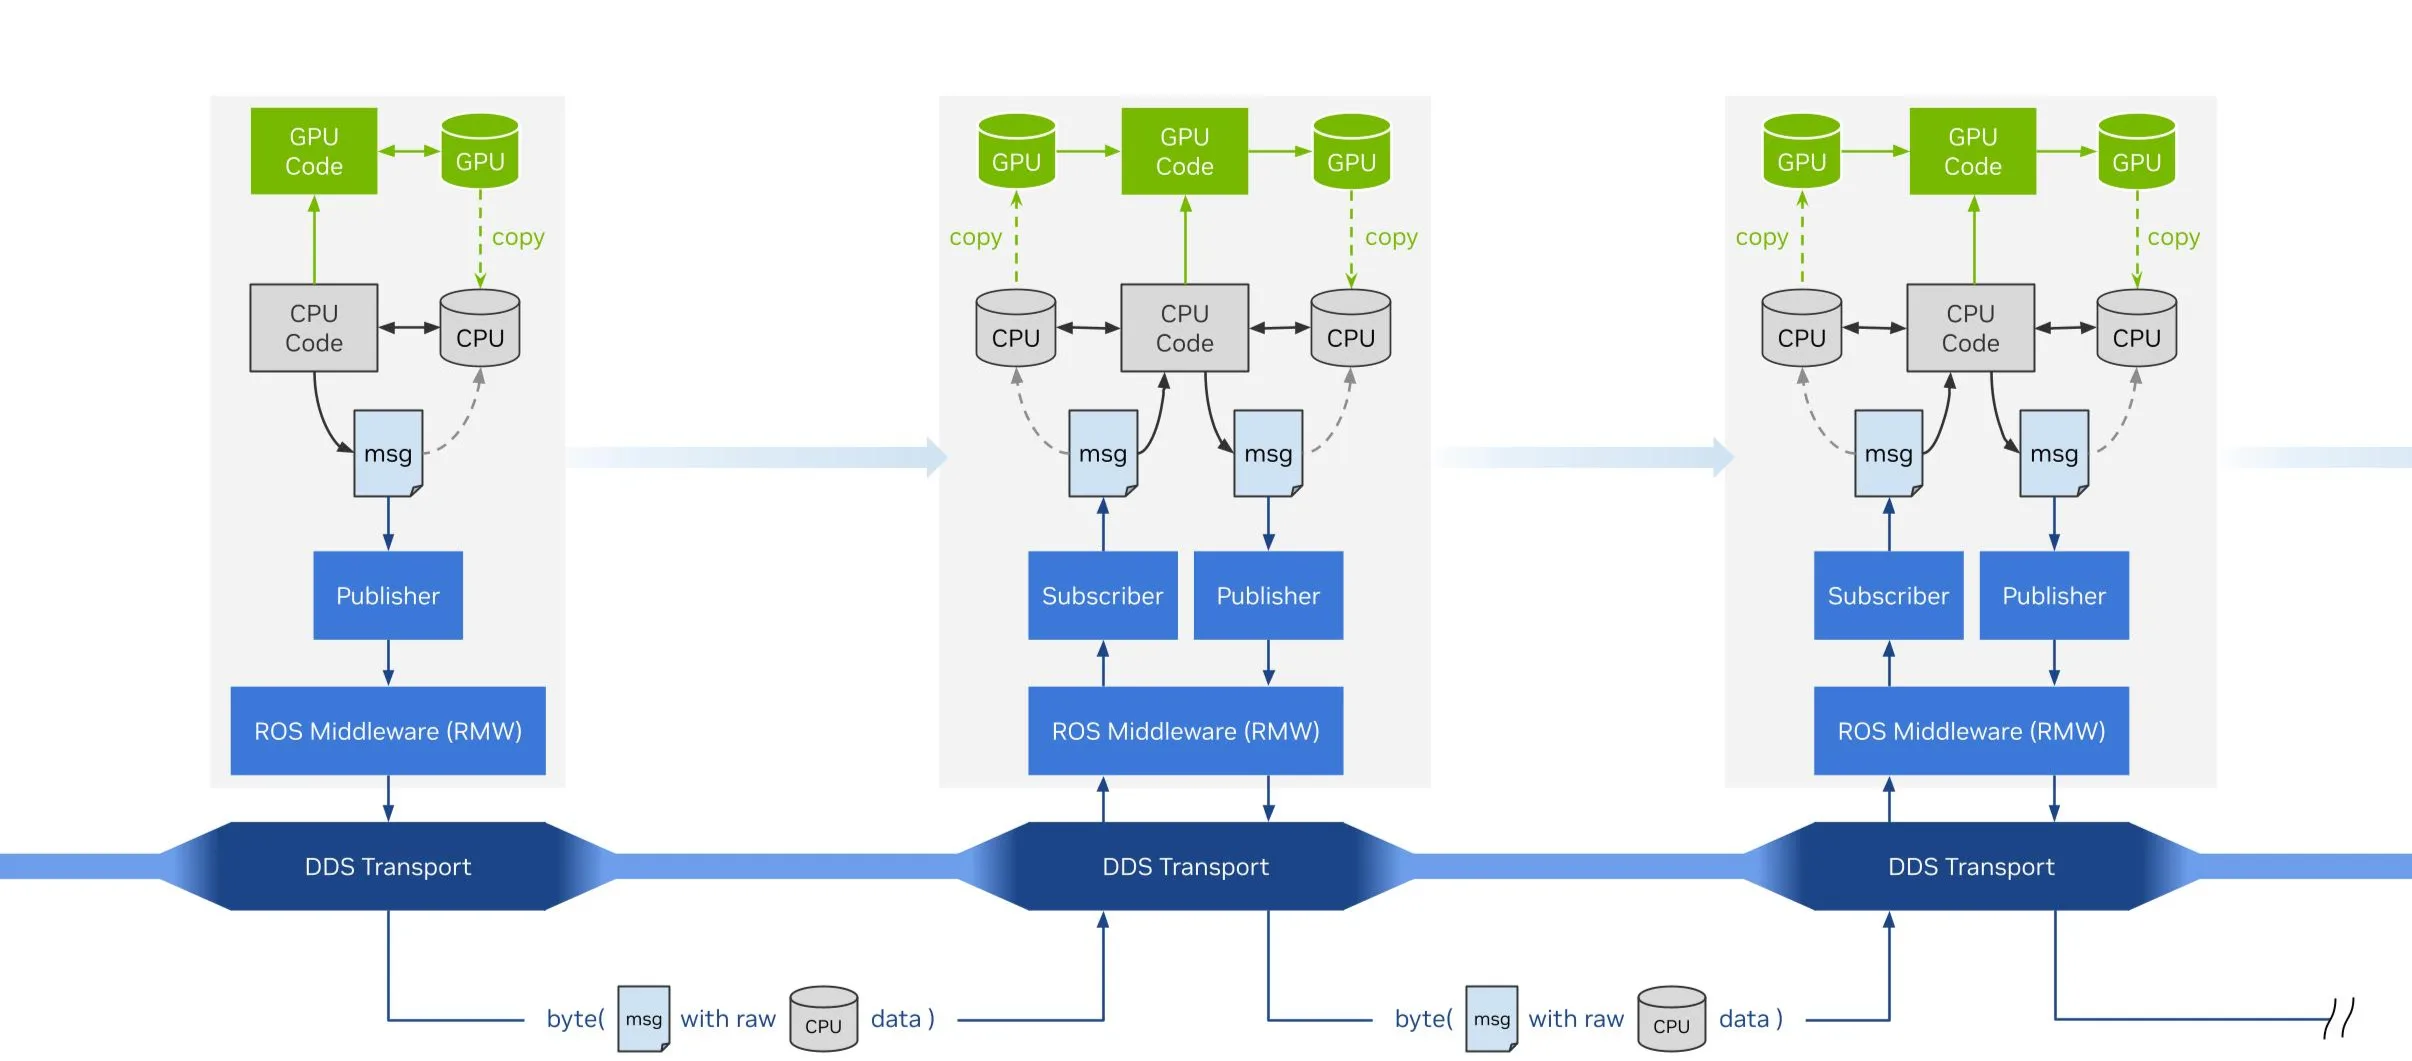
La aceleración por GPU acorta los tiempos en las cargas de robótica que exigen cómputo, pero un kernel CUDA rápido no garantiza por sí solo un grafo ROS 2 rápido. Cuando los mensajes se mueven entre nodos, pueden seguir serializándose o copiándose a través de la memoria del anfitrión, y ahí se erosiona el beneficio de mantener la percepción y las cargas de inteligencia artificial dentro de la GPU.
Con la abstracción rosidl::Buffer y el backend de buffers CUDA que NVIDIA aportó a ROS Lyrical, los nodos de ROS 2 pueden intercambiar cargas residentes en GPU por transporte sin copias cuando las condiciones de ejecución lo permiten, manteniendo los mensajes estándar de ROS 2 y los límites entre nodos. Todos los nodos de NVIDIA Isaac ROS 5.0 ya usan el backend de buffers CUDA.
Un nodo de ROS 2 existente puede adoptar rosidl::Buffer con cambios mínimos. La tarea difícil es otra. Hay que identificar los límites correctos que se van a tocar, y eso pide una auditoría cuidadosa de las reservas de memoria, la serialización, la propiedad de los flujos y el comportamiento de respaldo.
El tutorial de NVIDIA convierte esa auditoría en un flujo de trabajo guiado por un agente. Un agente de programación usa la habilidad migrate-node-to-rosidl-buffer, hecha para este fin, para inspeccionar un nodo acelerado con CUDA, rastrear el movimiento de los datos, planificar una refactorización mínima que preserve la interfaz y verificar que el camino de transporte CUDA quedó realmente activo. La carga acelerada que resulta se puede desplegar sobre un NVIDIA Jetson AGX Thor.
rosidl::Buffer y el backend de buffers CUDA
En ROS 2 Lyrical, los campos de arreglo primitivo de largo variable, como uint8[], se representan en el código C++ generado con rosidl::Buffer<uint8_t>. El rosidl::Buffer por omisión, respaldado en CPU, se comporta como la interfaz std::vector<uint8_t> que el código ROS 2 existente espera, así que la compatibilidad de fuente se mantiene. La abstracción enchufable también permite a los fabricantes de plataformas soportar almacenamiento gestionado desde afuera sin tener que definir un tipo de mensaje ROS aparte.
NVIDIA aportó el backend de buffers CUDA para ROS 2 Lyrical. Implementa el almacenamiento de rosidl::Buffer<uint8_t> con la gestión de memoria virtual de CUDA. Cuando el publicador y el suscriptor cumplen los requisitos de ejecución del backend, la carga se mueve entre nodos coubicados sin serialización y sin copias al anfitrión. Si no los cumplen, ROS 2 cae de forma automática al camino por CPU, compatible con cualquier nodo ROS 2 existente.
Los requisitos del camino optimizado son estrictos. Mismo anfitrión, mismo dispositivo CUDA, mismo usuario de Linux y una implementación RMW soportada, por ejemplo rmw_fastrtps_cpp o rmw_zenoh_cpp.
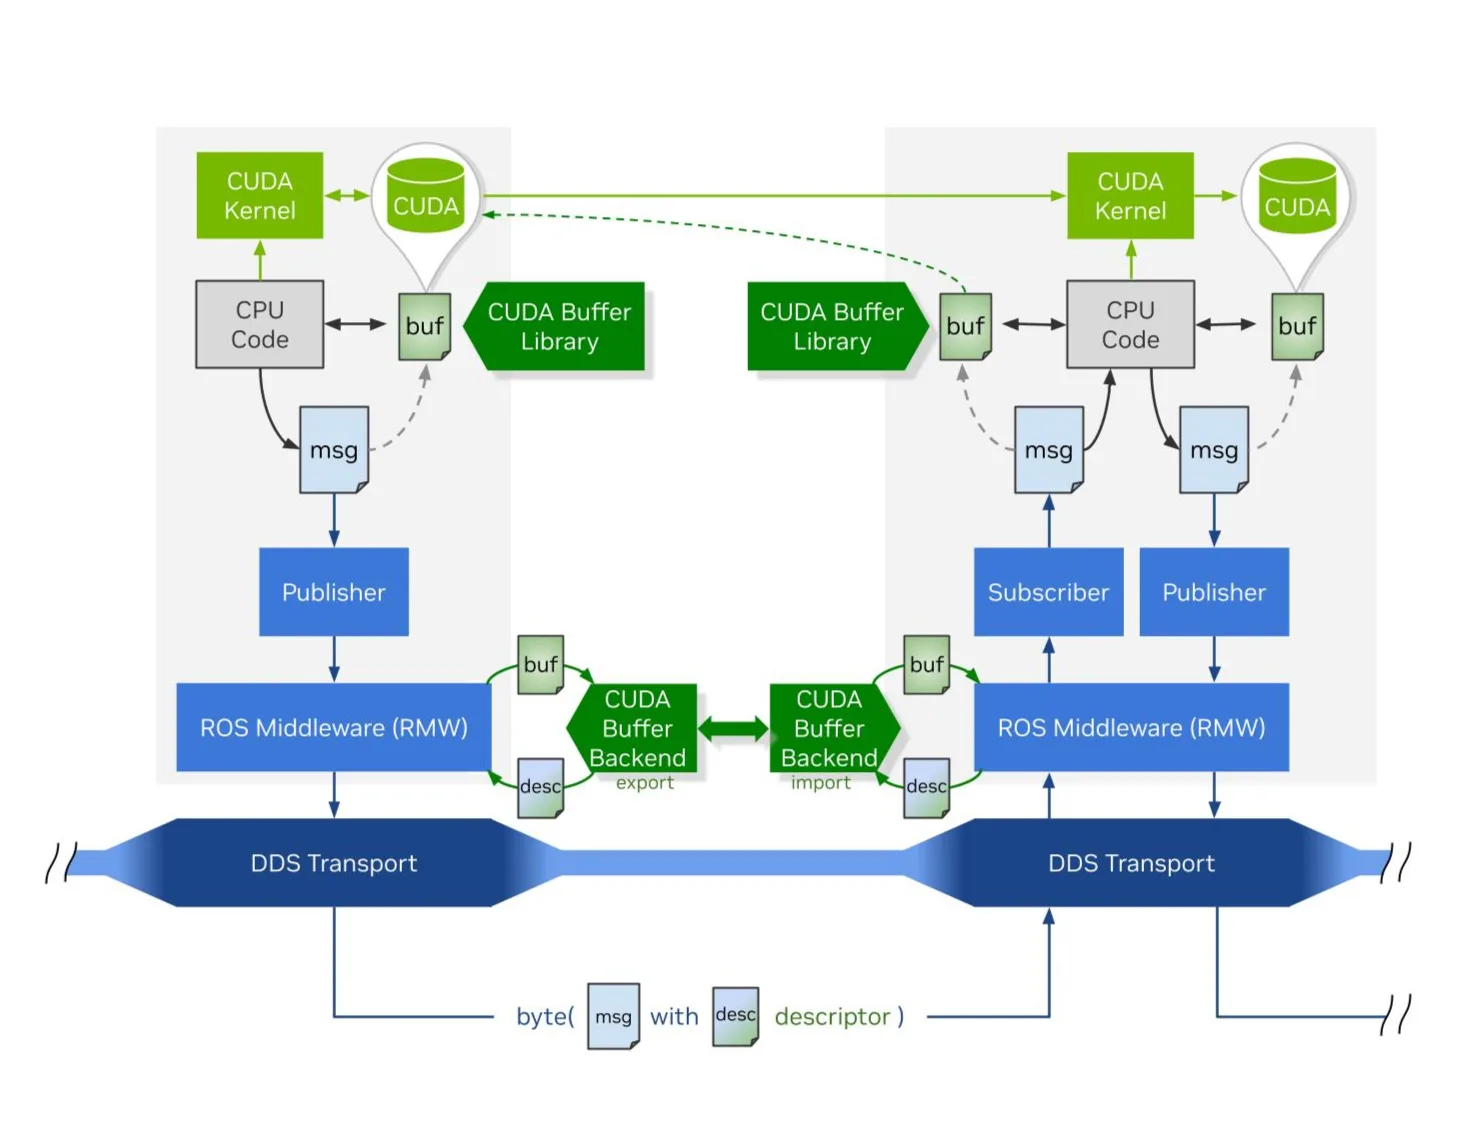
Juntos, rosidl::Buffer y el backend de buffers CUDA dejan la compartición de memoria y la gestión del tiempo de vida de los datos detrás de un campo estándar de ROS 2. La capacidad de la rama principal queda así más fácil de adoptar en aplicaciones de robótica aceleradas por GPU, y el desarrollador se concentra en la lógica del nodo conservando el respaldo por CPU para los pares incompatibles.
El nodo de partida
El tutorial usa como ejemplo el nodo ROS 2 de Depth Anything 3 sobre TensorRT. El modelo DA3 predice geometría espacialmente consistente a partir de un número arbitrario de entradas visuales, con o sin poses de cámara conocidas.
El objetivo es actualizar ese nodo para que adopte el backend de buffers CUDA y aproveche la mejora de rendimiento que ofrece rosidl::Buffer. Sirve como ejemplo de migración justamente porque su algoritmo ya está acelerado por GPU.
La devolución de llamada del nodo convierte la imagen ROS entrante a una vista de OpenCV, corre la inferencia de profundidad métrica monocular con TensorRT, convierte el cv::Mat resultante de vuelta a una imagen ROS y la publica como imagen de profundidad en punto flotante.
El código es directo. El problema es que un límite ROS respaldado en CPU rodea a un algoritmo nativo de GPU. Ese límite es apropiado cuando el productor o el consumidor viven en la CPU, y deja de serlo cuando los nodos de los dos lados ya pueden producir y consumir memoria CUDA. En ese caso, las dos transferencias al anfitrión del tamaño de la carga, la reserva en el anfitrión y el trabajo de serialización pasan a ser una oportunidad de optimización en la interfaz.
La meta, entonces, no es rediseñar el modelo ni reemplazar sus mensajes estándar. Es preservar el contrato ROS existente y permitir que el campo de salida Image.data lleve almacenamiento de un backend apropiado.
¿Qué hace la habilidad del agente?
Un agente de programación calza bien con el trabajo investigativo. Seguir cargas a través de devoluciones de llamada y bibliotecas auxiliares, encontrar los límites entre anfitrión y dispositivo, preservar el contrato del nodo y coordinar los cambios de fuente, de dependencias, de lanzamiento y de pruebas.
La habilidad migrate-node-to-rosidl-buffer convierte ese análisis en un flujo repetible. En vez de reemplazar el nodo con una plantilla o reescribir el código de forma automática, dirige al agente para que haga siete cosas.
- Registrar la revisión de partida, el entorno ROS de destino y los cambios locales existentes
- Confirmar la compatibilidad del tipo de campo del mensaje generado y agregar como dependencias los paquetes del backend de buffers CUDA
- Rastrear cada campo del mensaje desde que se recibe hasta que se publica, incluidas las llamadas CUDA transitivas, los pasos de memoria, los flujos, las salidas opcionales y la propiedad
- Correr la auditoría de solo lectura sobre los límites de copia e inspeccionar cada resultado en su contexto
- Armar un plan de migración por campo que identifique las copias que se eliminan, las promociones o materializaciones necesarias y los caminos que deben quedar intactos
- Implementar el parche más pequeño que preserve la interfaz
- Verificar por separado la semántica, la negociación de backend, el transporte entre procesos, el tiempo de vida del buffer y el comportamiento real de las copias de memoria
Refactorizar el nodo con rosidl::Buffer
Con la habilidad de migración, el agente actualiza las dependencias y las interfaces del nodo para adoptar el backend de buffers CUDA. La mayoría de los cambios adapta el envoltorio de TensorRT para que acepte manejadores de buffer CUDA en los datos de entrada y de salida, conservando su API existente. El cambio en el transporte ROS es chico. Una opción de suscripción, una reserva CUDA, dos extracciones de manejador conscientes del flujo y una publicación. No hace falta un mensaje propio, ni un tópico CUDA duplicado, ni una rama separada de publicador para CPU y para CUDA.
Agregar las dependencias del backend
La habilidad ayuda primero a sumar los paquetes del backend de buffers CUDA, cuda_buffer y cuda_buffer_backend, como dependencias adicionales. La definición del mensaje no cambia y el nodo sigue usando sensor_msgs/msg/Image.
Aceptar mensajes CUDA en la suscripción
Después se actualiza el suscriptor para que acepte mensajes con buffers respaldados en CUDA. La CPU sigue siendo un respaldo aceptable por omisión, así que la devolución de llamada a nivel de nodo no necesita implementaciones separadas para CPU y para CUDA.
rclcpp::SubscriptionOptions options;
options.acceptable_buffer_backends = "cuda";

sub_image_.subscribe(
  this, image_base_topic, image_transport,
  rclcpp::SensorDataQoS().get_rmw_qos_profile(), options);
La topología existente de image_transport y message_filters se mantiene en su lugar. Las opciones de suscripción simplemente se reenvían a través de ella.
Escribir directo en la memoria del mensaje
La devolución de llamada del suscriptor sigue aceptando bgr8, preserva la cabecera, las dimensiones, la codificación y el paso en bytes, y convierte con cv_bridge solo cuando la codificación de entrada lo exige. Con la actualización, la inferencia de TensorRT escribe sus resultados directamente en el buffer CUDA reservado en el mensaje de salida, listo para publicarse apenas se encola el trabajo en la GPU.
auto depth_msg = std::make_unique<sensor_msgs::msg::Image>();
depth_msg->header = bgr_image_msg->header;
depth_msg->height = bgr_image_msg->height;
depth_msg->width = bgr_image_msg->width;
depth_msg->encoding = sensor_msgs::image_encodings::TYPE_32FC1;
depth_msg->is_bigendian = false;
depth_msg->step = depth_msg->width * sizeof(float);

depth_msg->data = cuda_buffer_backend::allocate_buffer(
  static_cast<size_t>(depth_msg->step) * depth_msg->height);

const cudaStream_t stream = tensorrt_depth_anything_->getCudaStream();
{
  auto input = cuda_buffer_backend::from_input_buffer(
    bgr_image_msg->data, stream);
  auto output = cuda_buffer_backend::from_output_buffer(
    depth_msg->data, stream);

  tensorrt_depth_anything_->doInferenceCuda(
    input.get_ptr(), bgr_image_msg->width, bgr_image_msg->height,
    bgr_image_msg->step, *camera_info_msg,
    reinterpret_cast<float *>(output.get_ptr()),
    node_param_.point_cloud_downsample_factor,
    node_param_.colorize_point_cloud,
    node_param_.publish_point_cloud,
    node_param_.enable_debug);
}  // Libera los manejadores rastreados por evento CUDA antes de publicar.

pub_depth_image_->publish(std::move(depth_msg));
Cada línea cumple un propósito acotado.
allocate_buffer()le da al campo estándarImage.dataun almacenamiento respaldado por buffer CUDA.from_input_buffer()entrega un manejador de buffer CUDA seguro de consumir en el flujo de TensorRT para operaciones de solo lectura. La entrada CUDA se usa directo y la entrada por CPU se promueve a CUDA cuando hace falta.from_output_buffer()entrega un manejador seguro para operaciones de escritura. El posprocesado CUDA existente escribe su resultado final en32FC1directamente en el buffer asignado al mensaje saliente, lo que evita tanto una copia de dispositivo a anfitrión como una salida intermedia de dispositivo a dispositivo.- El ámbito interno libera el manejador de escritura después de encolar el trabajo en el flujo asociado, para registrar un evento CUDA de escritura antes de publicar el mensaje y garantizar el orden de las operaciones.
- El nodo llama a
publish()como siempre, con el mismo tipo de mensaje, mientras el campo de datos subyacente queda respaldado por el backend CUDA. La compartición de memoria CUDA y la compatibilidad con los suscriptores aguas abajo las resuelven de forma automática el middleware de ROS 2 y los backends.
Dejar aparte el trabajo opcional en CPU
La habilidad deja intacta la ruta que no pasa por CUDA. La construcción de la nube de puntos y la visualización de depuración son consumidores locales de CPU en el nodo original. Cuando están activados, pueden seguir requiriendo una copia de dispositivo a anfitrión y una sincronización. No determinan la representación que se entrega en el tópico de profundidad, así que la migración los deja como límites opcionales explícitos en vez de complicar el camino de publicación optimizado.
¿Dónde corre el nodo migrado?
La función rosidl::Buffer se introdujo en ROS 2 Lyrical, así que NVIDIA espera que el nodo migrado funcione con Lyrical y versiones superiores, sobre las implementaciones RMW soportadas rmw_fastrtps_cpp y rmw_zenoh_cpp.