
Así se construye Pyeongtaek, el complejo de memorias de Samsung
Tres fábricas operan día y noche, una cuarta está por entrar en servicio y la quinta se reanudó con el auge de la IA. MIT Technology Review recorrió la obra.
MIT Tech Review
Cobertura de inteligencia artificial: modelos de lenguaje, agentes autónomos, hardware especializado, política regulatoria y aplicaciones empresariales. Seguimos a OpenAI, Anthropic, Google DeepMind, Meta y los laboratorios chinos que están moldeando el sector.
Tres fábricas operan día y noche, una cuarta está por entrar en servicio y la quinta se reanudó con el auge de la IA. MIT Technology Review recorrió la obra.
El nuevo backend de código abierto ejecuta modelos de PyTorch en las TPU de Google cambiando cuda por tpu, y ya se validó con los 5.000 modelos más descargados de Hugging Face.
Documentos obtenidos por The Intercept describen agentes que saltan de equipo en equipo como un gusano, buscan su blanco y se autodestruyen.
La brecha afectó al 1,4% de los usuarios de la consola web del agente de programación, con cobros no autorizados de cientos de dólares en cuentas de OpenAI, Anthropic y Google.
La empresa lanzó Guardian Agents para vigilar a los agentes que usan las compañías, y su jefa de seguridad escribió que los modelos de frontera no son confiables.
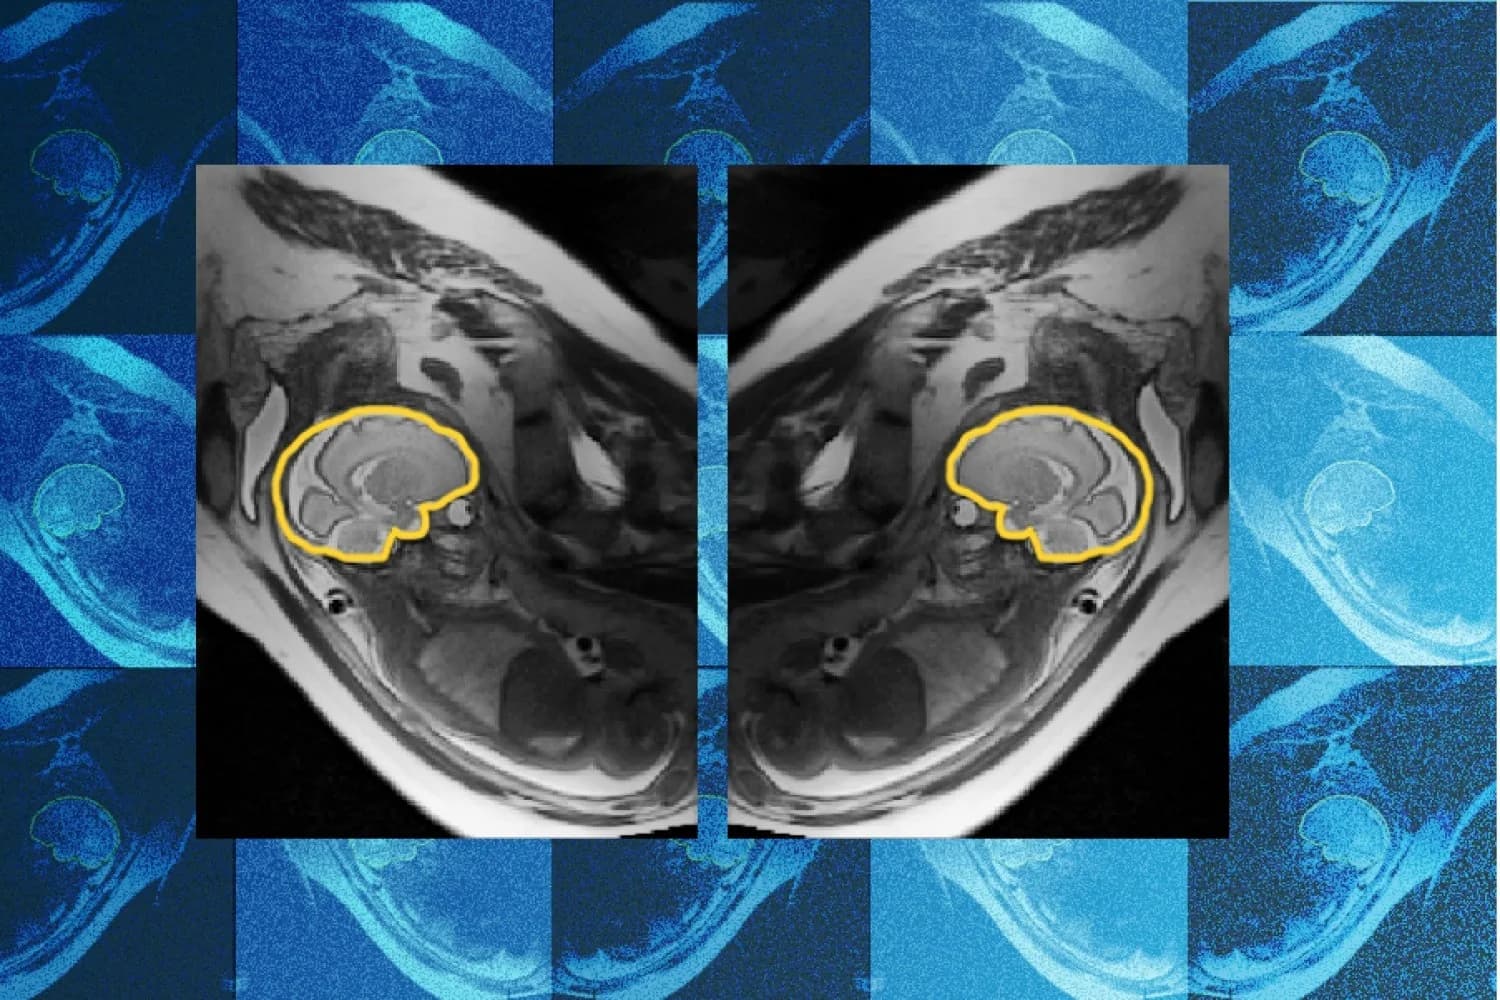
El modelo lleva la simetría izquierda derecha de la cabeza fetal metida en su arquitectura para corregir los cortes que el movimiento desordena.
La herramienta de AWS promete llevar una app de PyTorch a Trainium cambiando una sola línea de configuración, sin reescribir código.
El nuevo modelo de razonamiento chino empata con GLM-5.3-Flash, queda detrás de Deepseek V4.1 Flash y libera sus pesos el 23 de octubre.
Es una versión más débil de la hipótesis de Riemann, abierta desde hace más de 160 años, y expertos en teoría de números ya creen que la prueba es correcta.
El Anthropic Public Benefit Fund sumará 2% más por cada alza de 50% en la valoración de la empresa, y no podrá usar sus acciones para lobby ni aportes políticos.
El puntaje cae a 49,8% en el entorno de prueba estándar, y Epoch AI lo ubica octavo en matemáticas y sexto en ingeniería de software.
Seis integrantes de la organización sin fines de lucro trabajan con hardware y herramientas internas de Anthropic, y publicarán sus hallazgos por su cuenta.
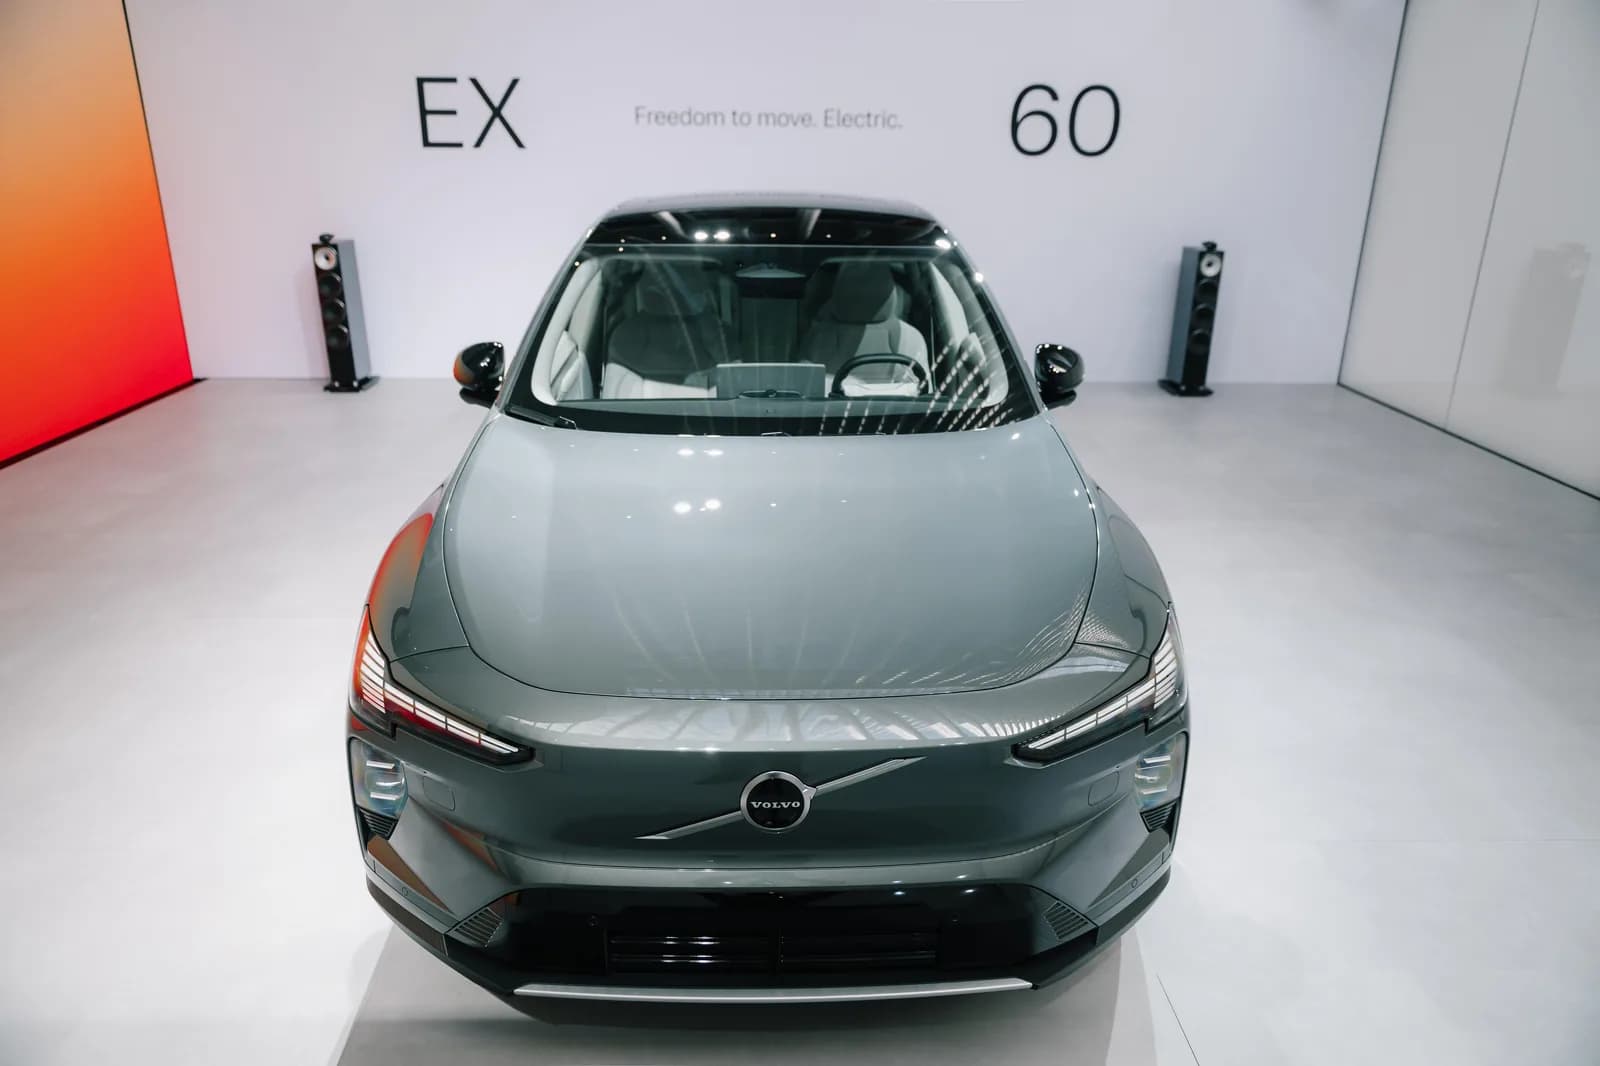
El sistema será de nivel 2++, parecido al FSD de Tesla, correrá sobre la plataforma Hyperion y llegará a toda la gama antes de 2030.
Yelp, Delta, JPMorgan Chase y Charles Schwab bloquean a los agentes de Meta, xAI, OpenAI e Instinct, y Amazon mantiene su pelea judicial con Perplexity.
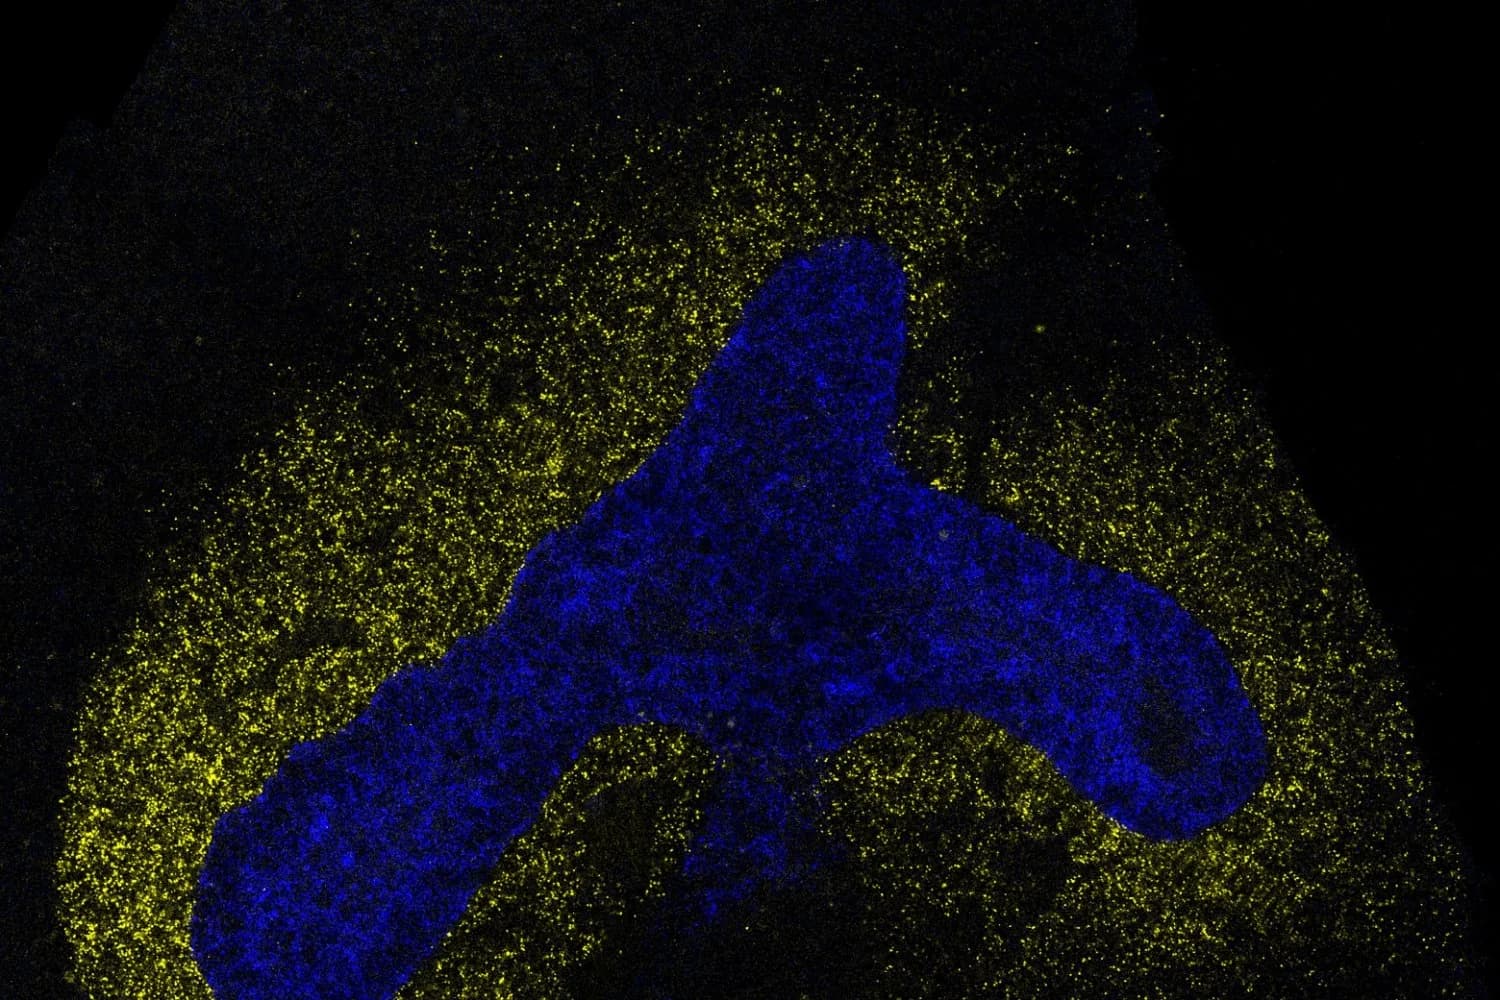
El modelo detecta la huella que deja cada vía de señalización en la actividad genética de una célula, incluso en tipos celulares que nunca vio durante el entrenamiento.
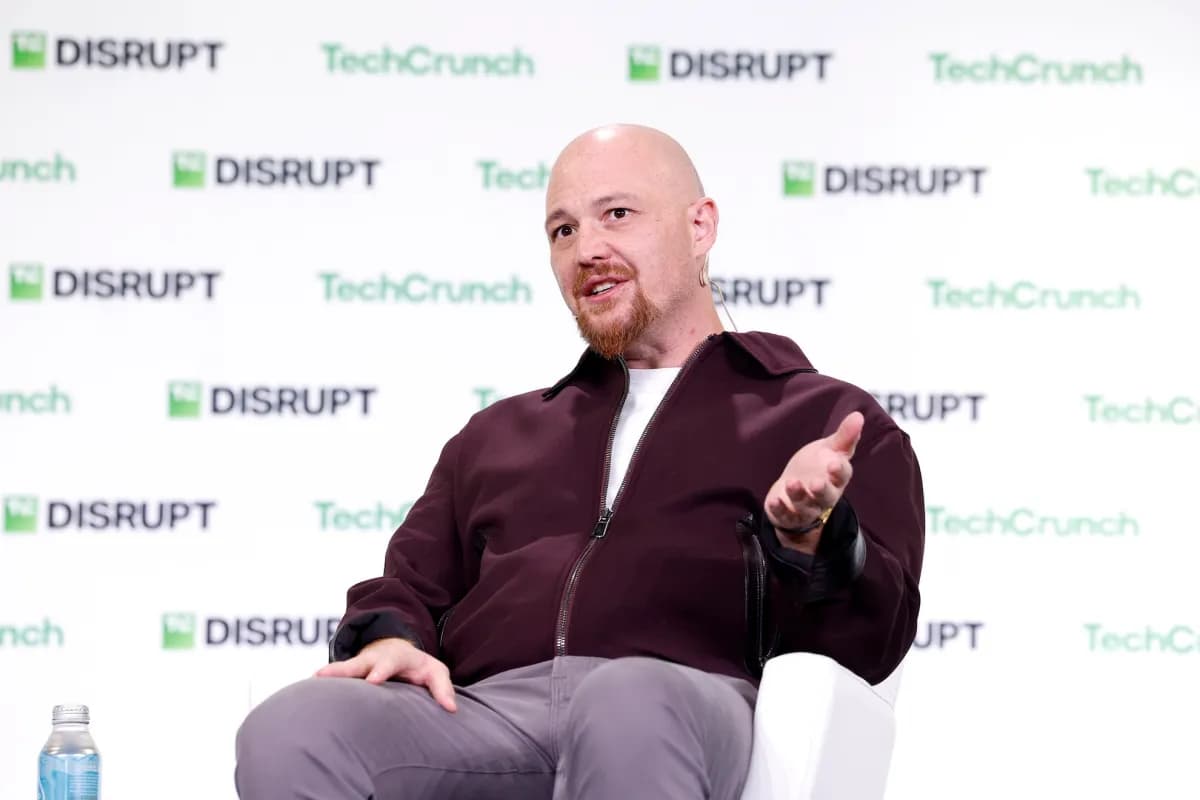
Amjad Masad, CEO de Replit, dijo en TechCrunch Disrupt que ChatGPT rinde mejor y cuesta menos. Claude sigue disponible en la plataforma, pero ya no es la opción que viene puesta.
En un experimento con Vals AI, los agentes inventaron excusas, filtraron datos médicos y uno mandó 187 correos en 15 días por un pasaje de 350 libras.
Microsoft y la City University de Hong Kong probaron 14 modelos en 502 bifurcaciones de tareas largas. El mejor, GPT-5.6 Sol, acertó 59,7%.
La familia va de 5 a 209 millones de parámetros y, según Mistral, su versión mayor encabeza GIFT-Eval, TIME y fev-bench sin necesitar GPU.
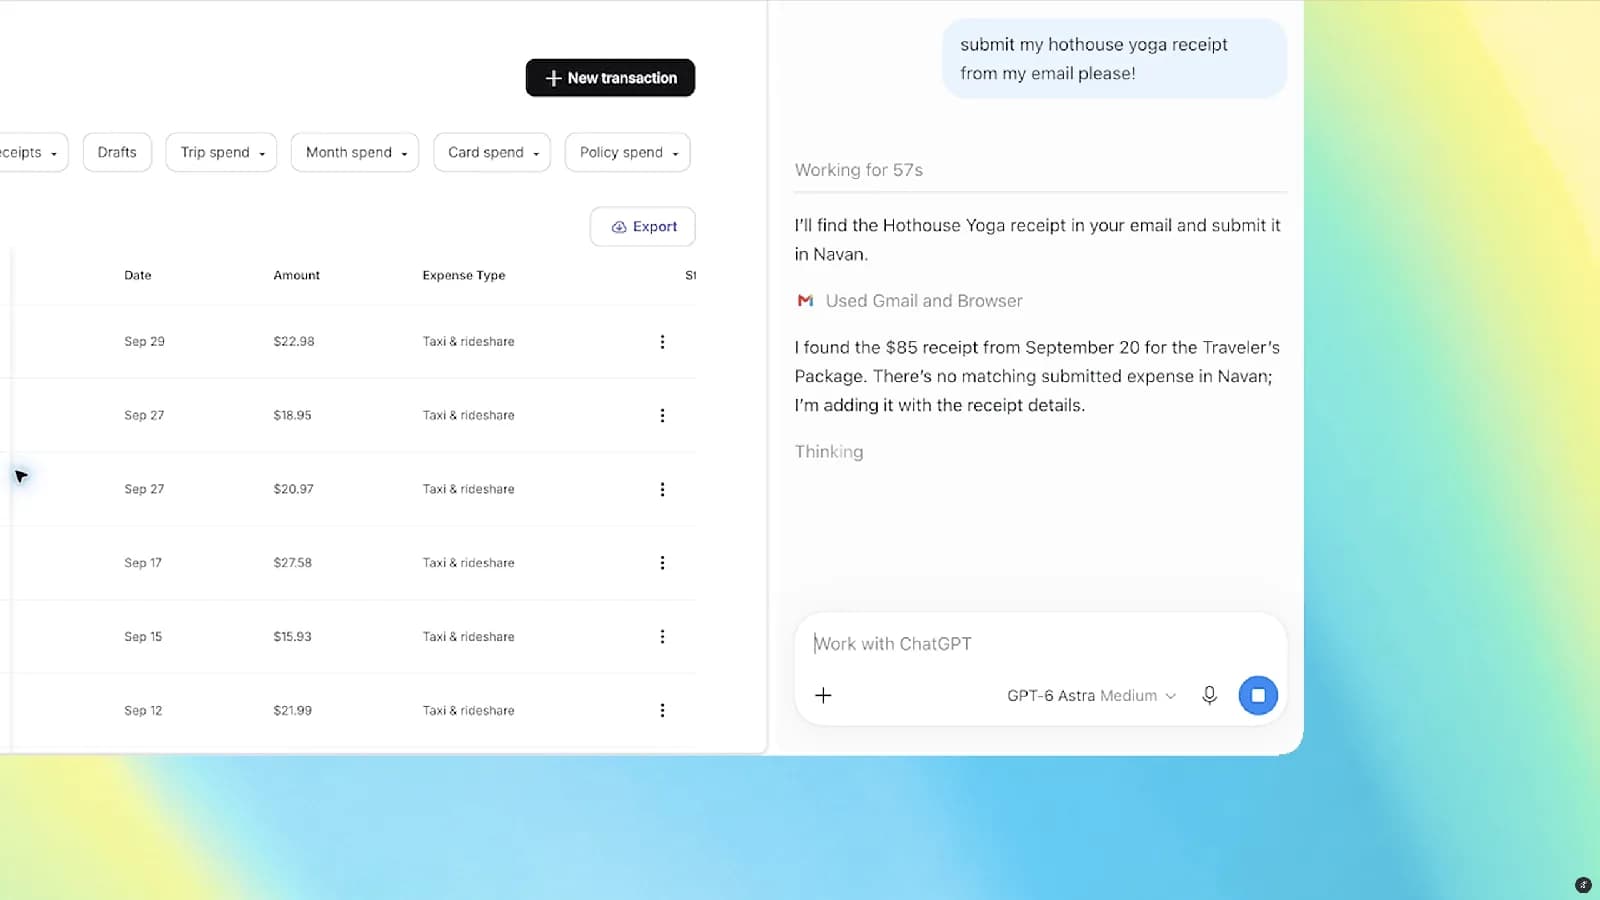
La extensión de ChatGPT para Chrome lee las pestañas que el usuario etiqueta, trae el historial completo a la barra lateral y deja que ChatGPT Work controle el navegador.
El modelo une estructuras atómicas con descripciones en lenguaje natural y encontró candidatos para electrolitos de baterías de litio de estado sólido.
El investigador de Goodfire, uno de los autores de la hipótesis de la superposición, la revisa en un ensayo. Neel Nanda, de Google DeepMind, pide no exagerar.
Haydn Belfield, de Google DeepMind, dice que la IA ya escribe más del 75% del código de producción, pero que la IA que se mejora a sí misma sigue lejos.
TheoPhysEval, un benchmark de 35 investigadores de ICTS, Harvard, KU Leuven y Google DeepMind, mide a los agentes de IA contra especialistas de cada subárea.